新しい構築されたインベントリー機能
以前にこちらのブログ記事で、Ansible で作成されたプラグインをベースとする、インベントリーのよりスマートな新しい処理方法に関するアイデアを紹介しました。Ansible Automation Platform 2.4 では、このアイデアが完全にサポートされる機能として導入されました。このブログ記事では、その機能について詳しくご紹介します。
構築されたインベントリーは既存のスマートインベントリー機能の後継で、Ansible Automation Platform コントローラーでインベントリーを作成する際の選択肢に新しく追加されています。「通常」のインベントリーのリストを入力として取得し、ユーザー定義の操作を実行してフィルタリングして、入力インベントリーのコンテンツを含むインベントリーを結果として生成します。
構築されたインベントリーとは
この機能は、複数のインベントリーのホストに対してジョブを実行できるようにするという点で、既存のスマートインベントリーと似ています。
ただし、構築されたインベントリーには、hostvars と groupvars の両方を定義して使用できる組み込み機能などの新しい機能が導入されています。
- グループは構築されたインベントリーに存在し、その構成において重要な役割を果たします。
- ユーザー定義ロジック (グループ、変数、選択対象のホストを追加するのに使用) は ansible-inventory を介してコントローラーによって実行されます。また、インベントリーの更新によって UI に表示されます。
- ユーザー定義ロジックの形式は、Ansible で広く使用されているスタイルの jinja2 です。
指針となる原則として、構築されたインベントリーを作成する場合は、Playbook を記述する場合と同じように考えるとよいでしょう。これは、アプリケーションが認識するのと同じ方法でインベントリーについて考える必要があるスマートインベントリーとは対照的です。
UI での構築されたインベントリー
[Inventories] の下にある [Add customized inventory] をクリックすると、次のメニューが表示されます。
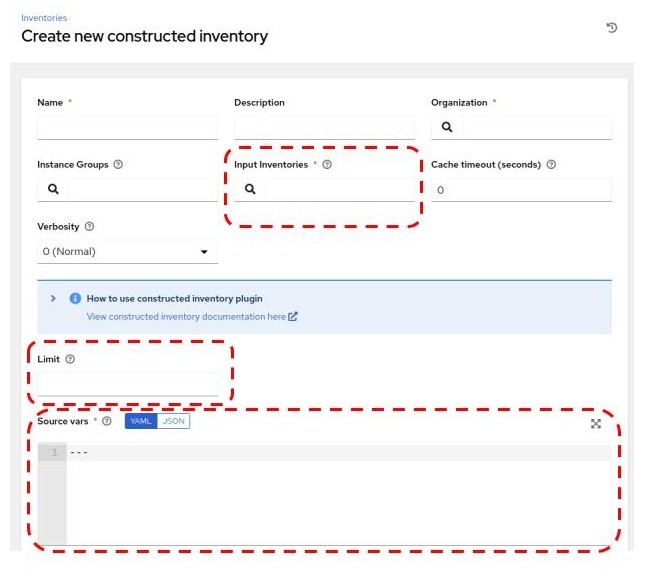
構築されたインベントリーに固有の 3 つの主要項目があります。
- Input Inventories:構築されたインベントリーがインベントリーのコンテンツ (ホスト、グループなど) を取得するソースとなる既存のインベントリーをここで指定します。
- Limit:ansible-inventory に直接渡されます。Ansible ホストパターンの標準構文を使用してホストをフィルタリングできます。
- Source vars:ansible.builtin.constructed インベントリープラグインへの入力です。
注:入力インベントリーは順序付けられているため、ホスト名と変数が競合する場合、最後のインベントリーの変数が優先されます。変数はマージされるため、それより前の入力インベントリーの変数も設定解除されることはありません。ホスト名に競合がない場合は問題ないため、ここで使用する例では順序付けについて説明します。
これらについては、以下の例で説明するため、今は気にする必要はありません。
最も単純な形式の構築されたインベントリー
入力インベントリーは少なくとも 1 つ指定する必要がありますが、他のフィールドの入力は必須ではありません。たとえば、2 つ以上の入力インベントリーを指定し、Limit と Source vars を空白のままにすることが理にかなっていることがあります。その場合、指定したすべての入力インベントリーから得たインベントリーコンテンツの組み合わせを対象とするジョブを実行できます。
構築されたインベントリーのより高度なユースケース
最終的にこの機能の能力を発揮する Limit と Source vars の働きを説明するには、具体的な例を使うとわかりやすいでしょう。
構築されたインベントリーの設定
同じクラウドプロバイダーから提供されている 2 つのインベントリーがあるとします。ただし、カバーするリージョンが違うため、収録されているホストは異なります。アカウント、機能、場所がそれぞれ異なるため、これらのインベントリーは別々に分けられています。この例では、単純な East/West リージョン入力インベントリーを想定します。
インベントリーは、Git に格納された .ini ファイルをソースとします。これらのファイルは DevOps タイプのプラクティスを使用して config-as-code アプローチを使用して管理されます。
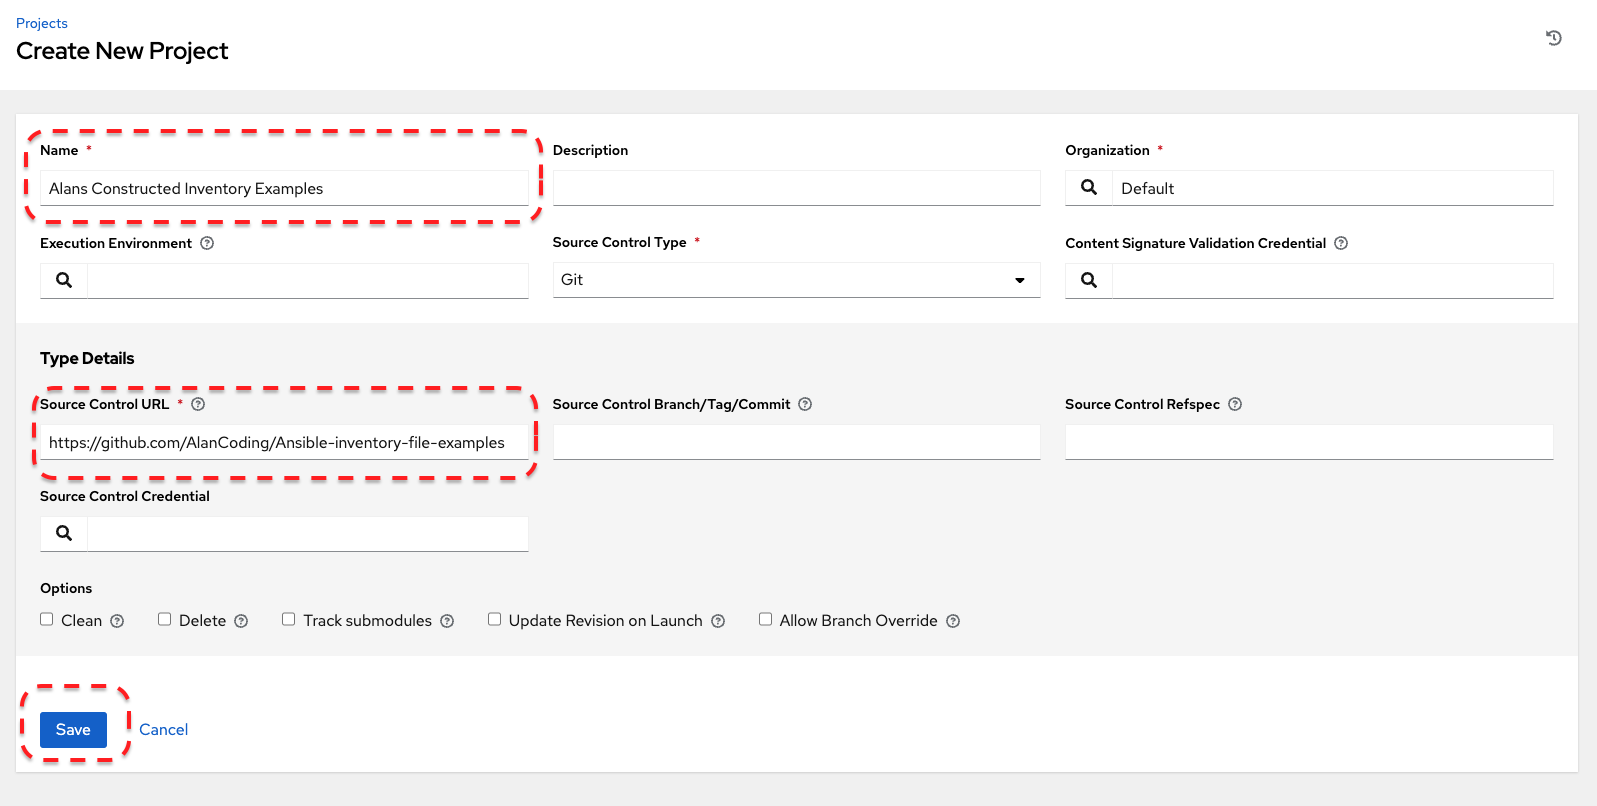
まず、新しいプロジェクトを設定し、インベントリー情報をどこから取得するかがわかるように同期します。UI で [Projects] を選択し、[Add] をクリックします。
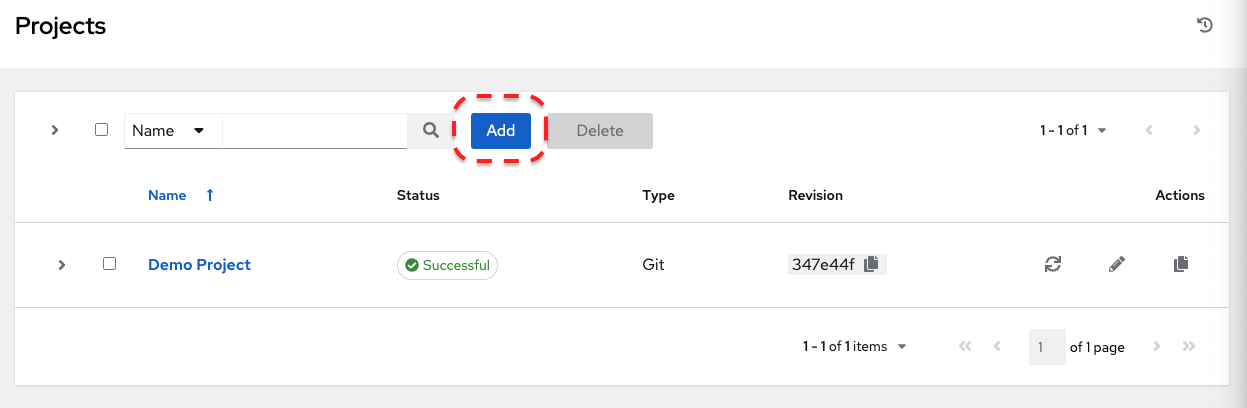
入力して保存すると、プロジェクトは自動的に同期されます。
次に、プロジェクトファイルの情報を参照する新しいインベントリーを作成します。[Inventories] で [Create] をクリックします。

次に、インベントリーの [Sources] で [Add] をクリックします。

このソースの名前を [Name] で指定します。この場合は East Region ホスト用に、[Source] で「Sourced from a Project」を選択し、先ほど追加したプロジェクトと適切な east.ini ソースファイルを指定します。
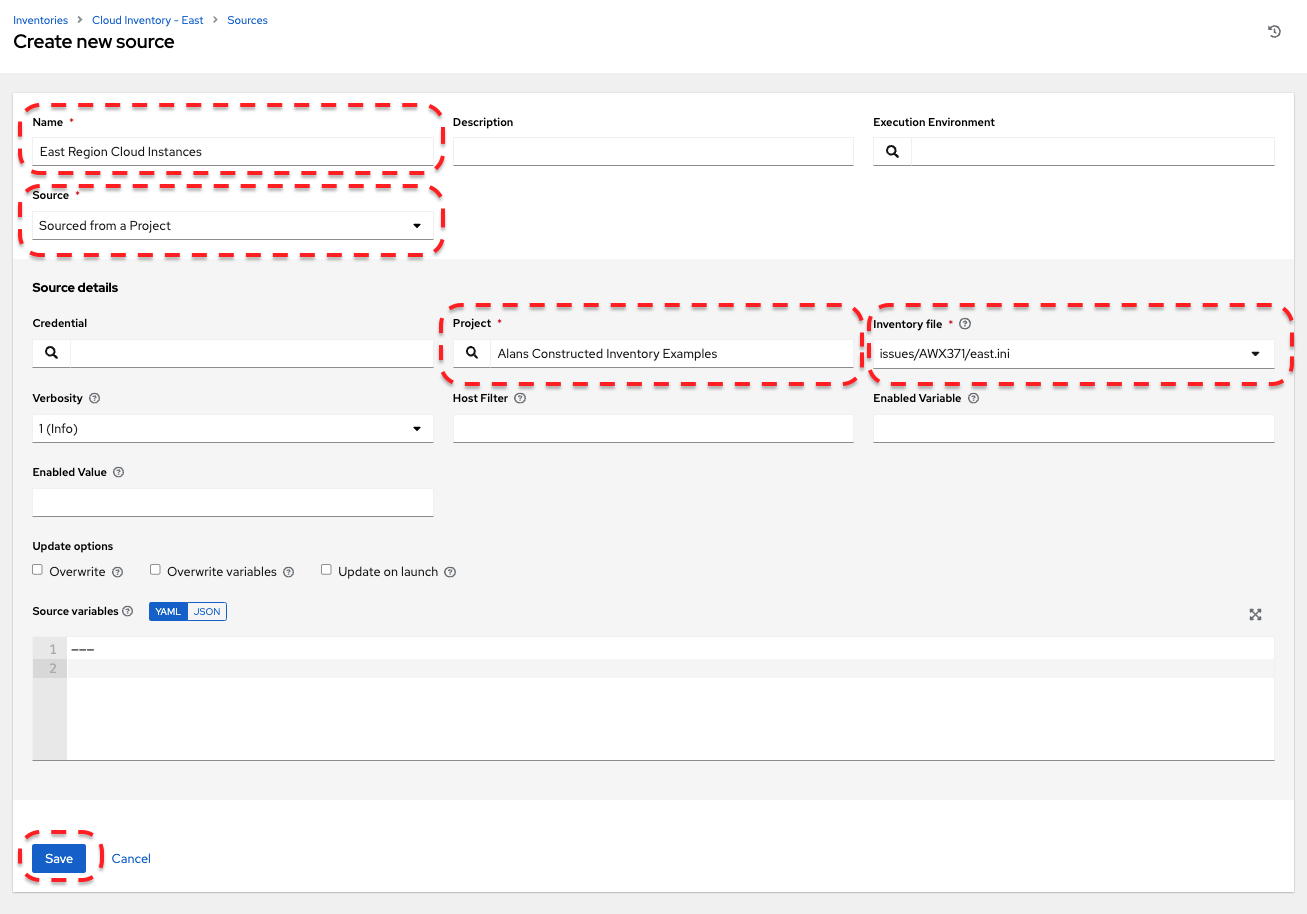
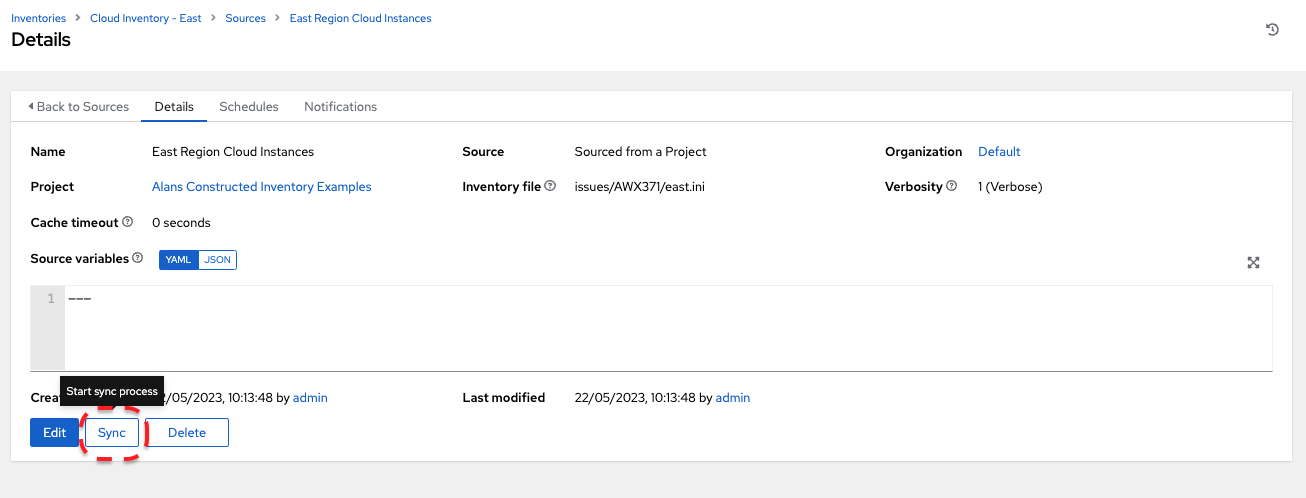
保存したら、[Sync] ボタンをクリックして情報を取得します。
同期が完了すると、ジョブの出力を表示して、何が処理されたかを確認できるようになります。
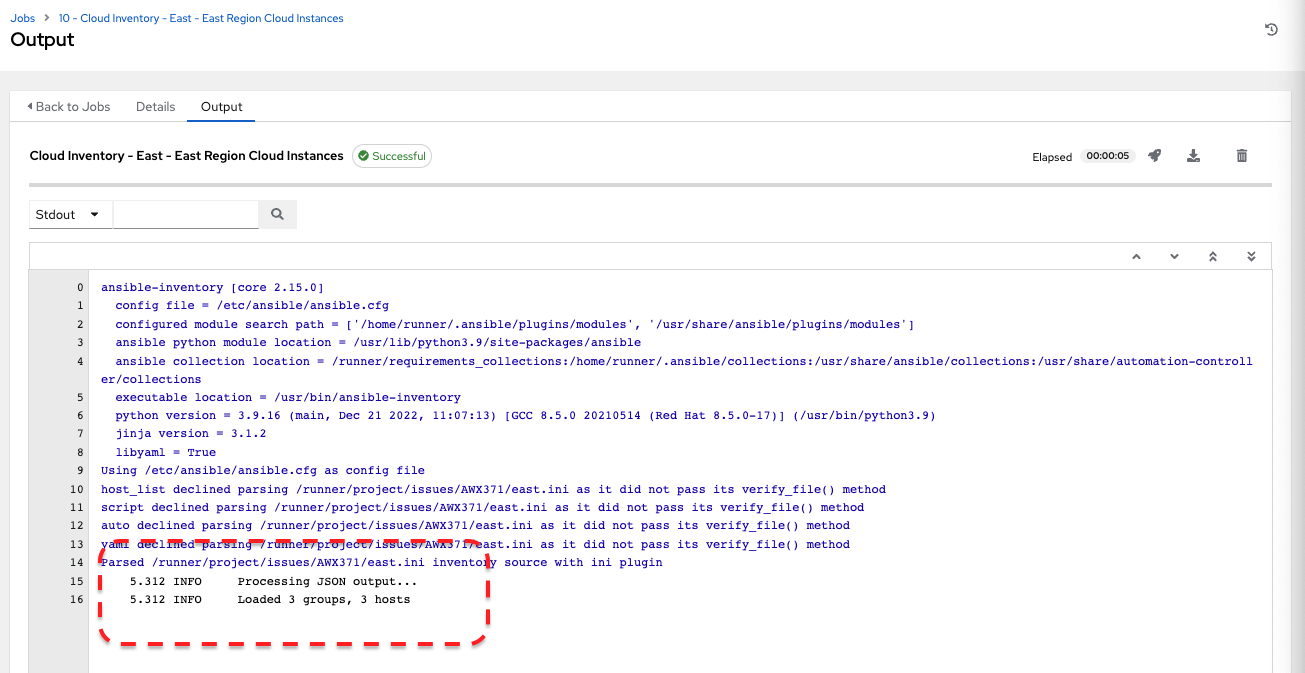
この例では、検出されて 3 つのホストと 3 つのグループが自動的に追加されたことがわかります。この情報は UI の [Hosts] で確認できます。
次に、West Region に対して同じことを行う必要があります。これは皆さんの演習とします。上記の例に従って、ソースとして west.ini を使用してください。
このシナリオ例では、定義した基準に基づいて、East と West のリージョンにある一部のホストに対してジョブを同時に実行したいと考えています。
そこで、UI で新しい構築されたインベントリーを作成しましょう。
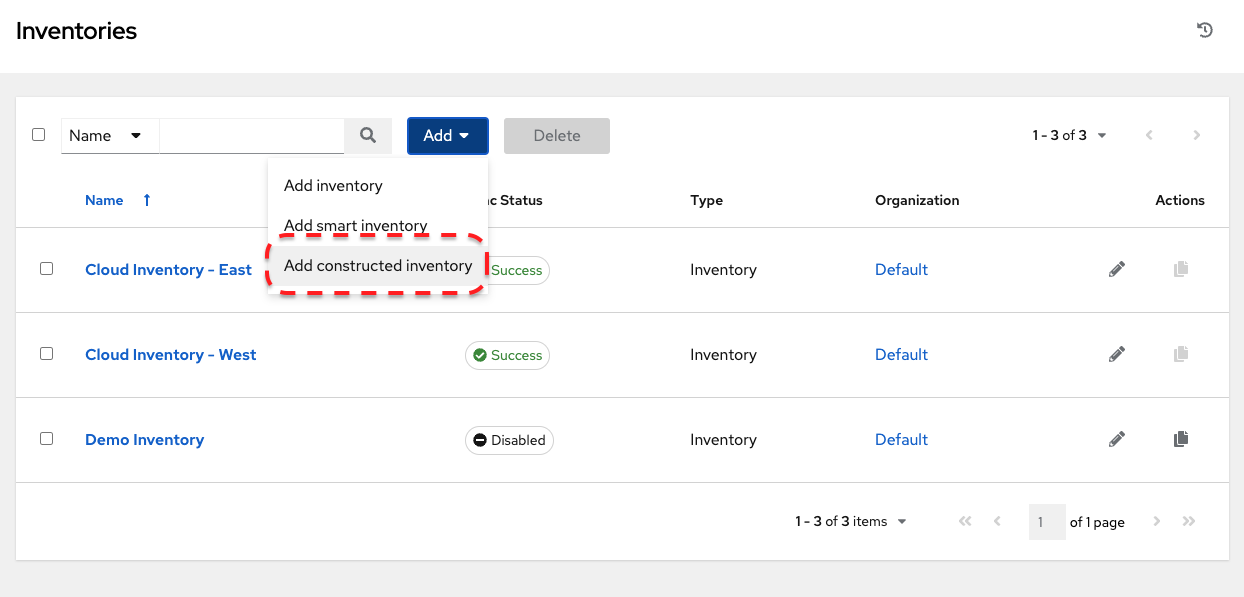
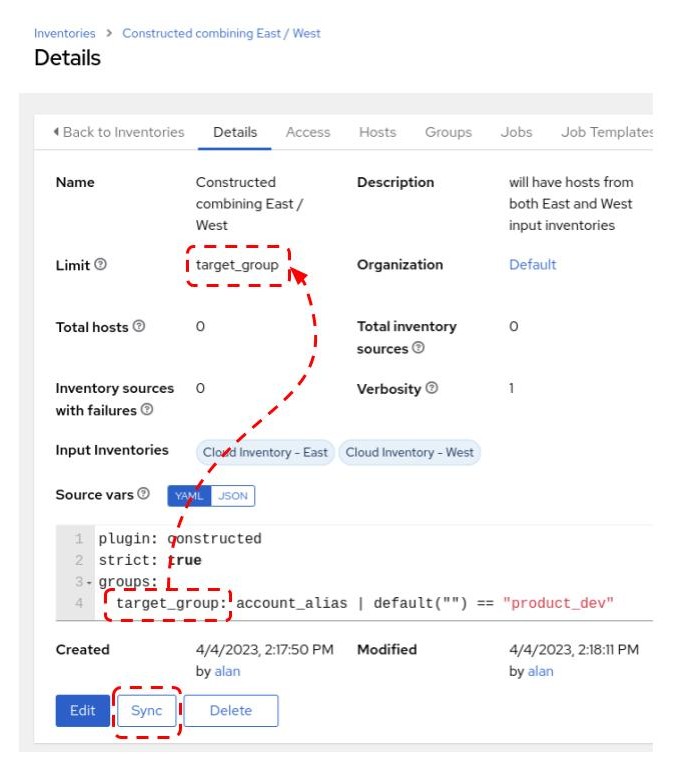
両方のクラウドインベントリーを入力として追加します。次に、source-vars を使用して「target_group」という新しいグループを構築し、Limit を使用してそのグループにフィルタを適用します。
同期が完了したら、ジョブ出力を見れば何が起きたかを確認できます。
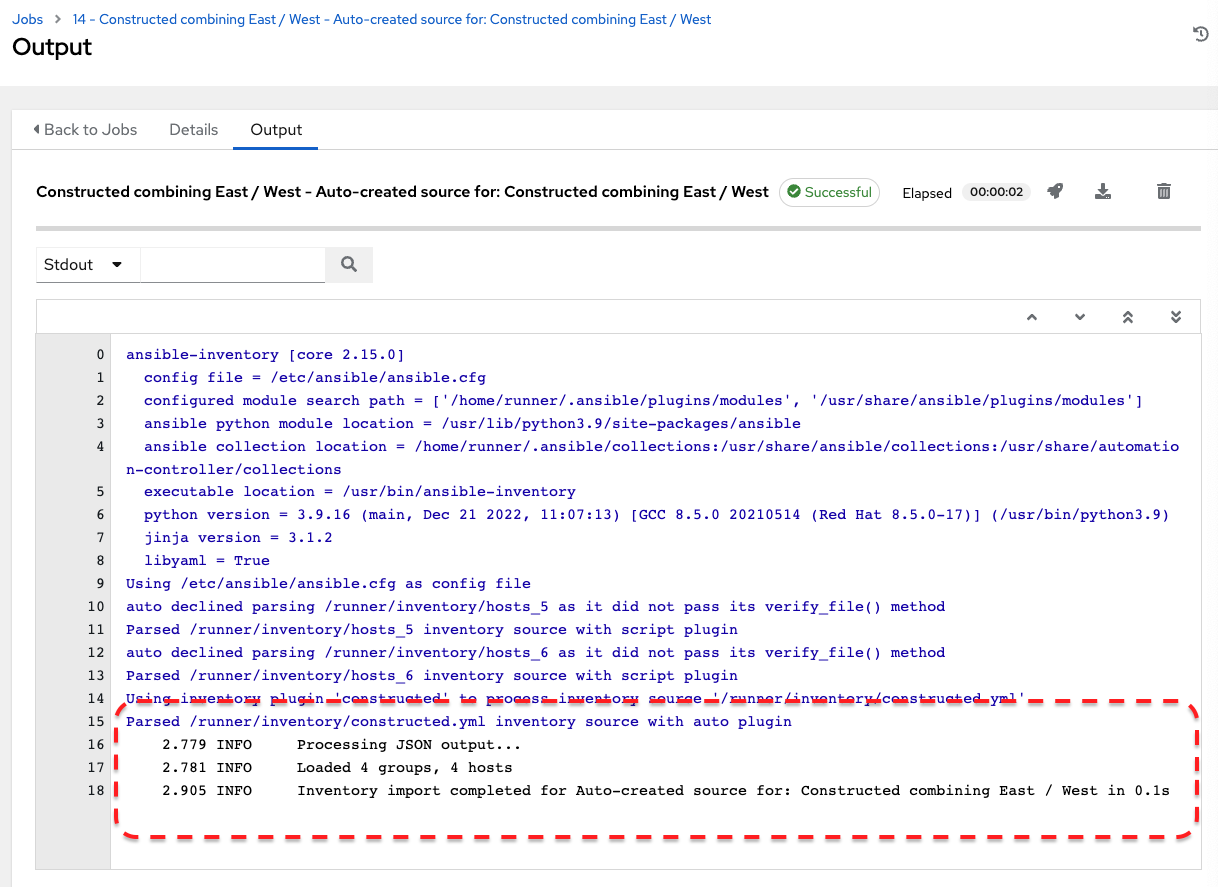
これで 4 つのグループと 4 つのホストが得られました。UI の [Hosts] と [Groups] を参照して、結果を確認できます。この例では、グループは次のようになっています。
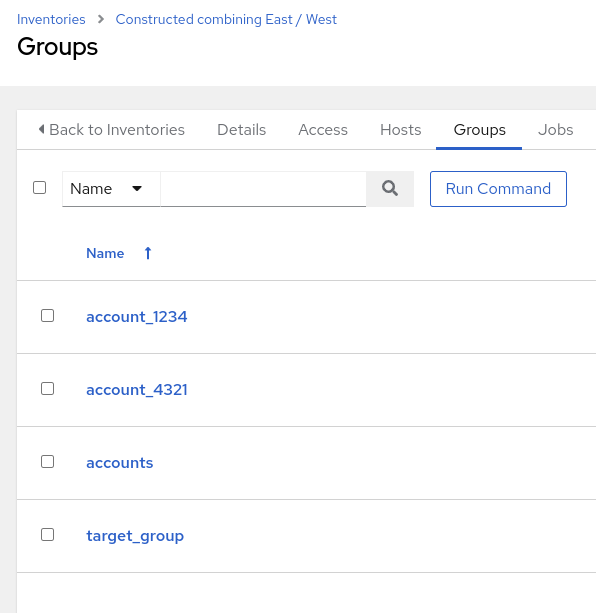
構築されたインベントリーの更新が実行された際に、「account_1234」、「account_4321」、および「accounts」グループが入力インベントリーから構築されたインベントリーにコピーされました。
構築されたインベントリーには「target_group」グループも含まれていますが、これについては後ほど説明します。
ジョブテンプレートがこの構築されたインベントリーを使用してジョブを実行する際には、定義されたすべてのグループがジョブで使用可能です。
ここからが本題になりますが、構築されたインベントリーフォームで source-vars を参照すると、新しい「target_group」グループの定義が見つかります。
    plugin: constructed
    strict: true
    groups:
target_group: account_alias | default("") == "product_dev"「target_group」は、元の East および West インベントリーにはありませんでした。このグループは、更新が行われたときに、構築されたインベントリープラグインによって作成されました。
この例では、ホストが jinja2 テンプレート {{ account_alias | default("") == "product_dev" }} で真の値 (1、"1"、True など) に解決されると、グループに追加されます。
更新の実行時に、これらのテンプレートは Ansible によって入力インベントリー内のすべてのホストについてレンダリングされ、これらの評価を行います。大規模な入力インベントリーの場合、更新が完了するまでに分単位の時間がかかることが予想されます。
構築されたインベントリーは、これを使用するテンプレートのジョブ実行前に自動的に更新されます。しかし、これらの更新に時間がかかりすぎる場合は、UI の [Constructed Inventory] 設定の [Update cache timeout] オプションで更新の頻度を低くできます。このオプションの値を 1 より大きな値に設定すると、構築されたインベントリーの更新結果がその秒数の間キャッシュされます。>
「target_group」を作成する jinja2 テンプレートは、ホストを検査したときに、「account_alias」の hostvar が存在し、かつ「product_dev」と等しい場合、そのホストを含めます。
「| default」構文は、一部のホストでその変数が定義されていない場合に対応するためのものです。
「strict: true」により、未定義の変数を参照するとインベントリーの更新が失敗することが規定されているので、「| default」が必要になります。
未定義のケースが発生した場合に強制的にそれが明確になるよう、「| default」と strict パラメーターを使用するのがベストプラクティスです。
グループの構築は、Playbook で参照されるグループをその場で追加するのに便利です。なぜそうするのがよいのでしょうか。それは、hostvars からグループを作成すると便利な場合があるからです。たとえばホストパターンでの使用 (この例では Limit を使用) など、hostvars ではできないことをグループでは実行できます。
構築されたインベントリーに生成されたすべてのホストを見てみましょう。
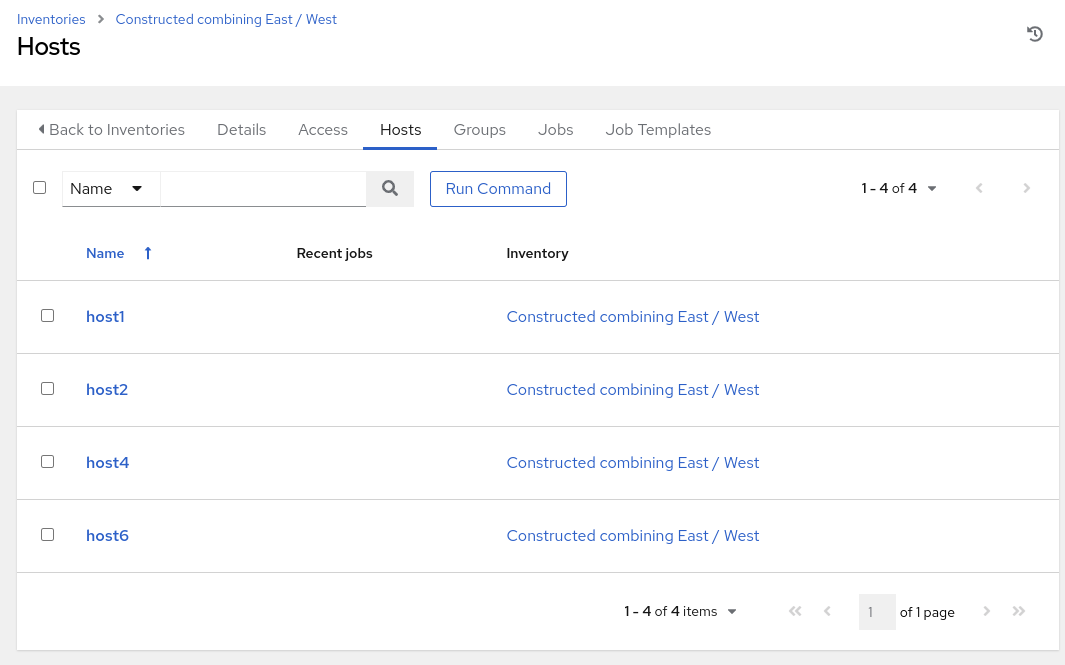
この例では、east インベントリーの host3 と west インベントリーの host5 は含まれていないことがわかります。これは、入力インベントリーではこれらが別のアカウント (account_4321) にあり、そのアカウントの「account_alias」はこの例で指定した「product_dev」の値と一致しないからです。account_4321 のグループは構築されたインベントリーにインポートされていますが、このグループには要件に合致するホストがないので、構築されたインベントリーではインポートしたグループが空になっています。
Source vars の入力には、グループの追加に加えて、host 変数を含めることができます。
Alan の Github リポジトリには、別の例も含まれています。こちらも役に立つでしょう。construct.yml では、ホストの「状態」を解決し、ホストがシャットダウンされているか特定の環境 (dev) の一部であるかに基づいて、いくつかのグループに割り当てます。この .yml ファイルの信頼できる情報源は、Ansible Automation Platform の外部にある他のシステムから得ることができ、このファイルを使用して、ホストのサブセットに対してその場で自動化を実行できます。
デバッグのヒント
前述の例を使用すると、構築されたインベントリーを作成するときには、limit 値を削除して source-vars を次の内容に変更することを検討します。
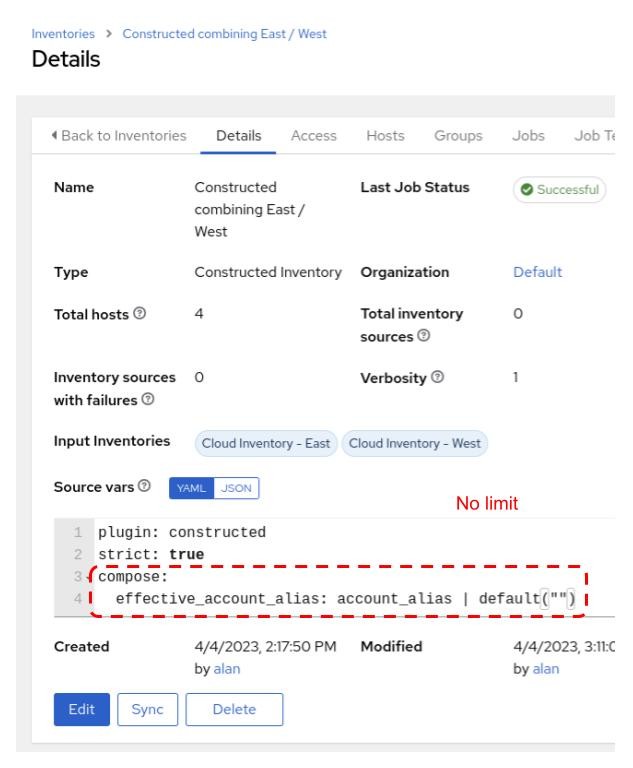
これは、{{ account_alias | default(“”) }} という類似のテンプレートを実行し、effective_account_alias という名前の変数に保存します。limit を空白にすることで、入力インベントリーからすべてのホストを取得できるようにします。これにより、個々のホストの包含基準の詳細を調べることができます。以下では host3 についての例を示します。
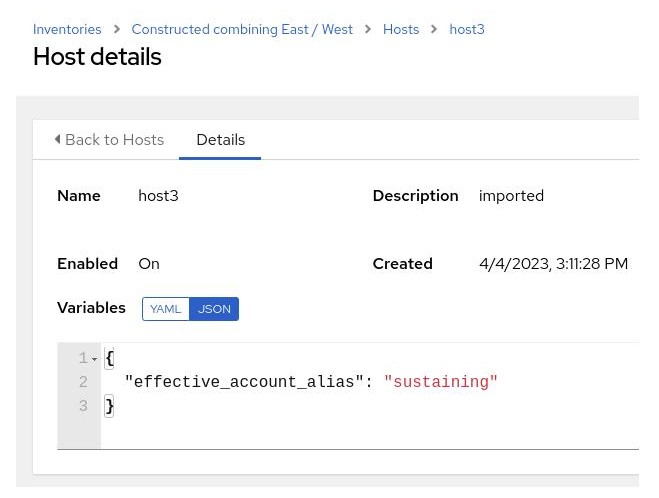
ここでは、hostvar の effective_account_alias の評価値が 「sustaining」であり、「product_dev」ではないことがわかります。
構築されたインベントリープラグインには、他にも極めて便利で強力な多数のオプションがあります。詳細については、https://docs.ansible.com/ansible/latest/collections/ansible/builtin/constructed_inventory.html にあるプラグインのドキュメントを参照してください。
https://docs.ansible.com/automation-controller/4.4/html/userguide/inventories.html#ug-inventories-constructed にあるユーザーガイドでは、その他のいくつかの例も確認できます。
まとめ
構築されたインベントリーを Ansible Automation Platform で使用する方法について、実践的に概要を紹介しました。
ホストパターンや構築されたインベントリープラグインなどの基本概念は Ansible の一般的な概念であるため、ユーザーは任意の複雑な条件に基づいて、グループや変数を追加したり、ホストを含めたりすることができます。
そのメリットには以下のようなものがあります。
- 複数の信頼できる情報源から動的にグループを作成できる
- 複数のインベントリーからホストを除外、解析、制限しながら、自動化の実行で使用できる
- フィルタリング時に事前定義済みの hostvars を使用できる
- 複数のチームが、ホストに関連付けられた独自のインベントリーとメタデータを所有し、Ansible Automation Platform を介して一元的に使用できる
執筆者紹介
類似検索
GPU 稼働時間を最大限に活用するRed Hat OpenShift AI における進捗状況の追跡
業界をリードする企業は、AI ビジョンをどのようにビジネス価値に変えているのか
How Red Hat cleared IT debt for scalable AI
Virtualization Is (Still) King | Compiler
チャンネル別に見る

自動化
テクノロジー、チームおよび環境に関する IT 自動化の最新情報

AI (人工知能)
お客様が AI ワークロードをどこでも自由に実行することを可能にするプラットフォームについてのアップデート

オープン・ハイブリッドクラウド
ハイブリッドクラウドで柔軟に未来を築く方法をご確認ください。

セキュリティ
環境やテクノロジー全体に及ぶリスクを軽減する方法に関する最新情報

エッジコンピューティング
エッジでの運用を単純化するプラットフォームのアップデート

インフラストラクチャ
世界有数のエンタープライズ向け Linux プラットフォームの最新情報

アプリケーション
アプリケーションの最も困難な課題に対する Red Hat ソリューションの詳細

仮想化
オンプレミスまたは複数クラウドでのワークロードに対応するエンタープライズ仮想化の将来についてご覧ください
