
周五晚上,金融服务公司的机器学习(ML)工程师 Priya,在一个成本为每小时 55 美元的 GPU 集群上,将一个欺诈检测微调任务加入了队列。该任务大约需要运行 40 小时,计算成本约为 2,200 美元。她仔细检查了超参数,提交了作业,然后回家过周末。
周一早上,她打开了笔记本电脑。该模型在周五晚上的某个时间就停止了学习,但作业一直在运行,这意味着在一项毫无进展的训练过程中,白白消耗了整整两天的 GPU 运行时间。这相当于浪费了超过 1,500 美元的计算资源,而她不得不从头开始。
如果这种情况让您觉得似曾相识,那说明您不是唯一遇到这种问题的人。每一位运行过多日训练作业的从业人员,都清楚这些令人不安的问题:
- 模型是否真的学到了东西?
- 我是否应该提前停止训练,尝试不同的超参数?
- 它能否在周二的利益相关者审核前完成?
由于缺乏对训练情况的了解,所带来的损失是实实在在的。按需使用的 GPU 集群的成本可高达每小时 50 美元以上。一次为期数天的训练任务动辄耗费数千美元,如果配置有误,很可能会在无人察觉的情况下浪费掉整个周末的计算资源。在共享集群中,这种影响会成倍放大:一项停滞的作业不仅会浪费一个团队的预算,还会阻碍其他团队访问所需的 GPU。一个团队的盲目运行会导致另一个团队延迟。问题并不在于团队粗心大意,而在于他们盲目运行。每一分钟 GPU 运行时间都至关重要,如果无法实时了解训练进度,就会浪费大量宝贵资源。
可观测性缺口
有这样一个令人不安的事实:从平台的角度来看,一个正在顺利收敛的训练作业和一个完全停滞不前的训练作业完全一样。两者都是处于运行状态的 Pod,消耗相同的资源,且都显示绿色的状态标识。Kubernetes 无法判断您的模型是否正在学习。
如今,虽然可以监控训练进度,但实现起来要比想象中困难得多。
- 日志分散且难以利用:在分布式训练作业中,日志分散在多个 Pod 中。要查找相关输出,您需要知道该查看哪个 Pod、如何访问它,以及如何解读特定于框架的日志格式。这需要具备 Kubernetes 专业技能,而对于大多数数据科学家和 AI 工程师来说,仅为了监控训练运行,本不需要掌握这项额外的技能。质量差且非结构化的日志难以被机器读取,因此无法推动自动化。
- 外部工具能解决可观测性问题,但增加了管理开销:MLflow 和 Weights & Biases 等实验跟踪平台在各自领域表现非常出色。但是,这些平台需要额外的基础架构来进行部署和维护,需要管理 API 密钥和访问控制,并且在平台层之上运行。此外,这些平台与 Kubernetes API 脱节,这意味着更难将其与自定义的 Kubernetes 原生工作流和自定义 Operator 集成。它们会告知您训练循环内部发生了什么,但无法告诉平台发生了什么。
- 每个框架的做法各不相同:PyTorch DDP、FSDP、DeepSpeed、JAX——这些框架各自拥有不同的日志记录规范、指标格式和进度报告方式。框架之间缺乏一致性,这意味着管理异构训练环境的平台团队无法获得统一的视图。
- 没有标准 API:到目前为止,训练作业还没有一种标准化的方式来向平台报告进度。结果就是,管理共享 GPU 集群的平台管理员只能靠猜测来判断哪些作业正在进行、哪些已经停滞以及哪些即将完成。如果缺乏这种可见性,容量规划和故障排除就只能靠猜测。
弥合差距:红帽 OpenShift AI 中的进度跟踪功能
红帽 OpenShift AI 现在面向分布式训练作业提供了生产就绪型进度跟踪功能,该功能内置于 Kubeflow Trainer v2 中,并从红帽 OpenShift AI 3.4 起正式可用。您可以实时了解作业情况,并及时采取行动,避免造成损失。借助此功能,数据科学家、ML 工程师和平台管理员能够实时了解训练作业的执行情况,直接弥补可观测性方面的不足。
这种可见性建立在三大支柱之上:
- 信息面板可视化:实时进度指标可直接在红帽 OpenShift AI 信息面板中查看。您可以一目了然地查看 TrainJobs 的进度百分比、当前步骤和总步骤数、当前轮次、预计剩余时间、训练损失及评估指标。无需单独的工具,亦无需额外设置。
- SDK 集成: 可以通过 Kubeflow SDK 以编程方式获取相同的进度数据。这使团队能够构建可根据训练进度做出响应的自动化管道,基于实时指标触发早期终止、发送通知或重新分配资源。
- 多框架一致性:无论您使用的是 PyTorch DDP、FSDP、DeepSpeed 还是 JAX,进度跟踪的工作方式都是相同的。它还通过 CustomTrainer API 支持自定义训练代码。这提供了跨框架的统一体验。
实时查看您的训练进程
了解进度跟踪的最佳方式,就是亲身体验一下使用它时的实际感受。有三个步骤至关重要。
- 启动训练作业: 您只需按照现有方式,通过 Kubeflow SDK 从 Notebook 提交训练作业。如果您使用的是 HuggingFace Transformers,系统会自动进行跟踪进度,无需更改代码。该集成会检测 Kubeflow 环境,并开始报告训练循环中的各项指标。
- 观察进度: 训练作业运行时,红帽 OpenShift AI 控制面板中会显示实时指标:进度百分比、预计剩余时间、已完成的步骤、轮次、梯度范数、训练损失、学习率。无需持续跟踪日志,无需通过 SSH 登录 Pod,也无需设置外部工具。
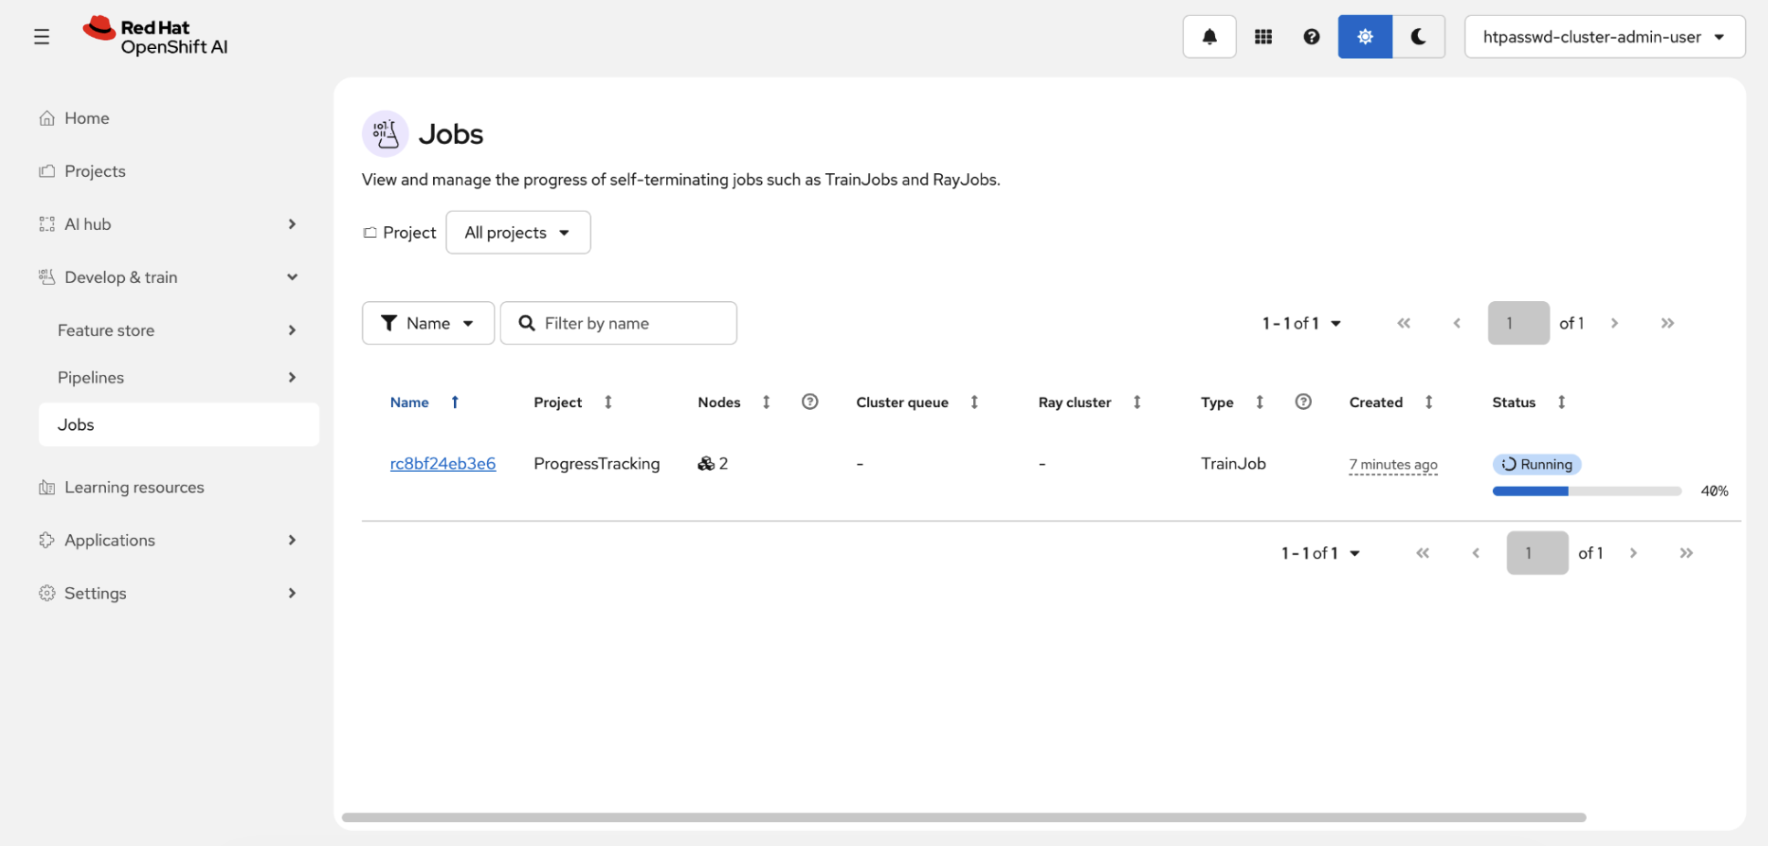
图 1:红帽 OpenShift AI 信息面板显示一个作业列表,并且一个正在运行的 TrainJob 旁有一个进度条,显示已完成 40%。
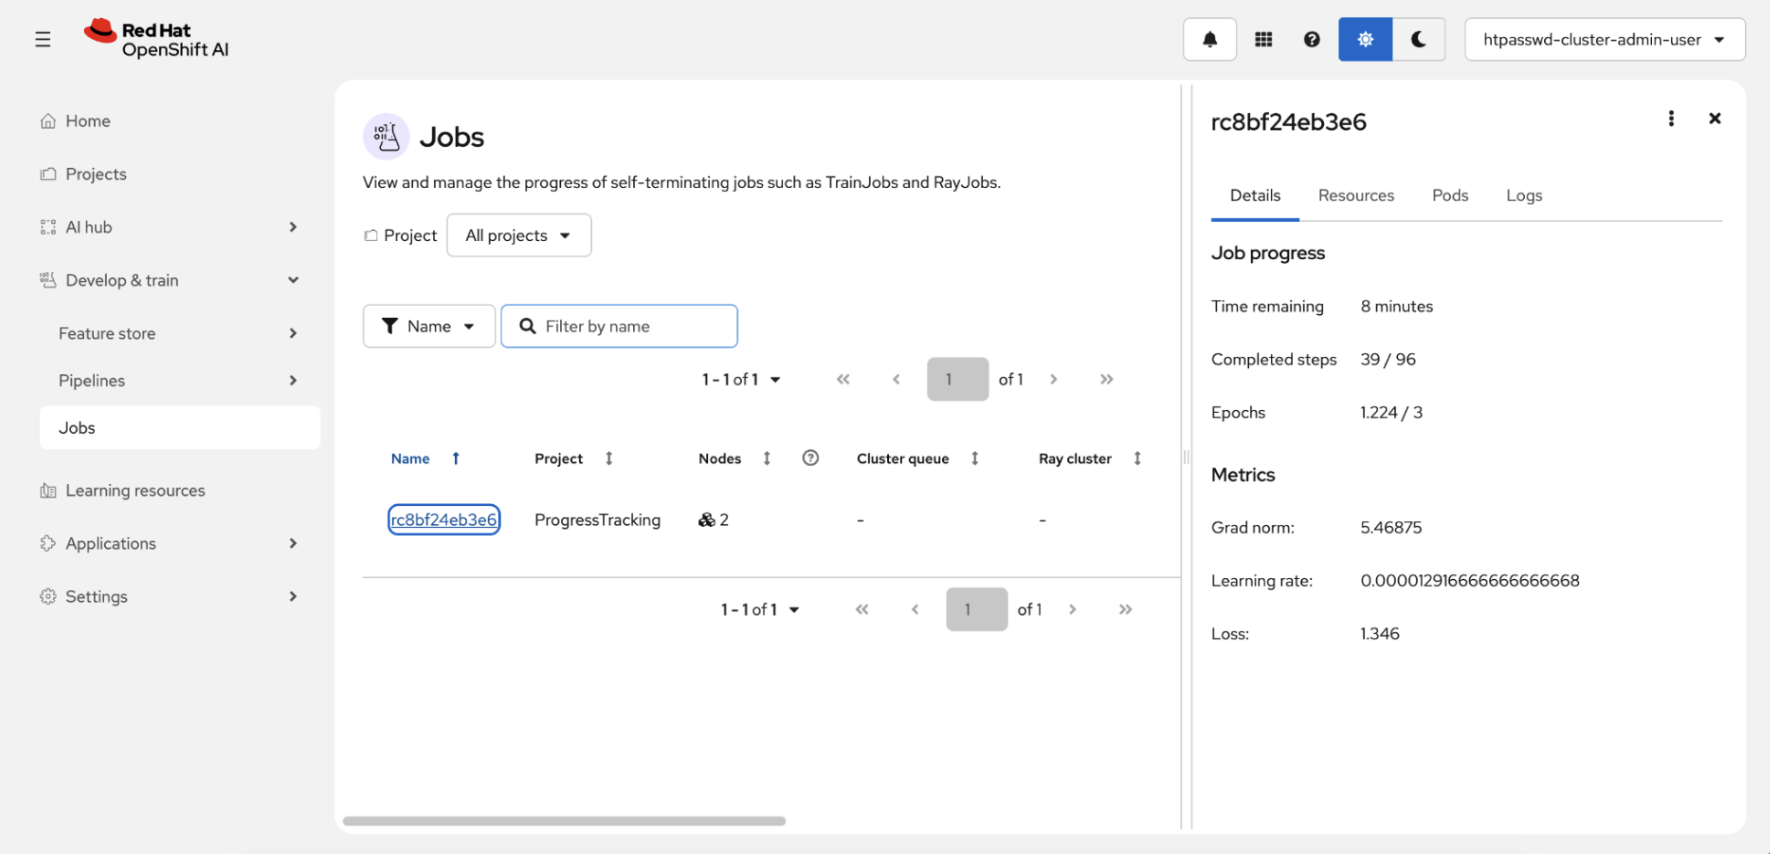
图 2: 一个显示作业进度和实时指标的详细侧面板。
- 根据所见采取行动:这正是进度跟踪真正能为您节省时间和计算资源的地方。注意到损失值不再下降了吗?尽早停止作业,节省数小时的 GPU 运行时间。发现运行收敛速度比预期快?为您的团队成员释放资源。准确掌握作业完成时间,以便进行相应规划,无需再猜测结果能否准备好供利益相关者在周二进行审查。
让这一功能切实可用的关键特性:
- 零设置:无需额外的基础架构、外部依赖项和额外的配置。进度跟踪开箱即用。
- 开销极低:在自然的训练检查点报告指标,不会影响训练性能。
- 在各种框架下都能正常运作:无论您使用的是 PyTorch DDP、FSDP、DeepSpeed、JAX 还是自定义训练代码,体验完全一致。
谁将受益
数据科学家和 ML/AI 工程师无需通过 SSH 登录 Pod 或跟踪日志,即可实时查看训练损失值、进度百分比和预计完成时间(ETA)。尽早检测出训练发散或停滞情况,例如在周六早上(而非周一)发现作业停滞不前,可以节省数小时原本会被浪费的 GPU 运行时间。通过控制面板一目了然地查看并对比不同训练运行情况,快速识别出表现最佳的超参数配置。
平台管理员可以通过单个信息面板视图查看集群中的所有训练作业。无论作业使用的是 DDP、FSDP 还是 DeepSpeed,他们都能看到一致的指标,并通过了解哪些作业正在进行、哪些作业处于停滞状态以及哪些作业即将完成,从而做出更合理的容量规划决策。
在多个团队共享同一集群的多租户 GPU 环境中,这种可见性直接带来更高的资源利用率和投资回报率。对于正在构建 GPU 即服务模式的企业组织而言,进度跟踪功能填补了一个关键空白——将“GPU 利用率黑箱”转变为可观测、可管理的系统。最终,这使平台团队能够消除基础架构瓶颈,并自信地为数据科学家提供加速 AI 创新所需的资源。
超越监控:为更智能的训练奠定基础
进度跟踪不仅仅是一项监控功能,更是一个基础。一旦该平台能够获取实时的训练进度数据,一系列更智能的行为就有了实现的可能。虽然这些高级能力尚未成为红帽的产品承诺,但基础已经具备。上游 Kubeflow Trainer 社区正在积极探索以下几个方向:
- 更智能的超参数调优:如今,像 Katib 这样的超参数优化引擎依赖于解析具有不稳定的正则表达式模式的日志来评估试验性能。借助直接通过 Kubernetes API 提供的训练指标,Katib 可以原生读取训练状态,从而实现更紧密的集成和更高效的试验编排。这是上游社区讨论的 KEP。
- 弹性扩展:收敛速度和 ETA 数据可以为扩展和缩减决策提供依据。快速收敛的模型可以释放 GPU 以供其他团队使用,而停滞不前的模型则可以请求更多工作节点。上游社区正在探索在 TrainJob 中为 PyTorch 提供弹性支持,以实现这一目标。
- CLI 进度可见性:具有内置
PROGRESS %列的kubectl get trainjob,可使训练进度直接显示在命令行中,让运维人员无需借助信息面板或 SDK 就能即时了解情况。 - 更智能的检查点: 虽然 OpenShift AI 已经支持周期性和即时模型检查点,但有了 ETA 和进度数据,该平台可以就何时生成检查点做出更明智的决策(例如,根据作业 ETA 自动保存状态)。上游社区正在探索通过 CRIU 实现透明的 GPU 检查点,以增强 TrainingJob 的容错能力和弹性。
以上是 Kubeflow 项目中正在积极探索的领域,并非产品承诺,但它们说明了为什么进度跟踪的意义超越了这一功能本身:它创建了整个训练堆栈都可以赖以构建的数据层。
面向分布式训练的进度跟踪功能已在红帽 OpenShift AI 3.4 中正式可用。如需了解更多信息,请参阅红帽 OpenShift AI 文档。或者,开始为期 60 天的红帽 OpenShift AI 试用,亲自上手体验。
关于作者
I am a Software Quality Engineer at Red Hat specializing in Kubeflow and distributed AI training. I am focused on making large-scale infrastructure efficient and resilient, and I share insights on distributed model training and fine-tuning on Kubernetes.


