为什么要关注 AI 推理
简单来说,没有推理就没有 AI。推理是生成式 AI 的核心。
好消息是,我们知道它能取得多大的成功。挑战在于:如何实现 AI 推理的规模化扩展?
我们来详细探讨下如何利用 vLLM 和 llm-d 等开源工具,实现 AI 推理的规模化扩展。
为何推理至关重要?
推理是模型生成预期输出的最后一步。它是 AI 取得成功所必需的功能。
正因如此,支持推理的软件和硬件将直接决定您的 AI 策略的成败。
具有最广泛扩展选项的架构是基于开源技术构建而成。
什么是阻碍扩展的元凶?
我们知道 AI 是有效的,但挑战在于如何在整个企业范围内进行扩展。
当您进行扩展时,模型需要更多的数据和更大的内存。这时,硬件和加速器往往难以满足需求。
选择第三方服务提供商似乎是最简单的解决方案。但词元成本会迅速增加,有时甚至超过 AI 应用本身的成本。
40%
到 2030 年,推理将成为 AI 数据中心的主要工作负载,预计将占数据中心总需求的 40%。1
那么,该如何优化推理呢?
当您在开源架构上优化推理时,AI 模型能够更快、更智能地运行。
优化策略包括:
- 通过量化来压缩模型。
- 更高效地处理 GPU。
- 推测性解码。
- 分布式推理。
- 将内存和编排任务卸载到 CPU
此类优化有助于 AI 推理保持成本效益,能够随团队发展而同步扩展。
19%
使用推测性解码技术,大规模部署时可节省 19% 的成本。2
两倍
采用压缩模型后,计算吞吐量提升两倍,且不影响准确性。3
90%
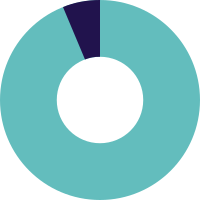
端到端总延迟中,有 90% 是由 CPU 造成的。4
vLLM 是如何优化推理的?
模型优化只是第一步。您还需要一个高性能的推理引擎。这正是 vLLM 的用武之地。
传统的 LLM 内存管理系统在组织内存方面并不高效,因此会影响 LLM 的运行速度。vLLM 采用 PagedAttention 内存管理技术,该技术可识别重复的键值,从而减少 LLM 的额外工作量。
这使得 vLLM 能够更好地利用 GPU 内存,加速生成式 AI 的推理过程。它可最大限度地提高吞吐量(每秒处理的词元数),从而可以同时为众多用户提供服务。
更高效地利用加速器,这意味着模型可以在更短时间内完成更多数学运算,从而使团队能够更快地为更多用户和 AI 代理提供服务。
75%
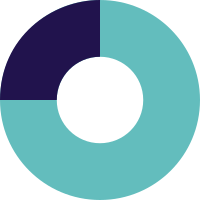
内存需求降低了 75%,从而减少了所需的 GPU 数量。5
四倍
与大多数推理服务提供商相比,每秒处理的词元数量高出四倍。6
24 倍
与竞争对手相比,vLLM 的吞吐量性能提高了 24 倍。7
为什么 vLLM 如此受欢迎?
vLLM 通过开放且可移植的部署方案,有效解决了高效利用 GPU 的核心难题,显著降低了每词元成本,并在大规模场景下实现稳定延迟。
vLLM 针对所有主流模型和加速器提供 Day 0 支持,并且它易于使用,对产业界和学术界都极具吸引力。这也是 vLLM 社区一直保持活跃并蓬勃发展的重要原因。
Hugging Face、加州大学伯克利分校、英伟达和红帽等众多组织的积极贡献,持续推动着 vLLM 的发展。社区成员在这个开源项目中不断对软件进行挑战与改进,使其持续优化。
超过 10,000 次
2026 年,vLLM 在 GitHub 上的代码提交(commit)次数*超过 10,000 次,增幅超过 200%。
如今的 vLLM 社区
超过 50 万
超过 50 万个已部署 GPU 全天候不间断运行8
超过 200
超过 200 种不同类型的加速器9
超过 500
支持的模型架构数量超过 500 种9
超过 3,100
分布式推理如何发挥作用?
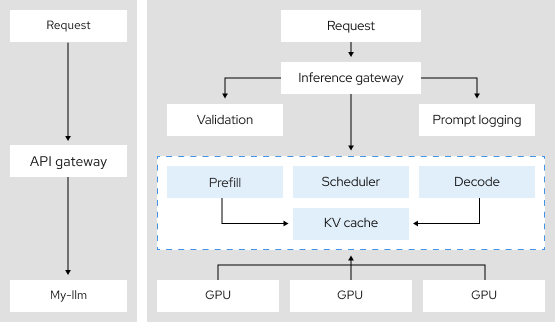
借助分布式推理,AI 模型能够将推理任务分配给一组互联设备协同处理。
当模型能够同时满足不同请求时,便能显著减少所需硬件并提升推理效率。
分布式推理采用张量并行、智能推理调度和解耦等技术。当与 vLLM 结合使用时,推理的作用便相当于一台高效的多任务处理机器。
这有助于推理过程保持可观测性、可扩展性和一致性。
99%
同等负载下,首个词元生成时间(TTFT)降低了 99%。10
是否有相应的开源社区?
有,名字就叫“llm-d”。
llm-d 是一个开源框架,为开发人员提供了大规模构建分布式推理的参考架构。
其模块化架构能够满足复杂 LLM 的高资源需求,并以集成化的规范化路径取代过去手动的碎片化流程,从而加速从试点阶段到生产阶段的进程。
llm-d 将推理能力引入 Kubernetes,提供了一套标准化的工具包,帮助您将分布式推理应用到独特的企业用例。
两倍
采用 llm-d 优化后的集群,相同硬件上支持的用户数量提升了两倍。11
更多 AI 资源
红帽 AI 推理
让您的 LLM 更快地从代码阶段迈向生产阶段。
借助基于 vLLM 构建的企业级推理引擎,可在不牺牲性能的前提下实现更快的推理。
使用您首选且经过优化的生成式 AI 模型,在任意 AI 加速器和云环境中实现跨混合云扩展。

引用来源
[1] “The future of AI workloads”(AI 工作负载的未来),麦肯锡咨询公司,2026 年 2 月 24 日。
[2] Harshith Umesh。“Performance improvements with speculative decoding in vLLM for gpt-oss”(通过在 vLLM 中对 gpt-oss 进行推测性解码,性能得到了提升),红帽开发人员博客,2026 年 4 月 16 日。
[3] Eldar Kurtić 等。“2:4 Sparse Llama:Smaller models for efficient GPU inference”(2:4 稀疏化 Llama:实现高效 GPU 推理的更小模型),红帽开发人员博客,2025 年 2 月 28 日。
[4] Sawyer Bowerman。Grace Ableidinger。“The CPU is back:Rethinking the CPU-GPU split for LLM inference”(CPU 回归:重新思考 LLM 推理中的 CPU-GPU 分工),红帽博客,2026 年 8 月 6 日。
[5] “What is LLM Compressor?”(什么是 LLM 压缩器?),vLLM 文档。
[6] “vLLM Tops the Artificial Analysis Leaderboard(vLLM 荣登人工分析排行榜榜首),vLLM 博客,2026 年 5 月 11 日。
[7] Woosuk Kwon 等。“vLLM:Easy, Fast, and Cheap LLM Serving with PagedAttention”(vLLM:基于 PagedAttention 实现简单、快速且低成本的 LLM 服务),vLLM 博客,2023 年 6 月 20 日。
[8] Michael Goin。“[vLLM Office Hours #38] vLLM 2025 Retrospective & 2026 Roadmap - December 18, 2025”([vLLM Office Hours 第 38 期] vLLM 2025 年回顾与 2026 年路线图——2025 年 12 月 18 日),YouTube,2025 年 12 月 8 日。
[9] Woosuk Kwon。“Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale”(如今,vLLM 支持超过 500 种模型架构,可在超过 200 种加速器上运行,并为全球范围内的大规模推理提供动力),X,2026 年 1 月 26 日。
[10] Naina Singh。“The same 16 GPUs, twice the users:Inference-aware routing for LLM clusters”(同样 16 块 GPU,服务用户数却倍增:面向 LLM 集群的推理感知型路由),红帽博客,2026 年 5 月 27 日。
[11] Naina Singh。“The same 16 GPUs, twice the users:Inference-aware routing for LLM clusters”(同样 16 块 GPU,服务用户数却倍增:面向 LLM 集群的推理感知型路由),红帽博客,2026 年 5 月 27 日。
