
当您不再将 AI 智能体视为聊天机器人,而是开始将它们视为管道中的工作节点,会发生什么?本文将介绍如何将庞大杂乱的 Jira 待办事项转变为自编排系统,以及在此过程中总结的经验教训。
摘要
我们构建了一个智能体工作流,该工作流可以自动发现 Jira 工单,利用源代码控制上下文进行信息丰富,并生成结构化摘要,让工单可处理,所有这些都无需人工干预。在实践中,该管道每周处理数十个工单,将分类用时从几小时缩短到几分钟,让开发人员能够即时获取可处理工作的相关上下文。通过这一历程,我们从单一的单体式提示词(勉强能够运行)转变为模块化、基于分区的管道,其中每个工单都会流经独立的智能体会话。这篇文章将介绍概要设计、大规模编排 AI 智能体所面临的挑战,以及我们总结的经验教训。后续文章将深入探讨技术实施细节。
问题:工单太多,时间太少
如果您曾经盯着 Jira 看板,看着几十个待处理的工单分散在各个冲刺、待办事项以及搁置已久的史诗中,您就会明白这种感受。在工单之间切换上下文、了解每个工单需要什么,以及确定哪些工单可处理,这些会带来巨大的心理负担。如果再叠加每个工单所涉及的存储库数量,就很容易陷入停滞。
我们想看看智能体工程能否处理这类繁琐工作:从 Jira 中提取工单,利用源代码控制上下文进行信息丰富,并生成结构化摘要,让下游智能体(或人类)可以立即据此采取行动。这些工作需要及时完成,无需人工照看单个会话。
最终成果是一个模块化、基于分区的自动化管道,它将每个 Jira 工单视为独立的工作单元,流经定义明确的阶段。我们称之为“驯服智能体猛兽”,因为真正的挑战在于管控 AI 智能体,构建可靠、可重复的工作流。
为什么不直接编写脚本?
人们的第一反应往往是编写 Python 脚本,调用 Jira 应用编程接口(API),整理出一些 Markdown 内容,然后就大功告成了。我们也考虑过这个方案,但很快就发现了局限性:
- 上下文至关重要。脚本可以拉取工单字段,但无法推理判断:工单描述是否模糊、验收标准是否合理,或者持续集成(CI)管道的失败是否与该工单相关。
- 信息丰富需要判断力。确定工单对应的存储库、从藏在评论中的统一资源定位符(URL)映射项目路径,以及评估工单信息是否充足、能否据此采取行动,所有这些都受益于语言模型推理能力。
- 管道需要状态管理。工单不是一次性任务。工单会经历发现、分类、阻塞、信息丰富和验证这几个环节。脚本只能处理单个步骤;您需要一个工作流来管理整个生命周期。
因此,我们没有使用脚本,而是构建了由智能体会话组成的管道,通过基于看板的状态机进行协调。
关键概念:构建模块
在深入探讨架构之前,先介绍几个关键概念:
- Agor 是一个用于跨存储库编排 AI 智能体会话的框架。它提供基于看板的界面(可以理解为看板),工作项在各列之间流转,每列都可以触发智能体会话,且附带特定提示词和工具集。对于本演示,我们将 Agor 用作编排层,但本文中描述的设计模式(例如基于分区的管道、结构化输出契约和有状态编排)与框架无关。红帽不会将您绑定到特定的智能体框架;而是提供运行智能体的基础。在企业环境中,您可以使用红帽 OpenShift AI 部署这些模式,该平台可让您托管、扩展您选择的任何智能体并将其投入生产运维。
- 分区是看板上的列。每个分区代表工作流中的一个阶段(发现、分类、就绪等),并拥有独立的智能体配置:专用提示词、一组模型上下文协议(MCP)工具集成,以及用于确定何时启动会话的触发规则。
- 工作树是工作单元。每个 Jira 工单都有自己的工作树,由目标存储库中的 Git worktree 提供支持,工单在管道中推进时,对应的工作树会在分区之间流转。工作树携带元数据(Jira 问题 URL、拉取请求(PR)/合并请求(MR)URL、备注、自定义上下文),其所在的分区位置可以直观展示工单在工作流中的进度。可以将其视为看板卡片,而它本身又是一个真实、独立的 Git 工作目录。
架构:分区作为状态机
核心思路借鉴自看板:每个工单在各个分区之间流转,每个分区配备独立智能体与专属提示词。没有任何智能体尝试包揽全部工作。发现智能体只负责发现工单,分类智能体只负责分类,以此类推。
工作流
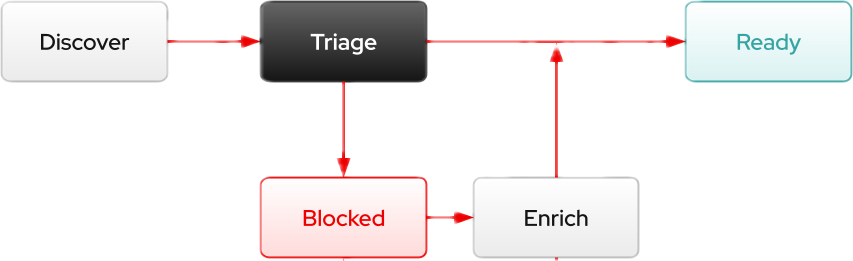
基于分区的管道的可视化图,展示了工作树的整个生命周期:从初始发现开始,经过分类,路由到就绪状态,或者进入阻塞路径以进行上下文信息丰富。
分区 | 执行内容 |
发现 | Cron 调度:查询 Jira、置备工作树,并对看板运行健康检查 |
分类 | 按工单处理:分析原始工单,确定其上下文是否充足,能否处理 |
阻塞 | 按工单处理:保存需要更多上下文的工单,可通过自动化信息丰富或人工干预补充信息 |
信息丰富 | 按工单处理:为工单补充源代码控制上下文(CI 状态、MR 和相关问题),并生成结构化摘要 |
就绪 | 已完成信息丰富且摘要经过验证的工单,可供人工审核或下游处理 |
关键见解是工作树让管道具备状态。无状态脚本在每次运行结束后会丢失全部信息,与此不同,每个工单对应的工作树可在会话之间持久留存。它所在的分区位置就是状态,它携带的元数据就是记忆。当工单依次经过分类、信息丰富并进入就绪分区时,沿途的每个智能体都会向工作树累积上下文,而工单所在的分区会直接告知下一个智能体需要执行的操作。
我们来逐步了解各个已实施的阶段。
发现智能体:心跳
发现分区按照可配置的 Cron 调度运行独立的“哨兵”工作树。可以将其视为管道的心跳,即确保所有内容保持同步的控制循环。它会定期唤醒,执行以下操作:
- 使用 3 个 Jira 查询语言(JQL)查询(活跃史诗、冲刺工单和待办事项)来查询 Jira,全面了解分配的未完成工作。
- 与看板进行比较,查找还没有工作树的新工单。
- 从 Jira 工单描述和注释中提取存储库 URL,解析 GitHub 和 GitLab URL,找出每个工单的目标存储库。
- 注册和克隆系统尚未收录的存储库。如果工单引用了 gitlab.com/org/project,并且该存储库不在磁盘上,发现智能体会克隆该存储库,并在编排框架内完成注册。
- 分批置备工作树,为每个新工单在其目标存储库中创建工作树,并将其放入分类分区。
- 执行心跳检测,检测陈旧的工作树、分区不匹配(例如 Jira 显示“完成”,但工作树仍位于“分类”分区),以及过时的摘要。
- 生成每日报告,记录发现的内容、创建的内容,以及状态异常的工作树。
一项关键设计决策:发现智能体绝不生成工单摘要。它只负责发现、置备和路由。信息丰富和摘要生成在下游的专用分区中进行。这种关注点分离可让每个智能体职责单一,失败相互隔离。即使发现智能体出现问题,也不会损坏信息丰富管道的输出;反之亦然。
分类智能体:一个工单,一个会话
这正是设计的巧妙之处。每个工单都有自己的独立会话,而不是由单个智能体按顺序处理全部工单。真正的按工单并行处理:可以同时对 5 个工单进行分类,工单之间不存在相互依赖关系。
发现智能体为每个新工作树设置调度,以便编排框架自动为其启动分类会话。每个分类会话会执行以下操作:
- 获取完整的 Jira 工单(所有字段、最近的评论),了解完整情况。
- 验证工单上下文是否充足,能否处理。工单是否提及至少一个存储库?是否有明确需求?验收标准是否清晰?
- 路由工作树:定义明确的工单直接进入“就绪”分区,信息不足的工单进入“阻塞”分区,以便进行信息丰富。
分类智能体有意设计为轻量级:它只负责做出路由决策,而不是内容决策。繁重的工作将在下一阶段进行。
信息丰富智能体:添加缺失的上下文
流转到“阻塞”分区的工单需要更多上下文才能发挥作用。信息丰富智能体负责轮询这些工单,并触发信息丰富会话,使用目标源代码控制项目和相关 Jira 工单中的信息来完善这些工单。
每次信息丰富会话执行以下操作:
- 通过源代码控制上下文丰富信息,包括 CI 管道状态、待处理的合并请求,以及来自 GitLab 或 GitHub 的相关问题。
- 生成带有 YAML(YAML 不是标记语言)前置元数据的结构化 Markdown 摘要,作为下游使用方(人工审核员或后续智能体)的输入契约。
- 根据结构化摘要更新 Jira 工单,将丰富后的上下文回写到事实来源。
- 路由工作树:信息补充充分的工单进入“就绪”分区,仍然缺乏关键上下文的工单移回“阻塞”分区,进行人工干预。
摘要格式是管道的骨干。YAML 前置元数据包含机器可解析的元数据:工单键、类型、状态、存储库、CI 状态和待处理的 MR。Markdown 正文包含标准化板块:描述、上下文与分析、详细要求、技术考量、验收标准和依赖项。
演进:从单体式到模块化
最初,我们在单一会话内使用单体式提示词处理全部工作。虽然勉强能够运行,但我们很快就遇到了运行时间过长、上下文窗口溢出,以及状态无法跟踪的问题。只要一个工单出现错误,整批任务就会失败,而依序处理意味着完全无法并行执行。改用基于分区的模块化设计后,通过隔离问题,并将每个工单视为独立的工作树进行处理,上述问题得到解决。
架构还进行了另一项改进,直接在每个工单的目标存储库中创建工作树,而不是在中央管道文件夹中。这样一来,每个智能体会话启动后,可直接访问代码库,无需额外的目录跳转操作。
编排 AI 智能体所面临的挑战
在构建这个系统的过程中,我们遇到的挑战并不局限于任何特定工具。只要您尝试让 AI 智能体在自动化管道中稳定运行,就一定会遇到这类问题。
智能体需要护栏,而不是自由
对于智能体工作流,最大的误区是认为应当赋予智能体最大自主权。实践得出的结论恰恰相反。当智能体的处理范围较窄,且输出格式严格时,它的表现最佳。如果提示词仅写“处理这些工单”,得出的结果会非常不一致。如果提示词写明“获取这 1 个工单,使用这些特定工具丰富信息,严格按照这种格式编写摘要,根据这些标准进行验证,然后路由到两个分区之一”,输出结果会更加可靠。
每次收窄智能体的处理范围,输出质量就会提升,失败也随之减少。
调度问题
AI 智能体会话无法瞬时完成。整个过程需要几分钟,甚至更长时间。如果在 Cron 上调度智能体,并且上一会话尚未完成,就会出现重复执行、处理同一工单的情况。我们的解决方案是:让每个分类会话在执行收尾时,禁用自身对应的调度任务。但这会形成脆弱的耦合关系:如果会话在禁用调度前发生崩溃,那么下一次 Cron 触发时,重复任务又会启动。可以使用更可靠的解决方案(幂等性令牌、外部锁管理器),但这会增加复杂度。
基于无状态智能体实现有状态编排
每个智能体会话都是全新启动的,没有上一轮运行的记忆。但管道需要连续性:“该工单昨天已完成分类和信息增强,无需重复处理。”我们的解决方法是将状态提取到外部,保存在工作树元数据和分区位置。智能体无需记住上次执行的操作;看板会告知它当前需要执行的任务。事实证明,这种模式(无状态智能体、有状态编排)是保证可靠性的关键。
API 没有提供所需能力时
并非所有编排框架都能通过 API 提供全部能力。我们遇到过这样的情况:核心功能(在我们的案例中为调度管理)无法通过标准工具接口调用,只能采用直接访问数据库这类变通方案。这种方式比较脆弱,并且依赖于版本。经验教训:评估编排平台时,务必要确认自动化所需的功能是否可通过 API 访问,而不是仅能在用户界面(UI)上操作。
无人值守场景下的权限模型
要让管道在无人值守的情况下运行,每个调度的会话都必须能在无需人工审批的情况下执行。大多数智能体框架的权限模型都是为交互式场景设计的,每个操作都需要人工确认。在 Cron 上运行智能体需要范围更广泛的权限模式,这意味着要相信智能体的提示词不会越界。在自动化和安全性之间取得恰当平衡是持续存在的设计挑战,尤其是在共享环境中。
经验教训
在运行此管道的过程中总结的一些运维经验:
- 分批处理,不要全量爆发。同时创建许多工作树可能会使文件系统置备不堪重负。我们以 3 个为一组分批创建,并在批次之间增加验证。失败的置备在清理后重试 1 次;持续失败的置备会被记录并跳过。仅这一项就消除了整类“工作树目录不存在”导致的崩溃。
- 依靠心跳机制发现偏差。Jira 和看板不可避免地会出现不一致。工单可能在管道外部被标记为已解决,冲刺会轮换,负责人会变更。定期执行心跳检测,让看板与 Jira 保持一致至关重要。如果没有该机制,陈旧的工作树会在无人察觉的情况下不断堆积。
- 结构化输出是硬性要求。包含 YAML 前置元数据的摘要格式让管道具备可组合性。每个阶段都可以信任上一阶段的输出,而无需解析自由格式的文本。如果必须从头开始重新构建,我们会先定义输出架构,然后反向构建。
- 将编排与执行分开。发现智能体负责编排(创建工作树、设置调度、监控健康状态)。分类智能体负责执行(处理 1 个工单)。在单体式方案中,将这两类职责混合在一个智能体内是绝大多数失败的根源。
- 在提示词中对工具引用进行泛化。早期的提示词中充斥着特定于工具的细节,例如特定的命令行界面(CLI)标志、硬编码的字段 ID。这些都会变成维护负担或可移植性问题。尽可能进行抽象处理,将特定于工具的细节放在配置中,而不是提示词中。
运行良好的方面
尽管存在不足之处,但几个方面确实进展顺利:
- 零接触发现。新的 Jira 工单会以工作树的形式显示在看板上,无需任何人工干预。由 Cron 驱动的发现智能体负责整个生命周期。
- 真正的并行处理。同时对多个工单进行分类,每个工单拥有独立会话,工单之间不存在相互依赖关系,也不共享状态。
- 结构化输出契约。已完成信息丰富的 Jira 工单以及生成的摘要格式统一、支持机器解析,并且包含充足的上下文,可供人工审核员或下游智能体理解工单。
- 健康监控。心跳机制能够捕获陈旧的工作树、分区不匹配,以及过时的摘要。这是一种轻量级但有效的自我修复机制。
- 存储库感知型工作树。每个工单的工作树位于其目标存储库中。会话会从正确的位置启动,代码可以直接访问。
后续展望
未来,我们希望深入探讨使用 Agor 的技术实施,包括分区配置、MCP 工具接入以及调度机制。
请注意,本系列文章将 Agor 作为示例框架,探讨智能体工作流设计模式。Agor 不是红帽产品,也不属于红帽 OpenShift AI 支持的技术栈。若要在红帽支持的技术栈上部署生产级智能体工作负载,以及想要了解如何使用我们的官方工具应用这些概念,请参阅红帽 OpenShift AI 文档,并访问我们的智能体 AI 着陆页。
关于作者
Joseph Berry is a Senior Machine Learning Engineer at Red Hat, where he focuses on AI infrastructure, machine learning systems, and performance benchmarking. He has nearly a decade of experience building production-scale ML and data platforms, with a focus on bridging the gap between research and reliable, scalable production systems.
Before joining Red Hat, Joseph worked as an ML Engineer across various sectors, including InsurTech, MediaTech, MobileTech, and Homeland Security. In these roles, he led MLOps and data engineering initiatives, built cloud-based ML infrastructure, and developed tools for deploying multimodal models at scale. Earlier in his career, he held various geoinformation positions across startups and established enterprises.
His technical interests span distributed computing, MLOps, cloud platforms, geoinformation systems, and open-source technologies, with an emphasis on making AI systems more efficient, reproducible, and accessible in production environments.


