대규모 언어 모델(LLM)을 사용하거나 이를 기반으로 서비스를 구축하는 경우, 가장 먼저 이해해야 할 핵심 개념은 바로 추론과 키-값(KV) 캐시의 작동 방식입니다. 코딩 에이전트, 검색 증강 생성(RAG), 미세 조정(fine-tuning) 등 어떤 작업을 수행하든 추론은 모델에 요청을 보내고 응답을 받을 때마다 매번 실행되는 핵심 과정이며, 대부분의 비용이 발생하는 지점이기 때문입니다.
교육은 한 번만 진행되지만, 추론은 사용자가 프롬프트를 보낼 때마다 매번 수행됩니다. 이제 추론의 작동 방식과 KV 캐시의 개념, 그리고 대부분의 팀이 인프라 비용을 절감하고 대기 시간을 줄이기 위해 사용하는 최적화 기법을 살펴보겠습니다.
추론은 모델 파일이 아닌 스택
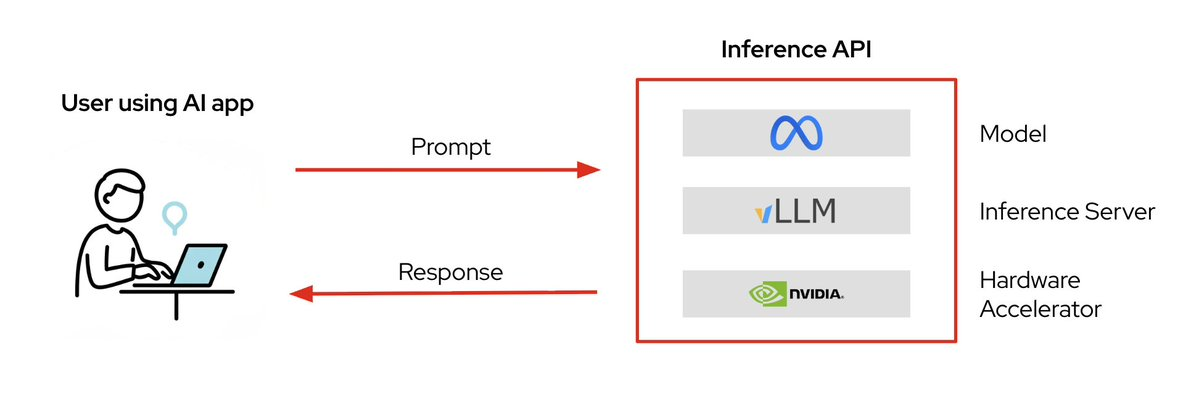
그림 1: 모델을 서빙하려면 가중치, 추론 서버, 기반 하드웨어라는 세 가지 요소가 유기적으로 작동해야 합니다.
로컬 머신(또는 HuggingFace)에 저장만 되어 있는 모델은 아직 아무에게도 서비스를 제공하지 못합니다. 추론이 원활하게 이루어지려면 다음 세 가지 요소가 함께 작동해야 합니다.
- 모델 가중치: 수십억 개의 학습된 매개변수가 포함된 파일: Kimi, GLM, Qwen 등 여러분이 선택한 그 어떤 모델이든 해당합니다.
- 추론 서버: 모델을 로드하고, 유입되는 요청을 관리하며, 뒤에서 다룰 최적화를 처리하는 vLLM과 같은 소프트웨어입니다.
- 하드웨어 가속기: 대규모 수치 연산을 주로 처리하는 GPU입니다.
중간 계층을 건너뛰고 PyTorch를 사용하여 GPU에서 직접 모델을 실행할 수도 있습니다. 이는 노트북 환경이나 단일 사용자를 대상으로는 원활하게 작동합니다. 하지만 여러 사용자에게 동시에 서비스를 제공해야 하는 환경에서는 추론 서버가 있어야 GPU를 프로덕션 규모로 활용할 수 있습니다(로컬에서 HTML 파일을 직접 여는 것과 Apache HTTP 서버를 통해 웹 서비스를 제공하는 것의 차이를 떠올려 보세요).
모델은 한 번에 1개의 토큰 생성
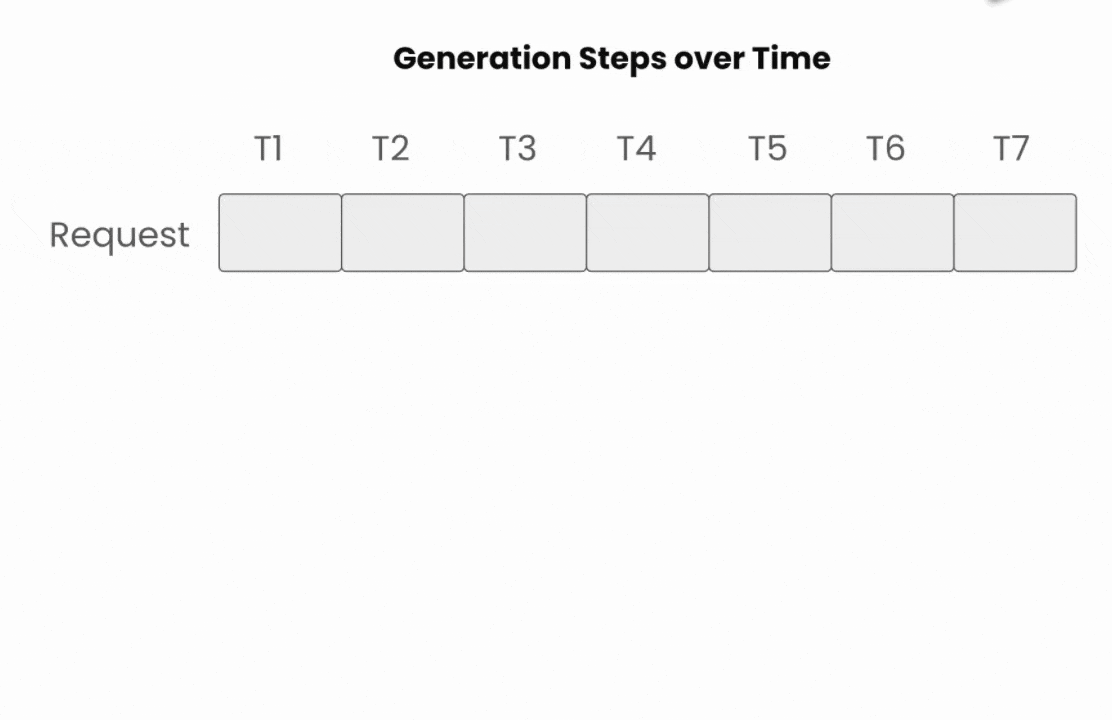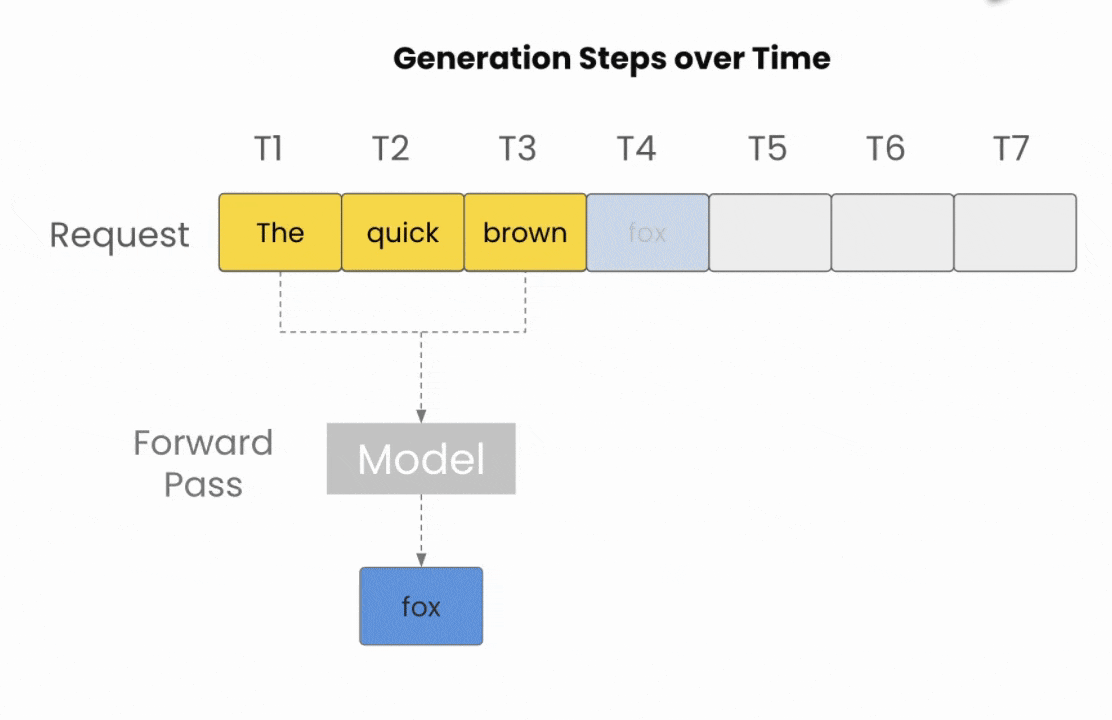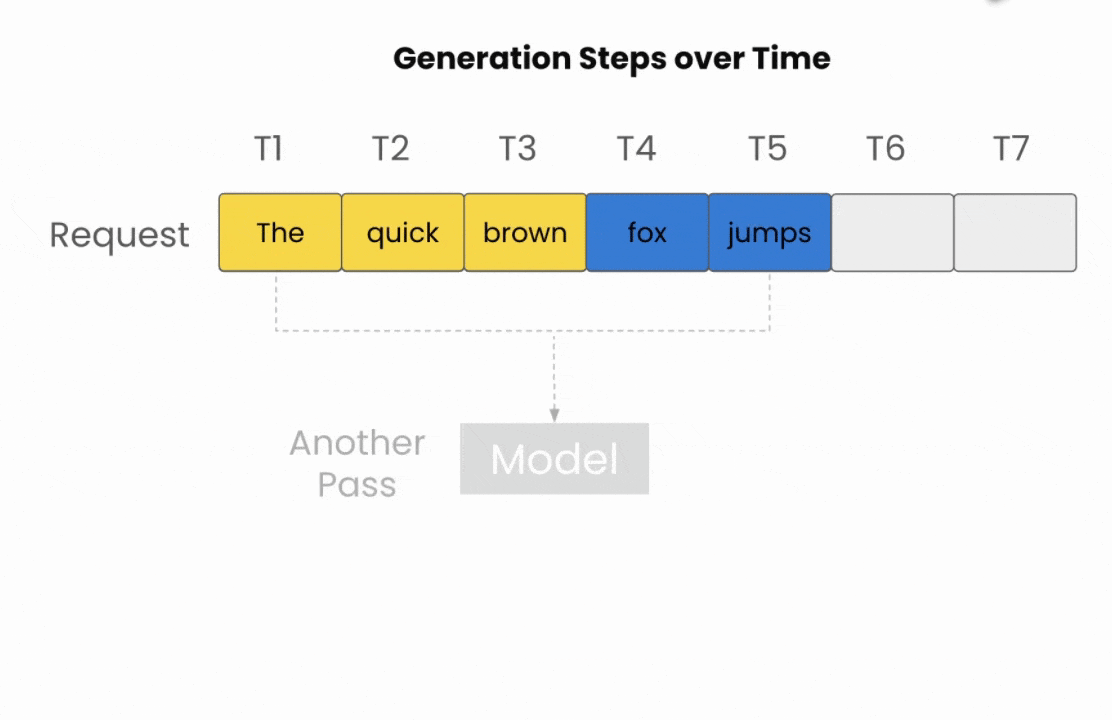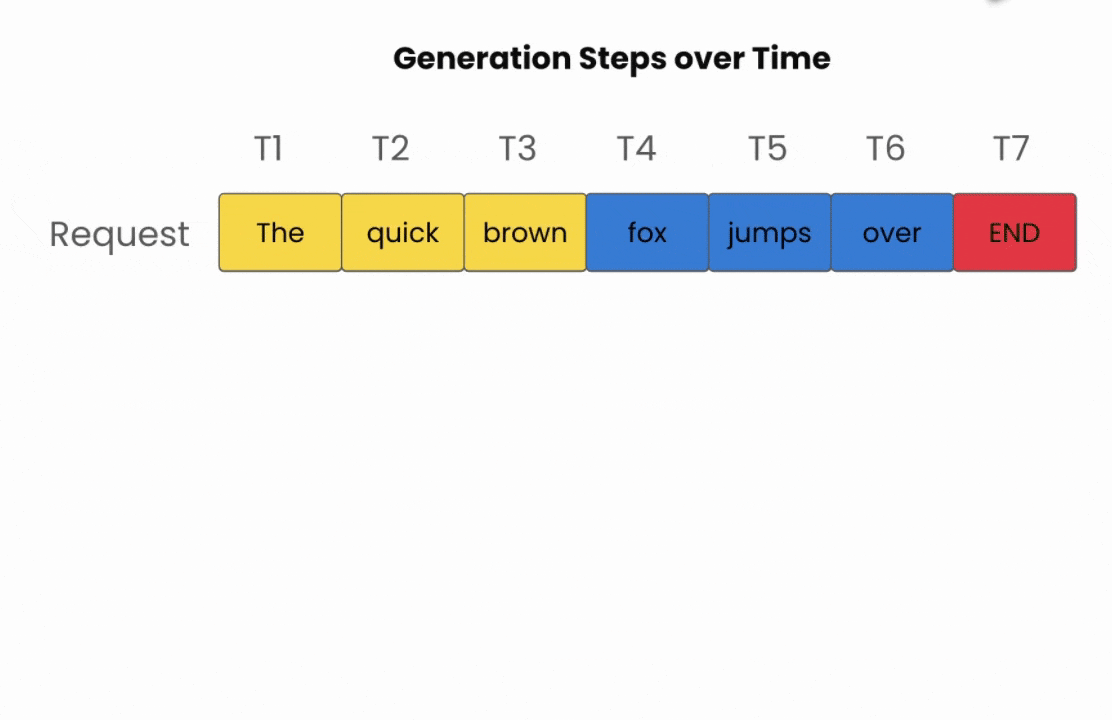
그림 2: 각 순전파(forward pass)는 정확히 1개의 새 토큰을 생성하며, 생성된 토큰은 다음 토큰을 생성하기 위한 입력으로 다시 전달됩니다.
LLM은 긴 응답을 한 번에 생성하지 않고 토큰을 한 번에 하나씩 생성하며, 각 새 토큰은 모델이 방금 생성한 토큰을 포함한 이전의 모든 토큰에 의존합니다.
다음 예시 프롬프트로 살펴보겠습니다. "The quick brown"
- 모델이 "fox"를 예측 → 해당 토큰이 뒤에 추가됨
- "The quick brown fox" → "jumps" 예측 → 뒤에 추가됨
- 모델이 특수한 시퀀스 종료(end-of-sequence) 토큰을 출력할 때까지 이 과정이 반복됩니다.
이것이 바로 자기회귀(autoregressive) 생성 방식이며, 응답에 포함된 모든 토큰마다 모델 전체를 통과하는 순전파가 필요하다는 점을 간과하기 쉽습니다. 500개 토큰으로 구성된 응답은 모델이 500번 실행됨을 의미하며, 이를 통해 연산 수요가 급격히 증가하는 이유를 확인할 수 있습니다.
KV 캐시가 필요한 이유
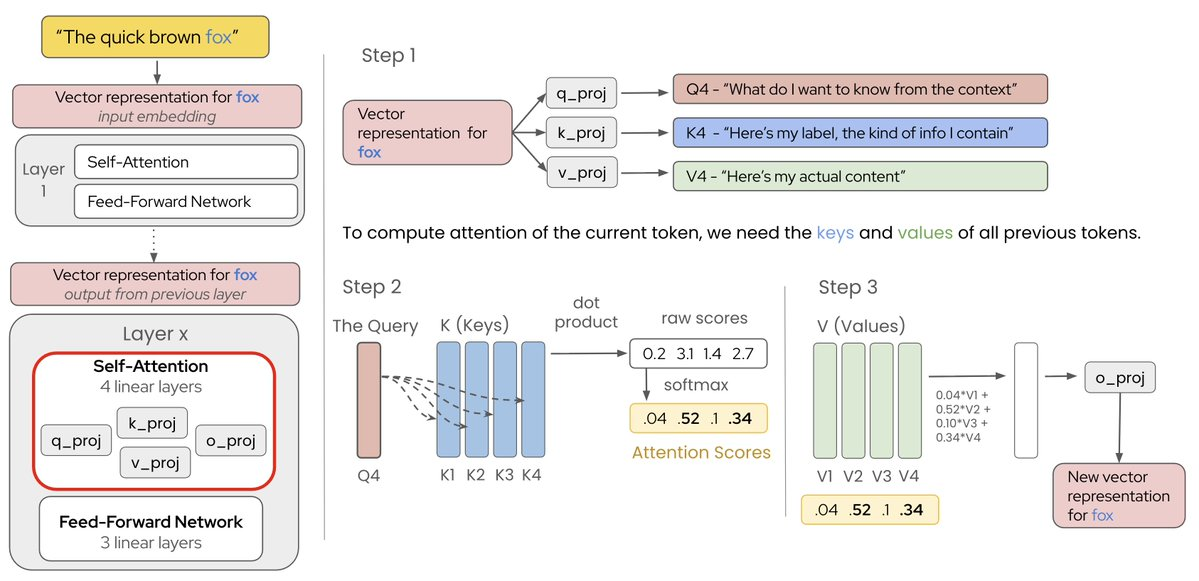
그림 3: 모든 토큰은 각 계층의 어텐션 블록을 통과하면서 자신의 쿼리를 이전의 모든 토큰에 대한 키 및 값과 비교합니다.
각 순전파 과정에서 토큰은 임베딩(수치 표현)이 되어 트랜스포머 계층 스택을 통과하며, 모든 계층에는 토큰들이 서로를 참조하는 셀프 어텐션 블록이 있습니다. 바로 이 지점에서 메모리 문제가 발생하기 시작합니다.
어텐션은 토큰당 3개의 벡터를 계산합니다.
- Q, 쿼리(Query): 해당 토큰이 컨텍스트에서 확인하고자 하는 정보
- K, 키(Key): 해당 토큰이 보유하고 있는 정보의 종류
- V, 값(Value): 해당 토큰의 실제 내용
다음 토큰을 생성하려면 현재 토큰의 쿼리를 지금까지 나온 모든 토큰의 키와 비교하고 값들의 가중합을 계산합니다.
하지만 여기서 중요한 점이 있습니다. 주목해야 할 핵심은 다음과 같습니다. 쿼리는 현재 토큰에만 필요합니다. 키와 값은 전체 히스토리에 필요하지만, 한 번 계산된 후에는 변경되지 않습니다. 4번째 토큰의 키와 값은 5단계에서도 4단계와 동일합니다.
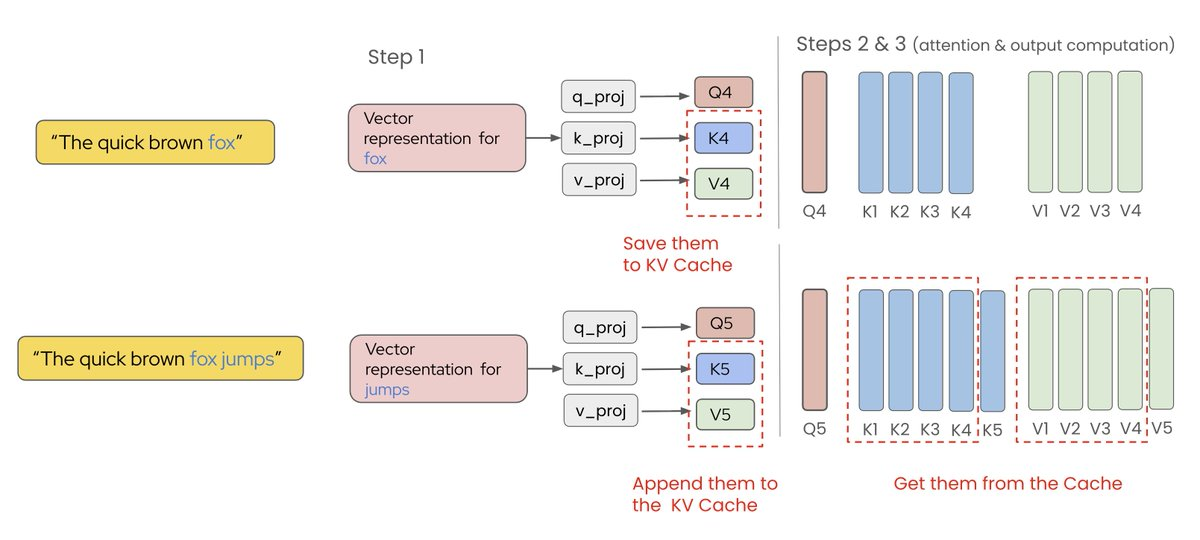
그림 4: 이전 토큰의 키와 값은 변하지 않으므로, 매 단계마다 다시 계산하지 않고 한 번 저장한 후 재사용합니다.
따라서 매 단계마다 재계산하는 대신 GPU 메모리에 저장해 두고 새 토큰에 대한 K와 V만 계산합니다. 이것이 바로 KV 캐시이며, 모델의 N개 계층 전체에서 수행되므로 절감 효과는 N배로 증가합니다.
KV 캐시의 크기는 얼마나 커질까요?
모든 토큰은 각 계층마다 키와 값을 저장해야 하며, 계층당 여러 개의 병렬 세트(KV 헤드)가 존재합니다. 계산 공식은 다음과 같습니다.
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
gpt-oss-120b 모델을 예로 들어보겠습니다. 36개 계층, 8개 KV 헤드, 64차원 헤드 크기, 값당 2바이트. 이는 토큰당 약 72KB에 해당하지만, gpt-oss는 전체 계층의 절반에서만 전체 히스토리를 유지하므로 실제 증가량은 토큰당 약 36KB에 가깝습니다.
- 2k(일반적인 1회 채팅 턴): ~75MB
- 8k(표준 프로덕션 티어): ~300MB
- 32k(긴 문서 또는 코드베이스): ~1.2GB
- 128k(gpt-oss 최대치): ~4.8GB
이 수치는 서빙 효율성을 고려하여 설계된 모델을 기준으로 한 것입니다. 80개 계층과 128차원 헤드를 갖춘 고밀도 70B 모델(예: Llama 3.3 70B)은 토큰당 약 320KB가 필요하며, 동일한 대화에서 9배 더 많은 메모리를 사용합니다. 이러한 이유로 AI 비용을 제어하는 데 있어 모델 아키텍처 선택이 매우 중요합니다.
GPU 예산이 집중 소모되는 영역
gpt-oss-120b와 같은 모델은 단일 NVIDIA H100 80GB GPU에 적합합니다. 모델 출시 당시에는 획기적이었지만, GPU 카드에 가중치를 로드하고 나면 KV 캐시 및 추론 오버헤드를 위한 여유 공간은 약 15~20GB에 불과합니다. 따라서 실제 다수 사용자에게 서비스를 제공하기가 까다로워집니다. 예를 들어:
- 요청이 도달할 수 있는 최대 컨텍스트 길이에 맞춰 요청당 메모리를 미리 예약하는 경우(기존 방식), 실제 사용 여부와 무관하게 모든 요청마다 4.8GB의 메모리가 소모됩니다. 이는 H100 GPU 1대당 단 3명의 동시 사용자만 처리할 수 있음을 의미합니다. 비효율적인 구조입니다.
- 반면 각 요청이 실제로 사용하는 메모리만 동적으로 할당하면 일반적인 8k 요청은 300MB만 차지합니다. 동일한 GPU 카드와 모델에서 50~60명의 사용자를 동시에 처리할 수 있습니다. 동일한 하드웨어에서도 GPU 메모리 관리 방식에 따라 결과가 완전히 달라지므로 이 주제가 매우 중요합니다.
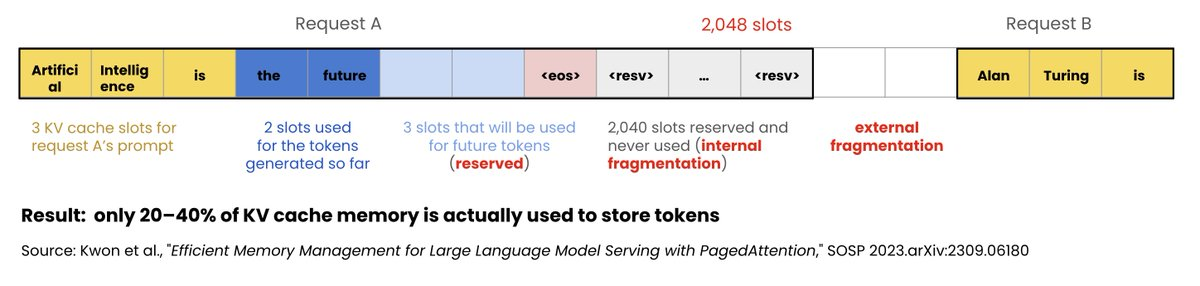
그림 5: 최대 컨텍스트 길이에 맞춰 메모리를 고정 예약하면 KV 캐시 공간의 대부분이 비어 있는 상태로 낭비됩니다.
vLLM과 같은 프로덕션 추론 서버는 이를 어떻게 해결할까요?
주로 다음 3가지 핵심 기법을 활용합니다.
1. PagedAttention
PagedAttention은 KV 캐시를 메모리의 어느 위치에나 배치할 수 있는 작은 고정 크기 블록으로 분할하고, 조회 테이블을 통해 각 요청의 블록 위치를 트랙킹합니다. 실제 사용하지 않을 수도 있는 컨텍스트를 위해 메모리를 사전에 예약하지 않습니다. 운영체제(OS)의 가상 메모리 개념을 다뤄보셨다면 익숙할 것입니다. 바로 그 원리에서 착안한 기술입니다.
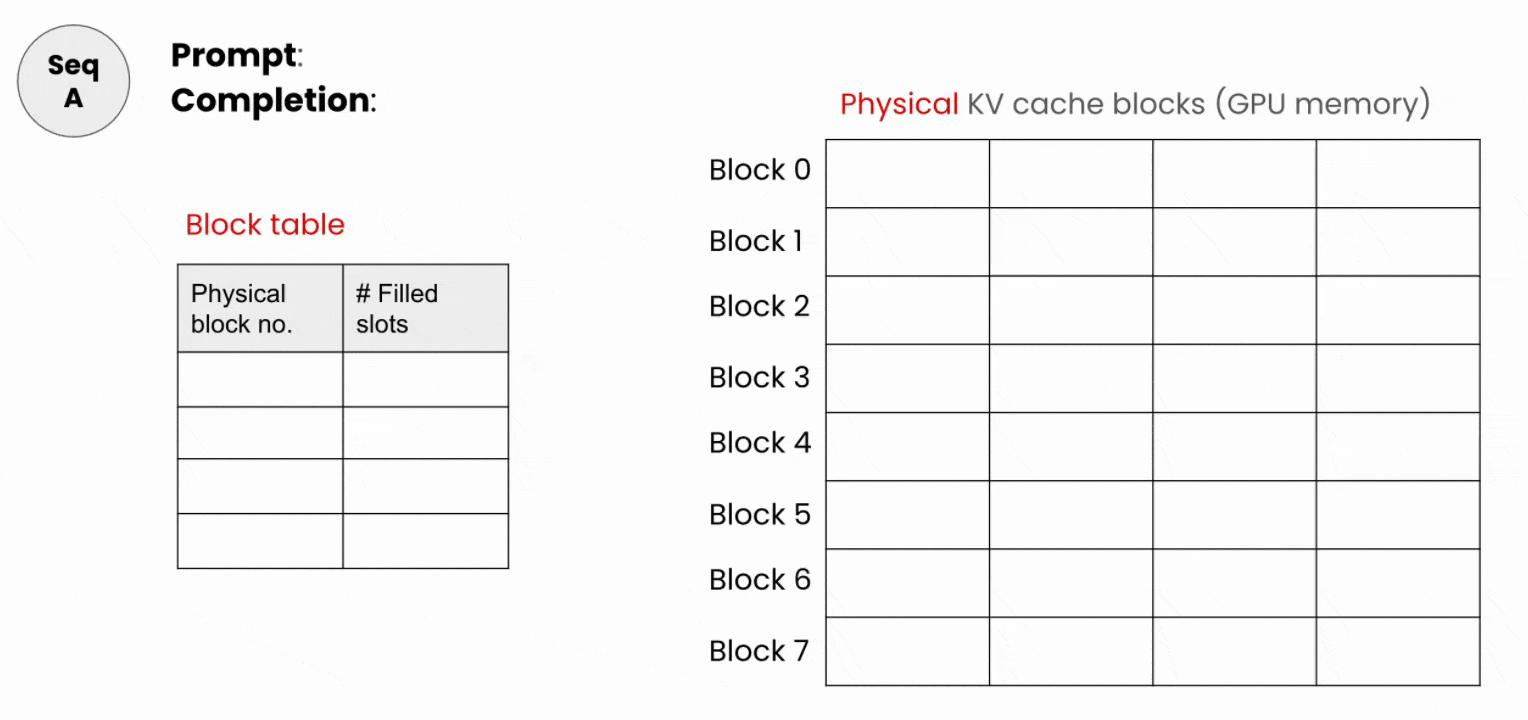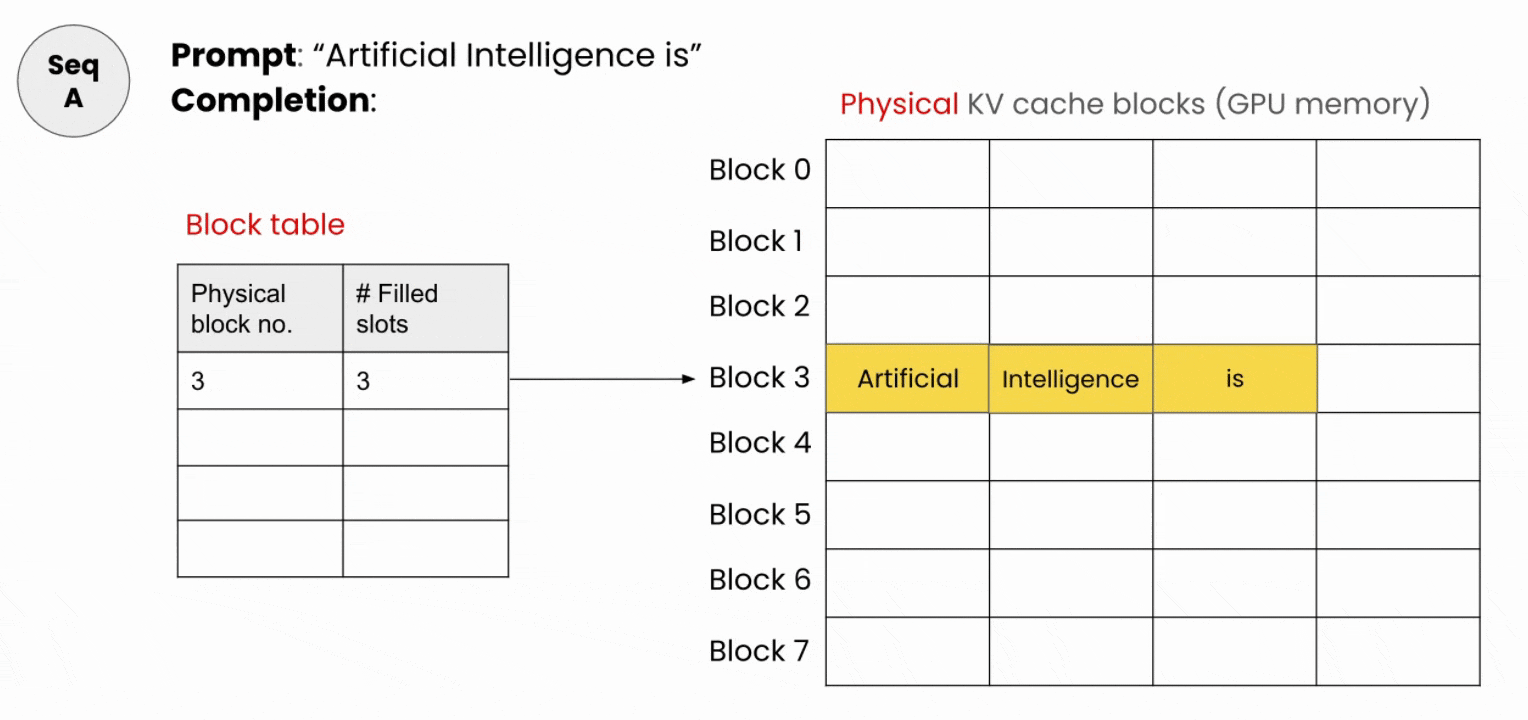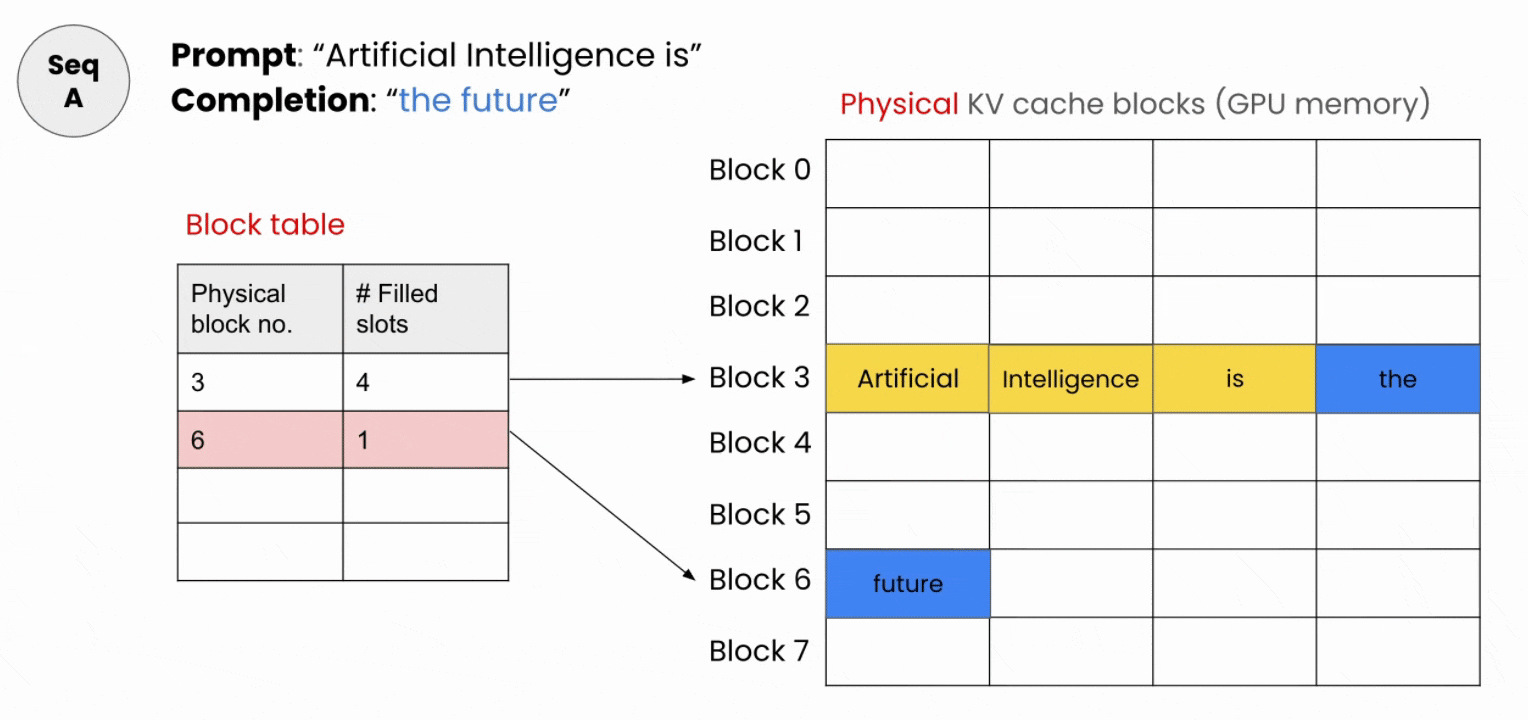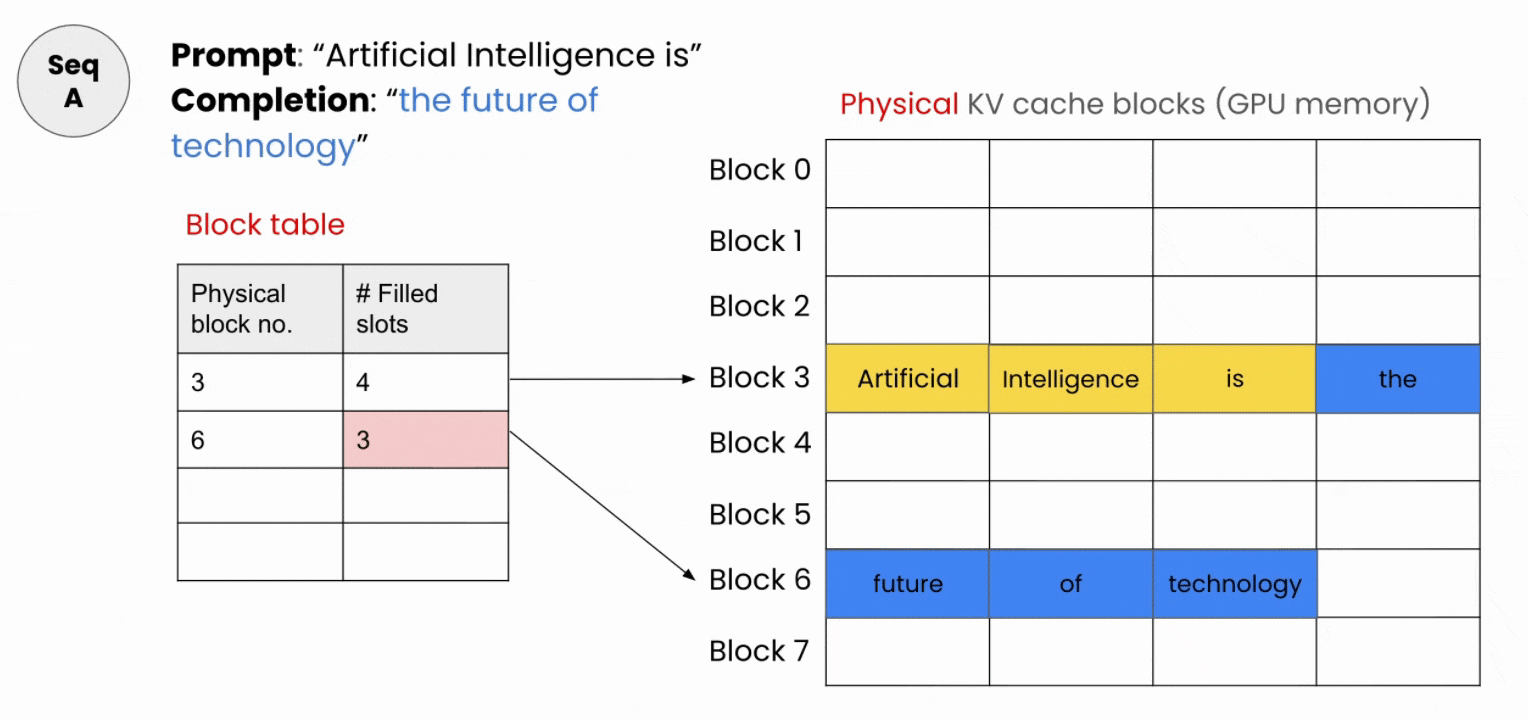
그림 6: PagedAttention은 캐시를 작은 고정 크기 블록으로 분산시키고 룩업 테이블로 트랙킹하므로 사전에 낭비되는 메모리가 없습니다.
2. 연속 배치
연속 배치를 적용하면 전체 배치가 모두 끝날 때까지 기다리지 않고 완료된 요청은 즉시 빠져나가며, 비어 있는 슬롯에 새 요청이 바로 투입됩니다. 이를 통해 GPU를 유휴 시간 없이 가동할 수 있습니다.
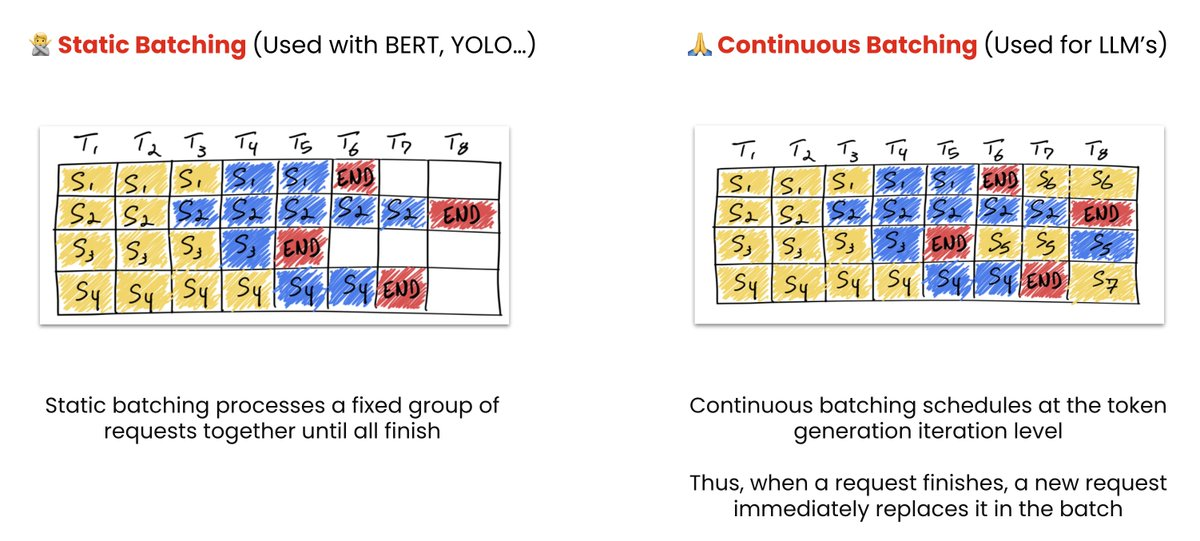
그림 7: 정적 배치는 가장 느린 요청이 끝날 때까지 모든 요청을 대기시키는 반면, 연속 배치는 해제된 슬롯을 즉시 새 요청으로 채웁니다.
3. 프리픽스 캐싱
여러 요청이 동일한 프리픽스(시스템 프롬프트, 검색된 문서, 코딩 에이전트의 컨텍스트에 포함된 동일한 리포지토리 파일 등)를 공유하는 경우, 다시 계산하지 않고 캐시된 K와 V를 재사용합니다.
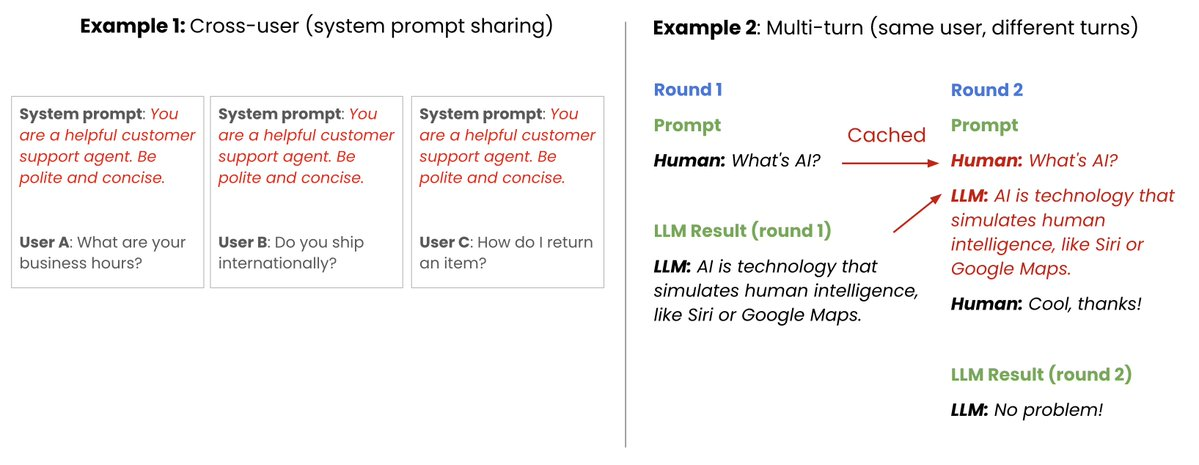
그림 8: 요청들이 동일한 시작 텍스트를 공유할 경우 해당 프리픽스에 대해 이미 수행된 연산 결과를 재사용하여 불필요한 재계산을 방지합니다.
이러한 기법들은 모델 자체를 변경하지 않고도 실행 효율성을 크게 높여줍니다.
모델 크기 자체의 최적화
양자화는 가중치(또는 활성화)를 더 낮은 정밀도로 저장하여 메모리를 적게 사용하고 연산 속도를 높이는 기법입니다. 대부분의 모델은 매개변수당 16비트인 BF16 정밀도로 배포됩니다. 이를 FP8(8비트 부동 소수점)이나 INT8(8비트 정수)로 낮추면 기본 정확도를 유지하면서도 메모리 사용량을 절반으로 줄일 수 있습니다. 4비트까지 낮추면 메모리 사용량이 1/4 수준으로 줄어듭니다. 예를 들어 Red Hat AI Hugging Face 리포지토리의 모든 양자화 모델은 기본 정확도의 99% 이상을 유지합니다.
gpt-oss-120b 모델은 이러한 양자화 작업이 사전에 적용되어 배포된 대표적인 사례입니다. BF16 정밀도의 117B 매개변수 모델은 가중치 크기만 약 234GB에 달해 로드하는 데 80GB GPU가 3대 필요합니다. OpenAI는 MoE(전문가 혼합) 가중치에 MXFP4 양자화를 적용하여 모델을 사후 학습시켰으며, 이를 통해 모델 크기를 80GB 미만으로 줄여 단일 GPU 카드에 탑재할 수 있게 만들었습니다.
- BF16(가상 시나리오): ~234GB → GPU 3대 필요
- MXFP4(실제 배포 기준): 80GB GPU 1대에 탑재 가능
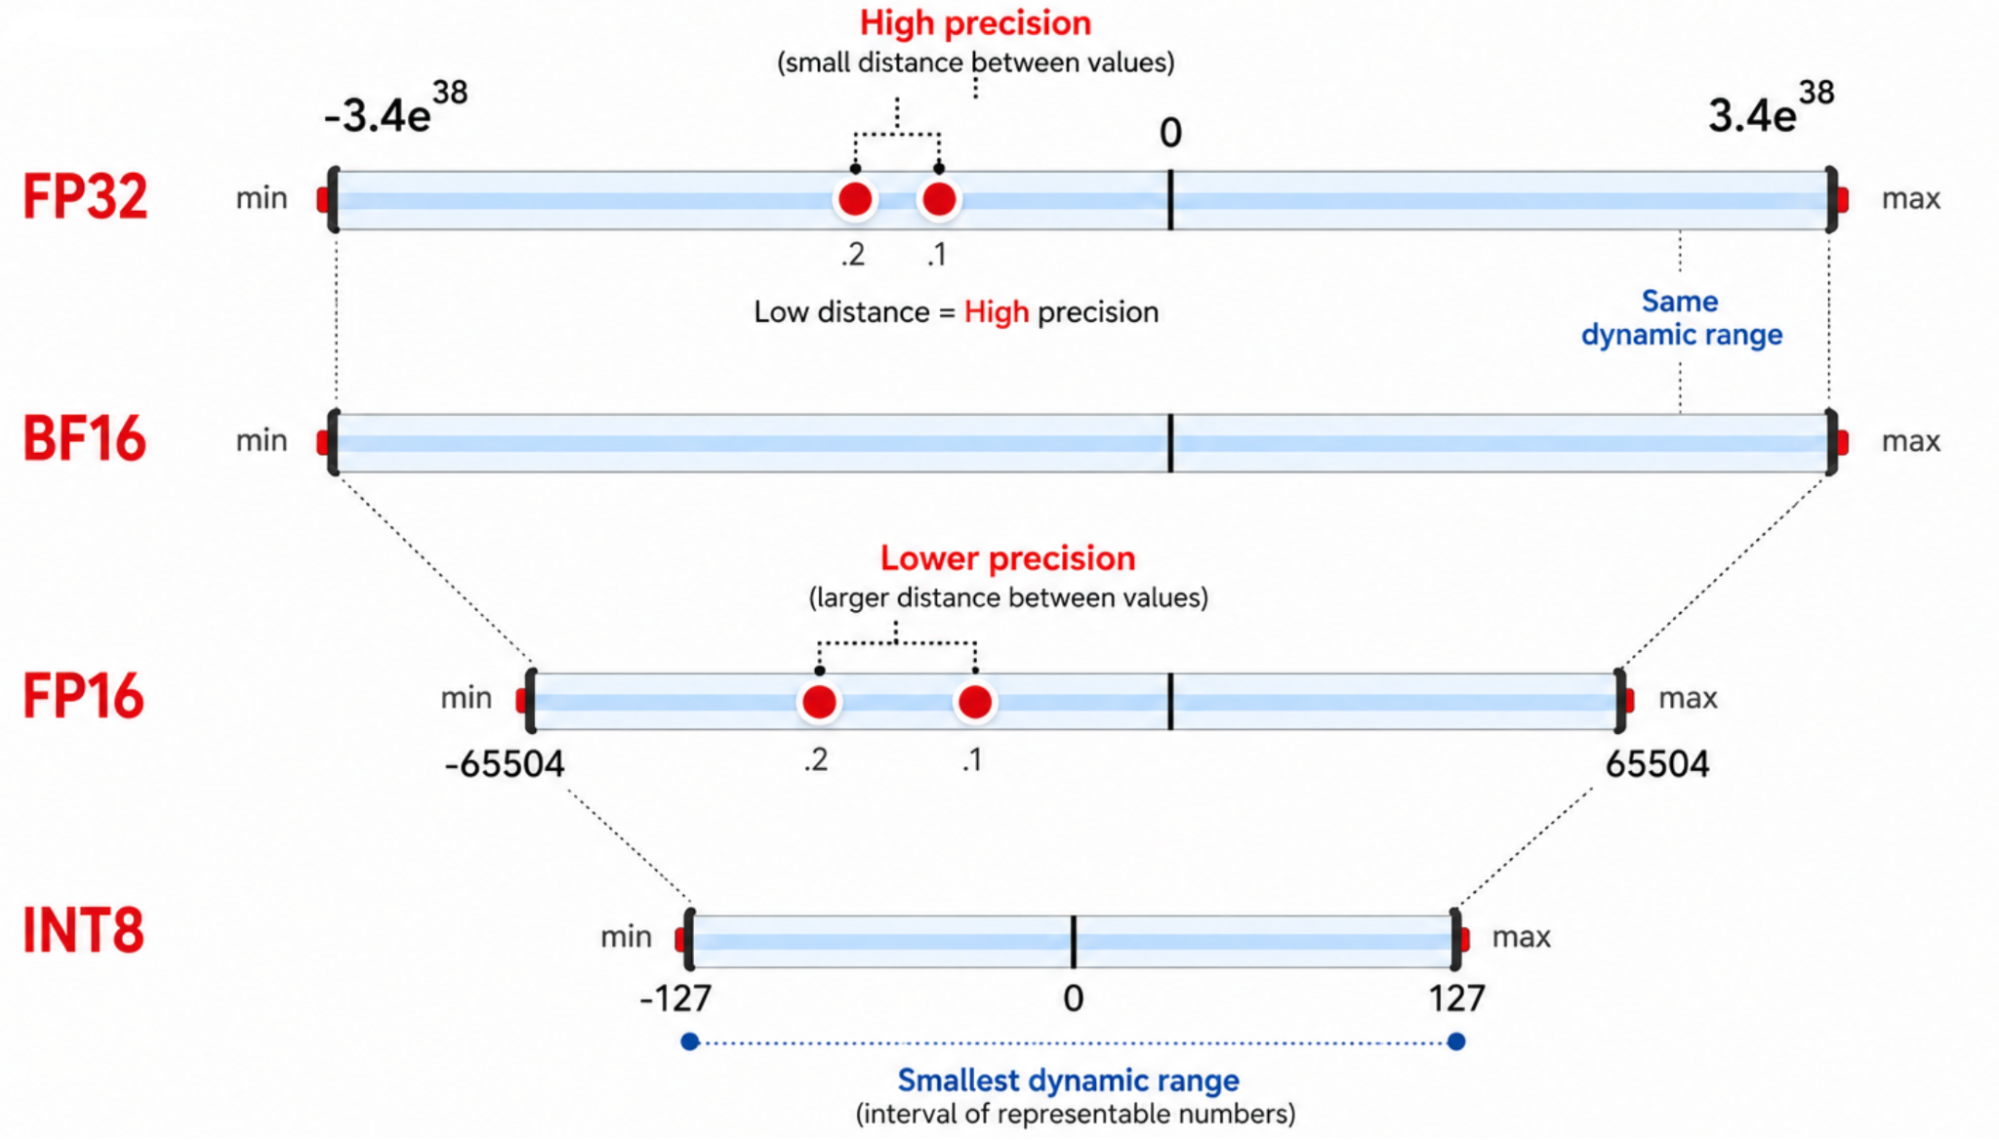
그림 9: 저정밀도 숫자 형식은 표현 범위와 세부 정보를 일부 조정하는 대신 메모리 풋프린트를 대폭 줄여줍니다.
대부분의 모델은 이렇게 사전에 양자화되어 제공되지 않으므로, 직접 양자화를 수행하거나 Red Hat의 HuggingFace 압축 모델을 활용할 수 있습니다. 결과적으로 양자화를 통해 얻을 수 있는 주요 이점은 두 가지입니다. 가중치를 양자화하면 순전파(Forward Pass)가 발생할 때마다 고대역폭 메모리(HBM)에서 정적 랜덤 액세스 메모리(SRAM)로 이동하는 데이터 양이 줄어들어 대기 시간이 단축됩니다. 활성화를 양자화하면 텐서 코어가 저정밀도로 연산을 수행하여 초당 처리할 수 있는 연산량이 늘어나므로 처리량이 향상됩니다. W8A16(가중치 8비트, 활성화 16비트)과 같은 가중치 전용 방식은 전자의 이점을 제공하며, W8A8(가중치 Int8, 활성화 Int8)과 같은 형식은 두 가지 이점을 모두 제공합니다.
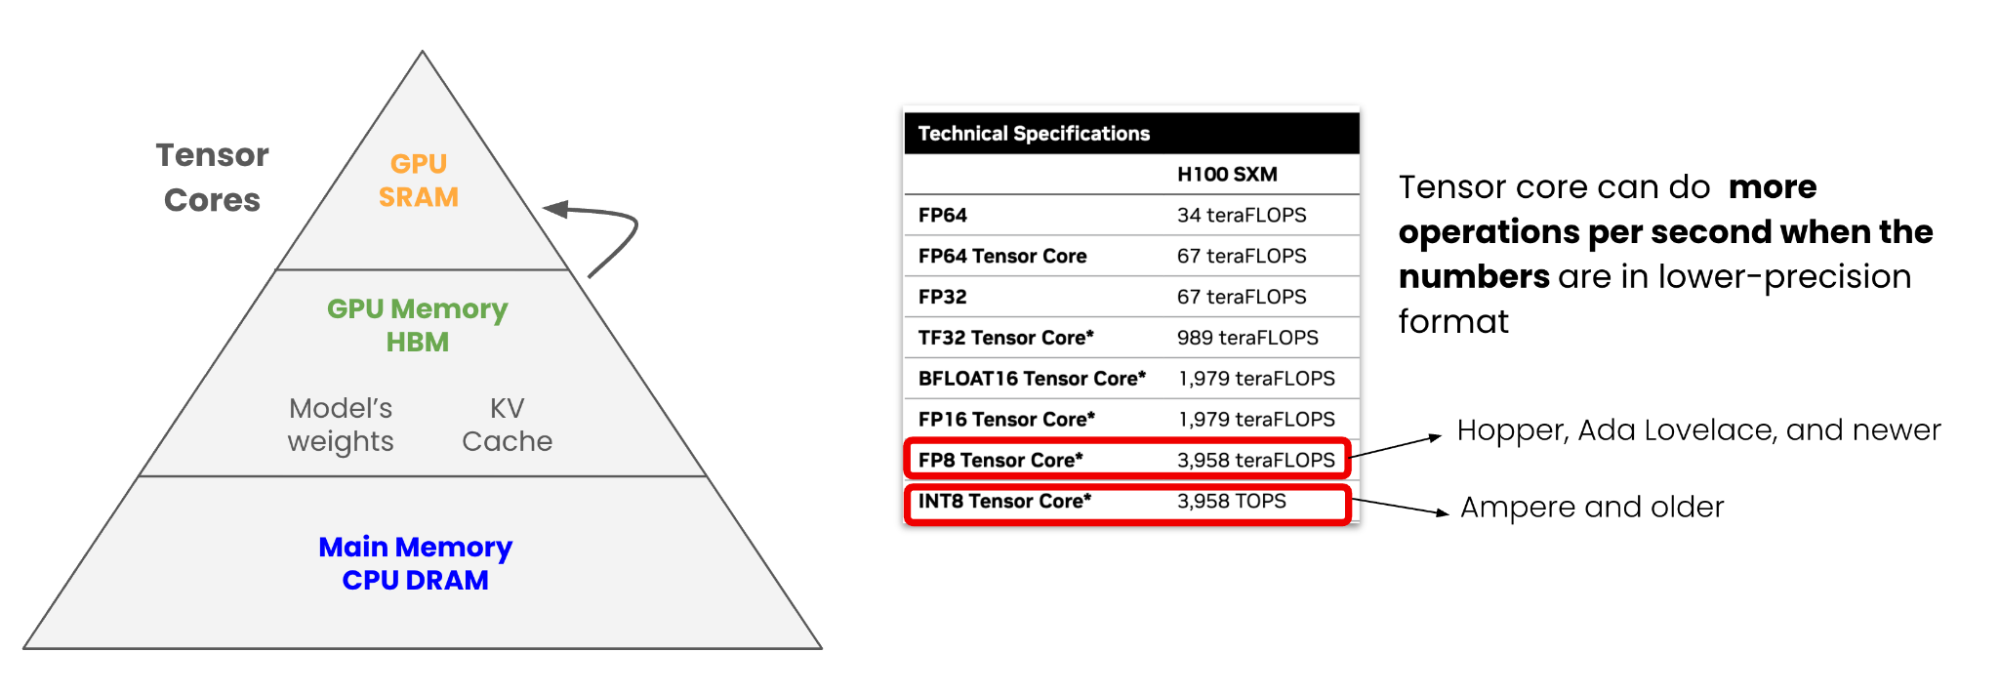
그림 10: 가중치 크기가 작을수록 GPU 내 가장 빠른 메모리로 더 신속하게 이동하며, 텐서 코어에서 저정밀도 연산이 훨씬 높은 처리량으로 실행됩니다.
실제 사례에서 FP8을 적용하면 메모리 요구량을 절반으로 줄이고 정확도 손실을 최소화하면서 처리량을 최대 1.6배까지 높일 수 있습니다. 양자화를 적용한다고 해서 모델의 성능이 저하되는 것은 아닙니다. GPTQ(generalized post-training quantization), AWQ(activation-aware weight quantization), SmoothQuant와 같은 보정 기술은 소규모 대표 데이터세트를 사용하여 가장 중요한 가중치를 선별하고 보호하므로 품질 저하는 일반적으로 1% 미만에 그칩니다.
AI 모델 최적화 요약표
기술 | 적용 단계 | 주요 이점 |
PagedAttention | 런타임 | 동일 메모리 내 동시 요청 처리 수 증가 |
연속 배치 | 런타임 | 요청 간 GPU 가동 상태 유지 |
프리픽스 캐싱 | 런타임 | 공유 컨텍스트에서 재계산 생략 |
양자화(Quantization) | 모델, 배포 전 (Pre-deploy) | GPU 수량 절감, 로딩 및 연산 속도 향상 |
희소화 (Sparsification) | 모델, 배포 전 (Pre-deploy) | 중요도가 가장 낮은 가중치를 연산에서 제외 |
교육은 일회성 비용이지만 추론은 지속적으로 발생하는 반복 비용이며 전체 비용의 대부분을 차지합니다. 모든 토큰 생성은 하나의 완전한 순전파(Forward Pass) 과정을 거칩니다. KV 캐시는 컨텍스트 길이와 동시 사용자 수가 증가함에 따라 함께 증가하므로, 이를 효율적으로 관리하는 것이 추론 서버의 핵심 역할입니다. 본 예시에서 볼 수 있듯이 동일한 GPU에서 기본 설정 배포와 최적화 배포 간의 동시 사용자 처리 능력은 3명 대 50명으로 큰 차이를 보입니다. 추론을 최적화하면 이미 보유하고 있는 하드웨어 리소스를 훨씬 더 효율적으로 활용할 수 있습니다.
추신: 이 글이 유용하셨다면 다음도 확인해 보세요!
직접 실습해 보실 수 있도록 DeepLearning.AI 및 Red Hat이 협력하여 DeepLearning.AI 핸즈온 무료 교육 과정을 마련했습니다: LLM Compressor로 Qwen 모델을 양자화하고 정확도 절충안을 측정한 뒤, vLLM으로 서빙하고, GuideLLM으로 벤치마킹하며, lm-eval로 평가해 보세요: Fast & Efficient LLM Inference with vLLM
리소스
AI 추론 시작하기
저자 소개
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
채널별 검색

오토메이션
기술, 팀, 인프라를 위한 IT 자동화 최신 동향

인공지능
고객이 어디서나 AI 워크로드를 실행할 수 있도록 지원하는 플랫폼 업데이트

오픈 하이브리드 클라우드
하이브리드 클라우드로 더욱 유연한 미래를 구축하는 방법을 알아보세요

보안
환경과 기술 전반에 걸쳐 리스크를 감소하는 방법에 대한 최신 정보

엣지 컴퓨팅
엣지에서의 운영을 단순화하는 플랫폼 업데이트

인프라
세계적으로 인정받은 기업용 Linux 플랫폼에 대한 최신 정보

애플리케이션
복잡한 애플리케이션에 대한 솔루션 더 보기

가상화
온프레미스와 클라우드 환경에서 워크로드를 유연하게 운영하기 위한 엔터프라이즈 가상화의 미래
