
As organizações dos setores de ensino superior e empresarial enfrentam custos crescentes de virtualização, mudanças nas estruturas de licenciamento e decisões arquitetônicas que não podem mais ser adiadas. Nesse cenário, os líderes de TI precisam de um caminho de migração de baixa disrupção que proteja cargas de trabalho críticas hoje e estabeleça uma base de nuvem híbrida moderna para o futuro.
No Red Hat Summit 2026, Joseph Seegmiller, Engenheiro de Infraestrutura da Universidade Brigham Young, se uniu aos Arquitetos de Soluções da Red Hat John Quigley e John Call para enfrentar exatamente esses desafios. Ao utilizar o Red Hat OpenShift para executar máquinas virtuais (VMs) e containers lado a lado, a Universidade Brigham Young consolidou sua infraestrutura e simplificou suas operações.
Acabamos decidindo migrar toda a nossa virtualização para o Red Hat OpenShift Virtualization. Migramos 1.500 máquinas virtuais em apenas seis semanas.
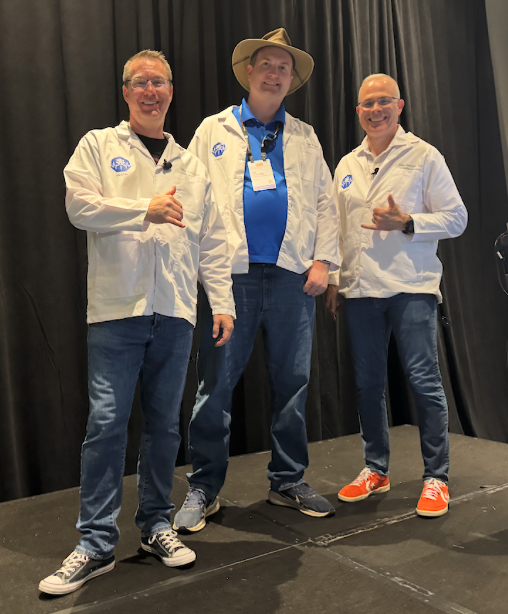
Figura 1. Joseph Seegmiller, Engenheiro de Infraestrutura da Universidade Brigham Young, subiu ao palco ao lado dos Arquitetos de Soluções da Red Hat John Quigley e John Call.
Embora a migração rápida seja um marco significativo, manter a alta disponibilidade e proteger as cargas de trabalho de banco de dados stateful após a transição para a nova plataforma é a principal prioridade para as equipes de infraestrutura.
O risco subjacente de corrupção de dados em ambientes de armazenamento compartilhado
Para desenvolver uma plataforma resiliente, os líderes de TI devem entender como o Red Hat OpenShift lida com falhas de nó diferentemente dos hipervisores tradicionais. Por padrão, quando um nó que executa VMs ou cargas de trabalho em containers para de responder, ele não reagenda instantaneamente as cargas de trabalho afetadas. Esse atraso é uma funcionalidade de segurança intencional projetada para proteger a integridade dos dados.
Em um ambiente de armazenamento compartilhado, um cenário de split-brain representa uma grande ameaça. Se um nó perder a comunicação com o control plane do cluster, mas permanecer ligado, ele ainda poderá gravar dados no disco.
Se um nó perder a conectividade de rede, mas sua conexão Fibre Channel permanecer ativa, as máquinas virtuais continuarão em execução e gravando no disco. O reagendamento automático dessa máquina virtual em um novo nó monta o disco duas vezes, causando corrupção grave de dados. É por isso que a reinicialização e o fencing automatizados dos nós são necessários.
Sem a correção automatizada, a resolução dessas falhas exige intervenção manual. Um operador deve verificar se o nó com falha está completamente offline antes de encerrar com segurança a instância da VM antiga e iniciar uma nova. Em um ambiente grande, esse processo manual gera atrasos significativos na recuperação.
A interrupção transformou os dashboards da nossa equipe de operações em uma árvore de Natal, repleta de luzes piscando. Levamos duas horas para resolver. Se tivéssemos implementado essas estratégias de correção de nó, o sistema teria resolvido o problema em minutos, em vez de horas.
Recuperação automatizada em minutos com o Medik8s
Para eliminar a correção manual e reduzir o downtime de horas para minutos, o Red Hat OpenShift integra o framework de operadores Medik8s. Esse framework oferece correção automatizada de nós e alta disponibilidade para cargas de trabalho, incluindo VMs.
O processo de recuperação automatizada opera por meio de três componentes distintos:
- Operador Node Health Check: esse componente atua como um detector de fumaça do cluster. Ele monitora continuamente o status dos nós de trabalho. Se um nó relatar uma condição NotReady ou Unknown pela duração configurada (60 segundos é o padrão), o operador emite um alarme e aciona um template de correção.
- Fence Agents Remediation (FAR): esse é o método de fencing baseado em energia mais rápido. Ele interage diretamente com as interfaces do controlador de gerenciamento de placa-base (BMC) do hardware físico, como Dell iDRAC ou HPE iLO, usando a API Redfish comum. O agente comanda o BMC para reinicializar o hardware. Após o BMC confirmar o ciclo de energia, o cluster exclui com segurança as cargas de trabalho de container e VM travadas e as reagenda em nós íntegros, concluindo o processo em aproximadamente 155 segundos.
- Self Node Remediation (SNR): atuando como um fallback confiável baseado em software, esse agente usa um watchdog no nível do kernel. O agente deve interagir com o timer de watchdog a cada 30 segundos. Se o agente detectar que o nó está isolado de seus pares e do servidor da API, ele interrompe a redefinição do timer do watchdog (ou "acariciar o watchdog", no jargão do administrador de sistema). Em seguida, o watchdog atinge o tempo-limite e força o sistema operacional local a reinicializar sozinho, liberando os bloqueios de armazenamento com segurança.
Ao implantar essas estratégias, as equipes de infraestrutura protegem as VMs contra a corrupção de dados enquanto realizam a recuperação automaticamente, sem intervenção humana.
Rebalanceie cargas de trabalho ativas usando a pressão real de recursos
Alcançar a alta disponibilidade exige mais do que apenas sobreviver a falhas de nós. Também exige uma distribuição proativa de cargas de trabalho para evitar que os nós fiquem sem recursos.
O scheduler padrão do Kubernetes só avalia as decisões de posicionamento de recursos na inicialização de uma VM. À medida que os usuários fazem login ou executam tarefas intensivas, determinadas VMs podem usar mais recursos do que o inicialmente solicitado, levando ao esgotamento de recursos em nós específicos.
Para resolver esse desbalanceamento, o operador Descheduler avalia periodicamente o cluster. Em vez de depender apenas de solicitações de recursos estáticas e pré-alocadas, o Descheduler pode aproveitar os dados de consumo de recursos em tempo real fornecidos pela interface Pressure Stall Information (PSI) do kernel.
As métricas do PSI rastreiam o tempo que as VMs ou os containers passam esperando por recursos de CPU, memória ou disco (E/S). Se o Descheduler detectar um nó sofrendo pressão de recursos, ele identifica as VMs qualificadas e inicia uma migração simultânea para movê-las para nós subutilizados. Esse rebalanceamento proativo mantém o desempenho consistente das aplicações em toda a frota.
Modernize sua estratégia de infraestrutura
Migrar para uma plataforma de aplicações de nuvem híbrida unificada ajuda as organizações a controlar os custos operacionais, eliminar silos de infraestrutura e estabelecer um ambiente seguro para o desenvolvimento de aplicações modernas. Ao combinar o Red Hat OpenShift Virtualization com correção automatizada e rebalanceamento proativo de cargas de trabalho, os líderes de TI podem entregar alta disponibilidade previsível para suas cargas de trabalho mais críticas.
Avance para a próxima etapa na sua jornada de modernização da virtualização:
Gere um relatório automatizado sobre a maturidade para a migraçãoPágina disponível no idioma inglês (Portuguese, Brazil não disponível) : avalie instantaneamente a maturidade para migração das suas cargas de trabalho do VMware com o OpenShift migration advisor gratuito.- Faça o download do guia de arquitetura: acesse instruções passo a passo, modelos de arquitetura e práticas recomendadas para migrar para o Red Hat OpenShift Virtualization.
- Assista a demonstrações interativas: veja o Red Hat OpenShift Virtualization em ação e aprenda a gerenciar VMs e containers em um único console unificado.
Recurso
15 motivos para adotar o Red Hat OpenShift Virtualization
Sobre o autor
Debbie Margulies is a principal product marketing manager for Red Hat OpenShift and has been at Red Hat since 2019 through the acquisition of StackRox.
Mais como este
Por que continuar postergando a decisão pela virtualização?
Gerencie máquinas virtuais no Red Hat OpenShift com Service Mesh
Virtualization Is (Still) King | Compiler
Navegue por canal

Automação
Últimas novidades em automação de TI para empresas de tecnologia, equipes e ambientes

Inteligência artificial
Descubra as atualizações nas plataformas que proporcionam aos clientes executar suas cargas de trabalho de IA em qualquer ambiente

Nuvem híbrida aberta
Veja como construímos um futuro mais flexível com a nuvem híbrida

Segurança
Veja as últimas novidades sobre como reduzimos riscos em ambientes e tecnologias

Edge computing
Saiba quais são as atualizações nas plataformas que simplificam as operações na borda

Infraestrutura
Saiba o que há de mais recente na plataforma Linux empresarial líder mundial

Aplicações
Conheça nossas soluções desenvolvidas para ajudar você a superar os desafios mais complexos de aplicações

Virtualização
O futuro da virtualização empresarial para suas cargas de trabalho on-premise ou na nuvem
