-
Soluções e documentação Red Hat AI
Uma plataforma de soluções e serviços para desenvolvimento e implantação de IA na nuvem híbrida.
Red Hat AI Enterprise
Crie, desenvolva e implante aplicações com tecnologia de IA na nuvem híbrida.
Red Hat AI Inference
Otimize o desempenho do modelo com um stack integrado e realize inferência rápida, consistente e econômica em grande escala.
Red Hat Enterprise Linux AI
Desenvolva, teste e execute modelos de IA generativa para impulsionar aplicações empresariais.
Red Hat OpenShift AI
Desenvolva e implante modelos e aplicações com IA em grande escala em ambientes híbridos.
-
Aprenda Básico
Por que escolher o Red Hat AI
-
Parceiros de IA
A importância da inferência de IA
Não existe IA sem inferência. Ela é a base da IA generativa.
A boa notícia é que sabemos o potencial de sucesso disso. O desafio é: como fazer isso em larga escala?
Vamos detalhar como escalar a inferência de IA com ferramentas open source, como o vLLM e o llm-d.
Por que a inferência é tão importante?
A inferência é a etapa final, quando um modelo entrega o resultado desejado. Ela é uma função essencial para o sucesso de uma IA.
Por isso, o hardware e o software que viabilizam a inferência podem determinar o sucesso ou o fracasso da sua estratégia de IA.
A arquitetura com mais opções de escalabilidade é a baseada em tecnologia open source.
O que está limitando sua capacidade de escalar?
Sabemos que a IA funciona. O desafio é fazer a escalar por toda a empresa.
Quando você faz isso, os modelos exigem mais dados e memória. É quando o hardware e os aceleradores têm dificuldade de acompanhar o ritmo.
Um provedor de terceiros parece ser a solução mais fácil. Mas os custos do token aumentam rapidamente e, às vezes, excedem a própria aplicação de IA.
40%
Até 2030, a inferência será a carga de trabalho dominante nos data centers de IA e deverá consumir até 40% da demanda total do data center.1
Como aprimorar a inferência de IA?
Ao otimizar a inferência na arquitetura open source, é possível executar modelos de IA com mais rapidez e inteligência.
As estratégias de otimização incluem:
- Compactação de modelos com a quantização
- Processamento de GPUs com mais eficiência
- Decodificação especulativa
- Inferência distribuída
- Delegação de tarefas de memória e orquestração às CPUs
Otimizações como essas ajudam a manter a inferência de IA com custo eficiente, permitindo que ela escale à medida que suas equipes evoluem.
19%
De economia de custos em grande escala ao usar técnicas de decodificação especulativa.2
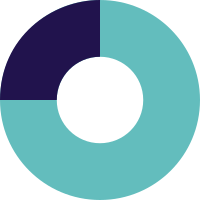
2x
mais capacidade de processamento com modelos comprimidos, sem comprometer a precisão.3
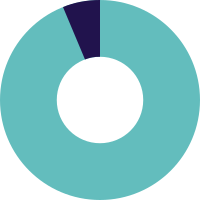
90%
De latência total de ponta a ponta atribuída às CPUs. 4
Como o vLLM otimiza a inferência?
Otimizar os modelos é só parte do problema. Você também precisa de um mecanismo de inferência de alto desempenho. É aí que o vLLM pode ajudar.
Os sistemas tradicionais de gerenciamento de memória para LLMs não organizam os recursos de forma eficiente, o que afeta o desempenho. O vLLM utiliza o PagedAttention, técnica que identifica valores de chave repetidos para eliminar o processamento redundante.
Isso permite que o vLLM faça um uso melhor da memória da GPU e acelere a inferência de IA generativa. Ele amplia a taxa de processamento, medida em tokens processados por segundo, para atender vários usuários simultaneamente.
O uso mais eficiente de aceleradores permite que os modelos executem mais cálculos em menos tempo, ampliando a capacidade de atender mais usuários e agentes.
75%
Dos requisitos de memória reduzidos, diminuindo as GPUs necessárias.5
4x
Tokens por segundo processados em comparação com a maioria dos provedores de inferência.6
24x
mais desempenho de processamento com o vLLM em comparação aos concorrentes.7
Por que o vLLM está tão em alta?
O vLLM ajudou a responder aos principais desafios de utilização eficiente das GPUs, reduzindo o custo por token e oferecendo latência estável em grande escala. Tudo isso com uma implantação portátil e aberta.
Com suporte de Dia 0 para todos os principais modelos e aceleradores, sua acessibilidade é interessante para os setores empresariais e acadêmicos. Por isso a comunidade do vLLM é tão ativa e dinâmica.
As contribuições surgem do Hugging Face, UC Berkeley, NVIDIA, Red Hat e muitos outros. A comunidade testa continuamente os limites do software e o aprimora no projeto open source.
+ de 10 mil
commits* do vLLM no GitHub (um aumento de mais de 200%) em 2026.
A comunidade do vLLM hoje
+ de 500 mil
GPUs implantadas em tempo integral8
+ de 200
tipos de aceleradores9
+ de 500
modelos de arquitetura compatíveis9
+ de 3,1 mil
Qual é o papel da inferência distribuída?
A inferência distribuída permite que modelos de IA dividam a execução da inferência entre um conjunto de dispositivos interconectados.
Quando um modelo consegue atender diferentes solicitações ao mesmo tempo, reduz significativamente a necessidade de hardware e aumenta a eficiência da inferência.
A inferência distribuída usa técnicas como paralelismo de tensores, programação inteligente de inferência e desagregação. Quando combinado ao vLLM, a inferência se torna altamente eficiente e capaz de lidar com múltiplas tarefas simultaneamente.
Isso ajuda a mantê-la observável, escalável e consistente.
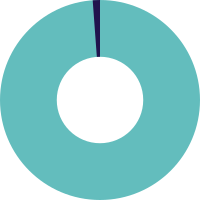
99%
Menos tempo até o primeiro token (TTFT) sob carga equivalente.10
Existe uma comunidade open source para isso?
Sim, e é chamada de llm-d.
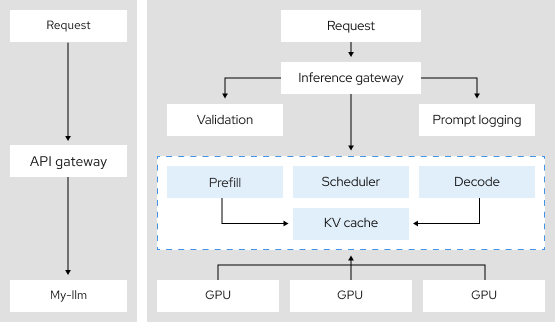
O llm-d é um framework open source que oferece aos desenvolvedores um modelo para criar inferência distribuída em grande escala.
Sua arquitetura modular atende às demandas complexas de recursos de LLMs avançados e substitui processos manuais e fragmentados por fluxos integrados e bem definidos, reduzindo o tempo entre o piloto e a produção.
O llm-d traz a inferência para o Kubernetes, oferecendo ferramentas padronizadas para aplicar a inferência distribuída aos seus casos de uso empresariais exclusivos.
2x
Mais usuários no mesmo hardware com clusters otimizados para llm-d.11
Mais recursos de IA
Red Hat AI Inference
Acelere a implantação dos seus LLMs em produção.
Baseado no vLLM, nosso mecanismo de inferência empresarial oferece mais velocidade sem afetar o desempenho.
Escale na nuvem híbrida com o modelo de gen AI otimizado de sua preferência, em qualquer acelerador de IA e em qualquer ambiente de nuvem.

Fontes citadas
[1] “The future of AI workloads.” McKinsey & Company, 24 de fevereiro de 2026.
[2] Umesh, Harshith. "Performance improvements with speculative decoding in vLLM for gpt-oss.", Red Hat Developer Blog, 16 de abril de 2026.
[3] Kurtić, Eldar, et al. “2:4 Sparse Llama: Smaller models for efficient GPU inference.”, Blog Red Hat Developer , 28 de fevereiro de 2025.
[4] Bowerman, Sawyer. Ableidinger, Grace. "A CPU está de volta: reavalie a divisão entre CPU e GPU na inferência de LLMs." Blog da Red Hat, 6 de agosto de 2026.
[5] "What is LLM Compressor?", documentos do vLLM.
[6] "vLLM Tops the Artificial Analysis Leaderboard.", blog do vLLM, 11 de maio de 2026.
[7] Kwon, Woosuk, et al. “vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention.” Blog do vLLM, 20 de junho de 2023.
[8] Goin, Michael. “[vLLM Office Hours #38] vLLM 2025 Retrospective & 2026 Roadmap - December 18, 2025.”, YouTube, 8 de dezembro de 2025.
[9] Kwon, Woosuk. “Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale.”, X, 26 de janeiro de 2026.
[10] Singh, Naina. "As mesmas 16 GPUs, o dobro de usuários: roteamento com reconhecimento de inferência para clusters de LLM", Blog da Red Hat, 27 de maio de 2026.
[11] Singh, Naina. "As mesmas 16 GPUs, o dobro de usuários: roteamento com reconhecimento de inferência para clusters de LLM", Blog da Red Hat, 27 de maio de 2026.
