Si usas modelos de lenguaje de gran tamaño (LLM) o desarrollas a partir de ellos, quizás el concepto más importante que debes comprender sea cómo funcionan la inferencia y la memoria caché de clave-valor (KV). Esto se debe a que, independientemente de si trabajas con agentes de programación, generación aumentada por recuperación (RAG) o perfeccionamiento, la inferencia es lo que sucede cada vez que realizas una solicitud a un modelo y obtienes una respuesta (y, por lo tanto, adónde va todo el dinero).
Mientras que el entrenamiento se realiza una sola vez, la inferencia ocurre cada vez que un usuario envía una petición. Por lo tanto, veamos cómo funciona, qué es la memoria caché de KV y las optimizaciones que la mayoría de los equipos usa para ahorrar en costos de infraestructura y reducir la latencia.
La inferencia es un stack, no un archivo de modelo
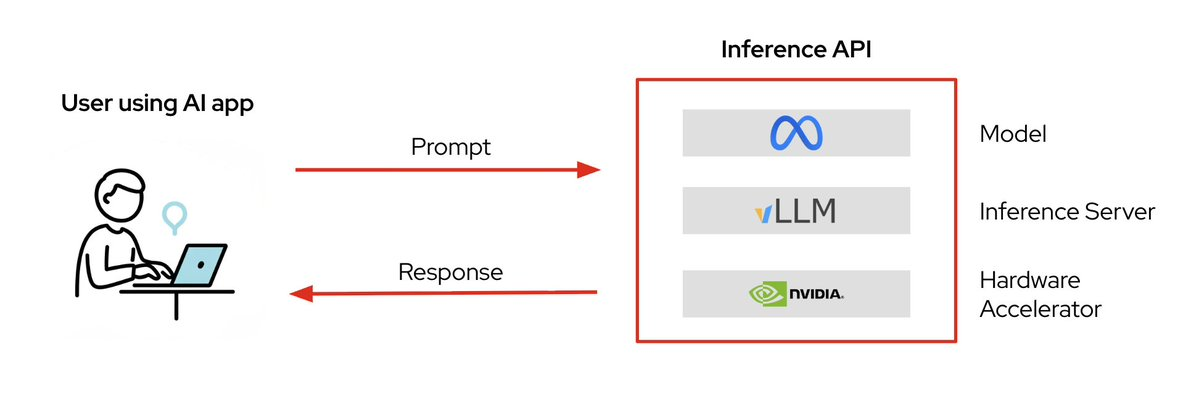
Figura 1: Para servir un modelo, se necesitan 3 elementos que trabajen en conjunto: los pesos, un servidor de inferencia y el hardware subyacente.
Un modelo alojado en tu equipo (o HuggingFace) todavía no presta servicio a nadie. Para que la inferencia sea posible, necesitas 3 elementos que funcionen en conjunto:
- Pesos del modelo: Los archivos con los miles de millones de parámetros aprendidos: Kimi, GLM, Qwen o el que hayas elegido.
- Servidor de inferencia: Software como vLLM, que carga el modelo, gestiona las solicitudes entrantes y se encarga de las optimizaciones que abordaremos a continuación.
- Acelerador de hardware: Por lo general, una GPU, que se encarga del trabajo numérico pesado.
Puedes omitir la capa intermedia y ejecutar un modelo directamente en una GPU con PyTorch. Eso funciona bien para un notebook o un solo usuario. Sin embargo, en el momento en que necesitas atender a muchas personas a la vez, el servidor de inferencia es lo que permite usar la GPU a escala de producción (piensa en abrir un archivo HTML localmente frente a servirlo mediante el servidor HTTP Apache).
Los modelos generan un token a la vez
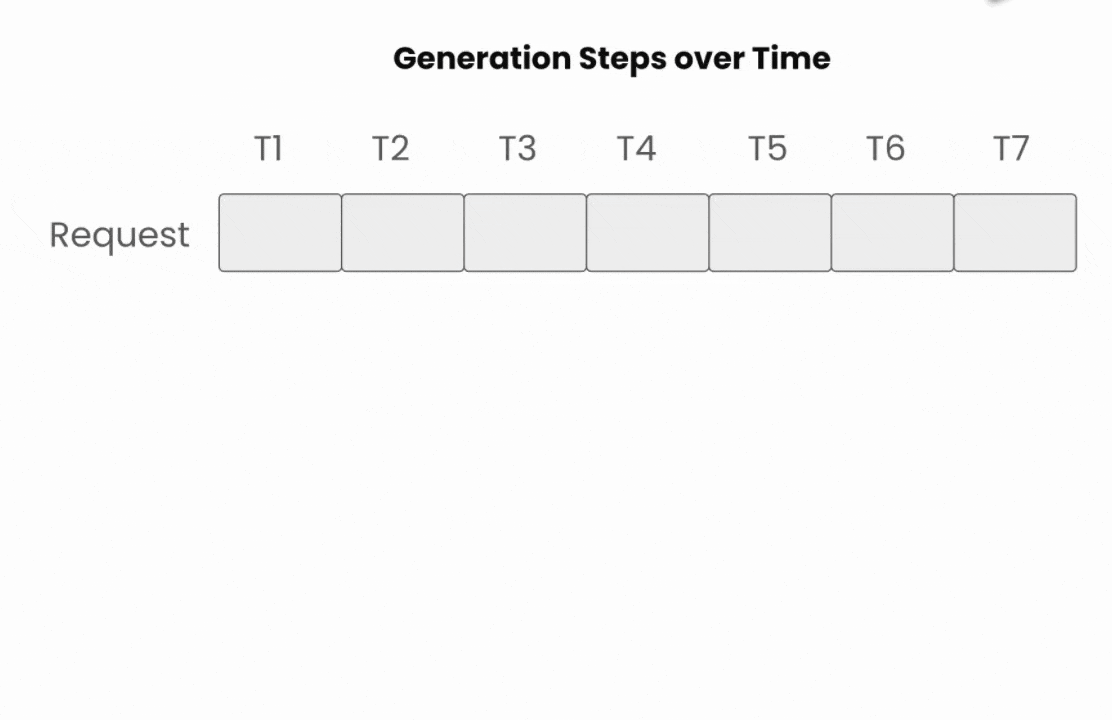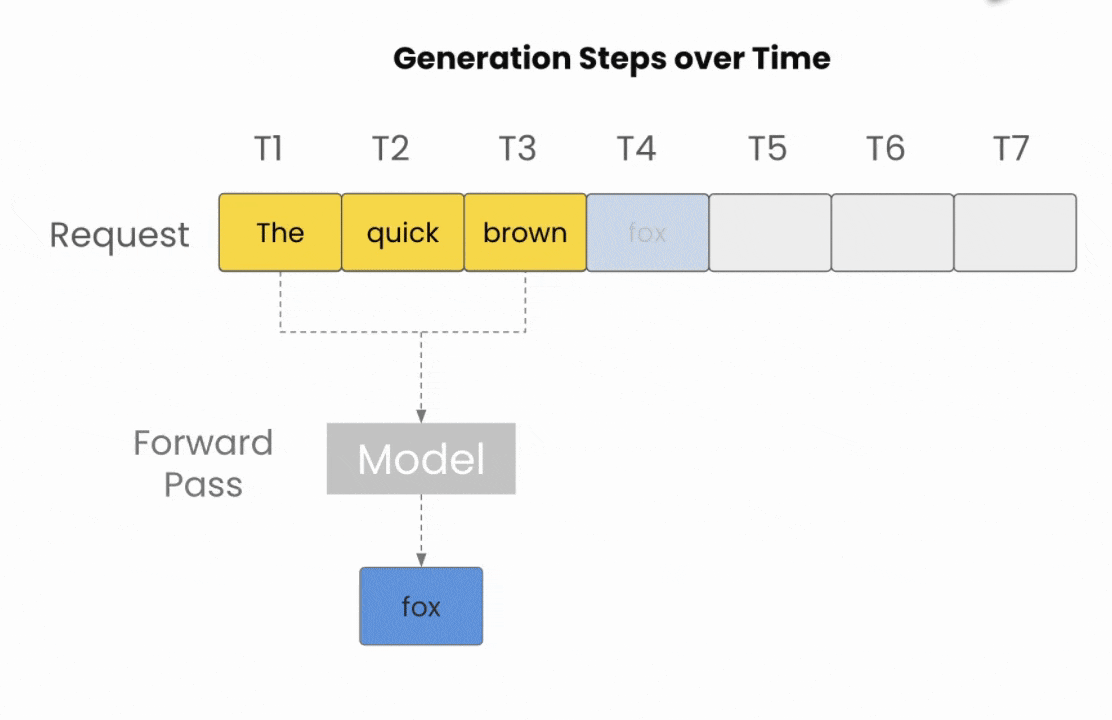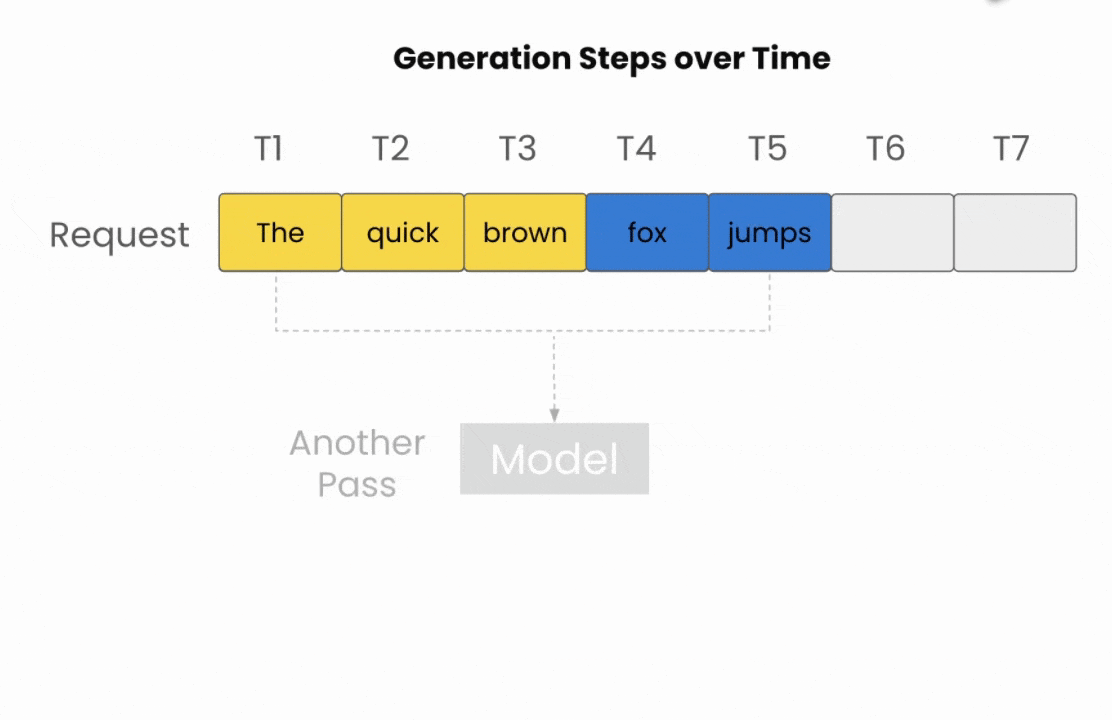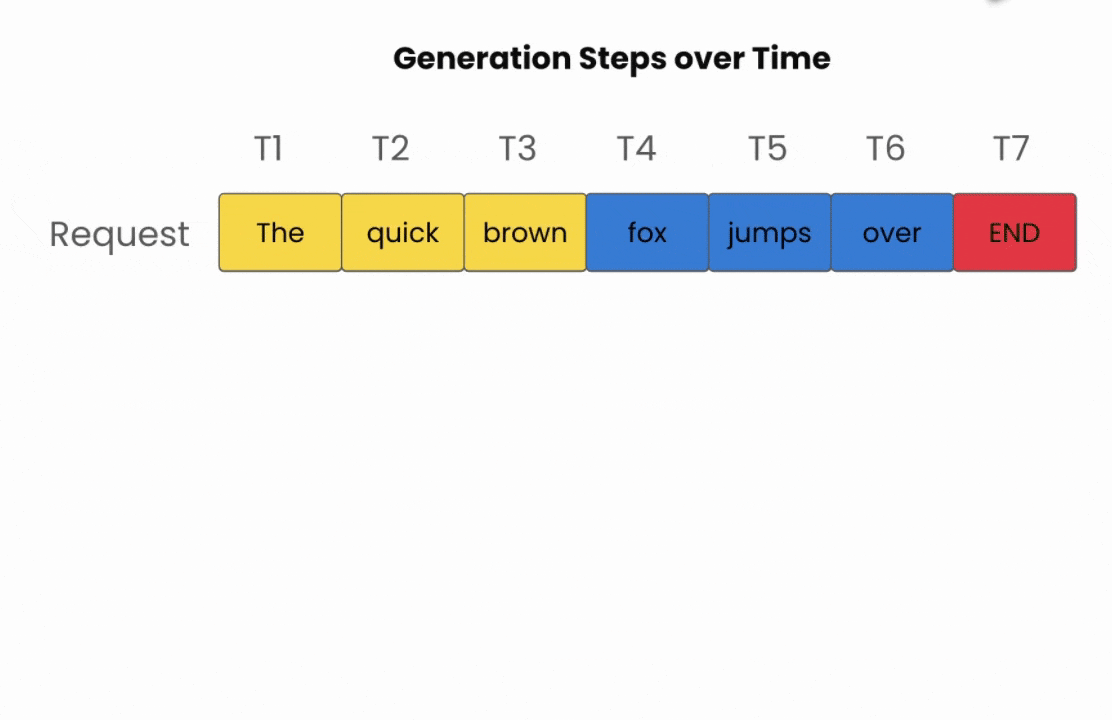
Figura 2: Cada propagación hacia adelante produce exactamente 1 token nuevo, que luego se vuelve a introducir para generar el siguiente.
Los LLM no generan respuestas largas de una sola vez, sino que producen 1 token a la vez, y cada nuevo token depende de todos los anteriores (incluidos los que el propio modelo acaba de generar).
Por lo tanto, si comenzamos con una petición de ejemplo: "The quick brown"
- El modelo predice "fox" → se añade
- "The quick brown fox" → predice "jumps" → se añade
- Y así sucesivamente, hasta que el modelo emite un token especial de fin de secuencia.
Eso es la generación autorregresiva, y lo que la gente subestima es que cada token de una respuesta requiere una propagación completa por el modelo. Una respuesta de 500 tokens significa que el modelo se ejecuta 500 veces, y aquí puedes ver cómo la demanda computacional puede empezar a crecer.
Por qué existe la memoria caché de KV
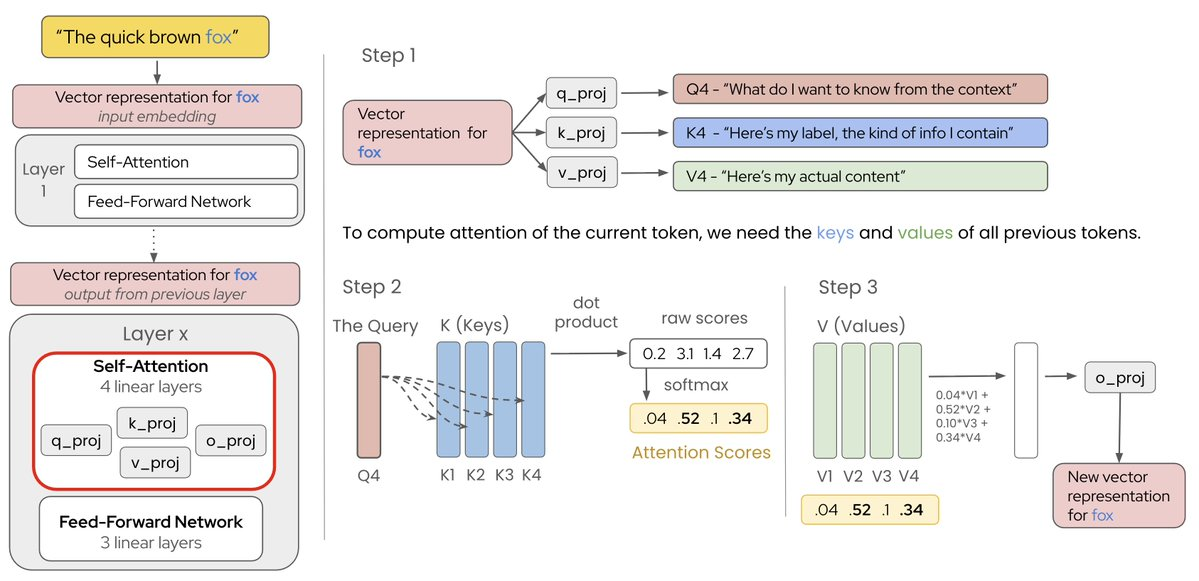
Figura 3 Cada token pasa por el bloque de atención de cada capa y compara su consulta con las claves y los valores de todo lo que tiene antes.
Dentro de cada una de esas propagaciones, los tokens se convierten en embeddings (una representación numérica) para fluir a través de un stack de capas de transformadores, y cada capa tiene un bloque de autoatención donde los tokens se observan entre sí. Ahí es donde comienza el problema de la memoria.
Attention calcula 3 vectores por token:
- Q, la consulta: Lo que este token quiere saber del contexto
- K, la clave: El tipo de información que contiene
- V, el valor: Su contenido real
Para generar el siguiente token, comparas su consulta con la clave de cada token procesado hasta el momento y calculas una suma ponderada de los valores.
¡Pero! Esto es lo verdaderamente importante: La consulta solo se necesita para el token actual. Las claves y los valores se necesitan para todo el historial, pero no cambian. La clave y el valor del token 4 son los mismos en el paso 5 que en el paso 4.
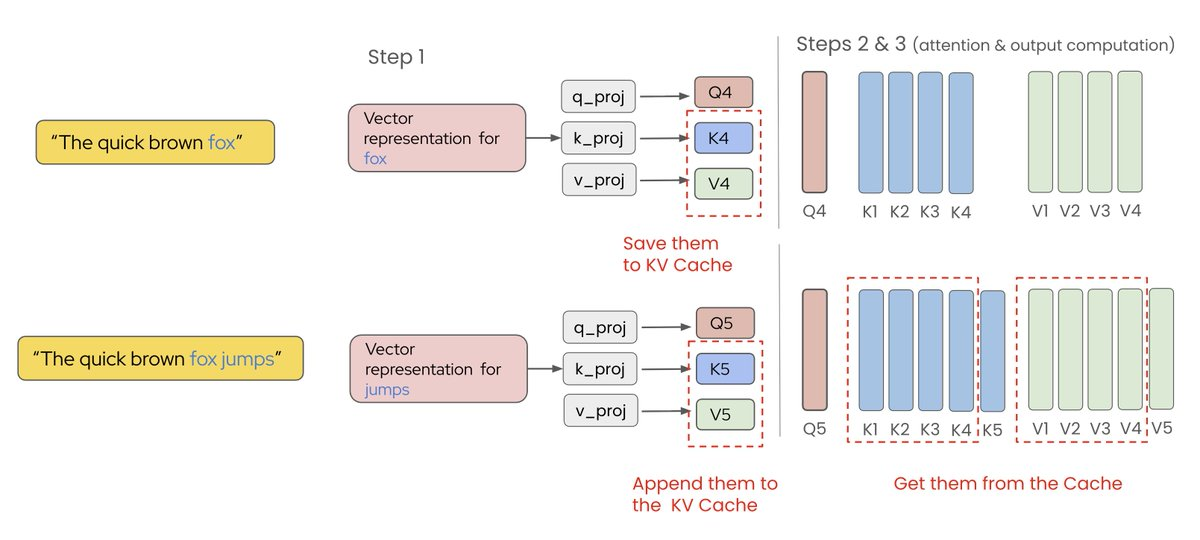
Figura 4 Dado que las claves y los valores de los tokens anteriores nunca cambian, se guardan una vez y se reutilizan en lugar de volver a calcularse en cada paso.
Por lo tanto, en lugar de volver a calcularlos en cada paso, los guardamos en la memoria de la GPU y solo calculamos K y V para el nuevo token. Esa es la memoria caché de KV, y ocurre en cada una de las N capas del modelo, por lo que el ahorro se multiplica por N.
¿Cuánto puede llegar a crecer la memoria caché de KV?
Cada token necesita que sus claves y valores se almacenen en cada capa, con varios conjuntos paralelos por capa (los cabezales de KV). La fórmula es:
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
Tomemos como ejemplo gpt-oss-120b: 36 capas, 8 cabezales de KV, una dimensión de cabezal de 64, 2 bytes por valor. Esto equivale a unos 72 KB por token, pero gpt-oss solo conserva el historial completo en la mitad de sus capas, por lo que la cantidad que realmente aumenta se acerca a los 36 KB por token.
- 2000 (un turno de chat típico): ~75 MB
- 8000 (nivel de producción estándar): ~300 MB
- 32000 (un documento largo o una base de código): ~1,2 GB
- 128000 (el máximo de gpt-oss): ~4,8 GB
Y ese es un modelo diseñado para ser eficiente a la hora de servirlo. Un modelo denso de 70B con 80 capas y una dimensión de cabezal de 128 (como Llama 3.3 70B) requiere cerca de 320 KB por token, es decir, 9 veces más para la misma conversación. Por eso, las decisiones sobre la arquitectura del modelo son muy importantes para controlar tus costos de inteligencia artificial.
Adónde se destina tu presupuesto de GPU
Un modelo como gpt-oss-120b cabe en una sola GPU NVIDIA H100 de 80 GB. Eso fue todo un hito cuando se lanzó el modelo, pero tras cargar los pesos en la tarjeta, solo te quedan entre 15 y 20 GB de margen para la memoria caché de KV y la sobrecarga de inferencia. Servir a usuarios reales ahora resulta complicado; por ejemplo:
- Si tu servidor reserva memoria por solicitud, dimensionada para el contexto máximo que esa solicitud podría alcanzar (que es lo que hacían los enfoques anteriores), cada solicitud cuesta 4,8 GB, se use o no. Eso representa solo 3 usuarios simultáneos en una H100. ¡Uf!
- Si en cambio asignas lo que cada solicitud realmente utiliza, una solicitud típica de 8000 cuesta 300 MB. La misma tarjeta, el mismo modelo, 50 o 60 usuarios. Todo esto con el mismo hardware, pero la diferencia radica por completo en cómo se gestiona la memoria de la GPU, motivo por el cual este tema es tan importante.
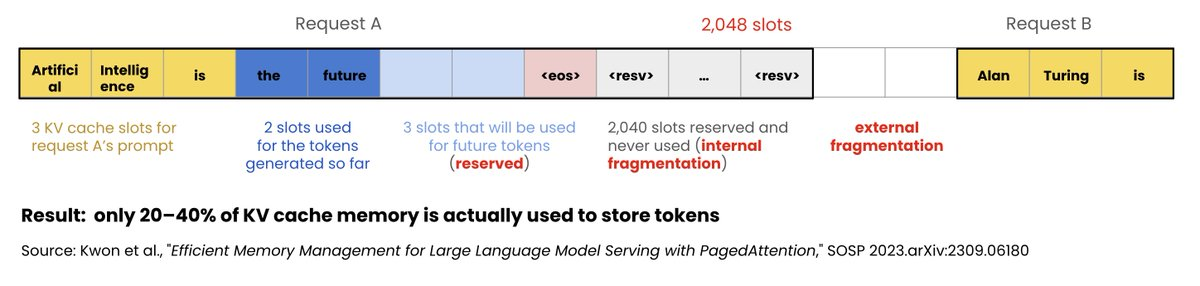
Figura 5: Reservar memoria para la longitud de contexto en el peor de los casos deja vacía la mayor parte de la memoria caché de KV.
¿Qué hacen al respecto los servidores de inferencia en producción, como vLLM?
Pues bien, principalmente 3 cosas:
1. PagedAttention
PagedAttention divide la memoria caché de KV en pequeños bloques de tamaño fijo que pueden ubicarse en cualquier lugar de la memoria, con una tabla que realiza un seguimiento de la ubicación de los bloques de cada solicitud. No se reserva nada para contextos que quizás nunca uses. Si has trabajado con memoria virtual en un sistema operativo, esto te resultará familiar: de ahí proviene la idea.
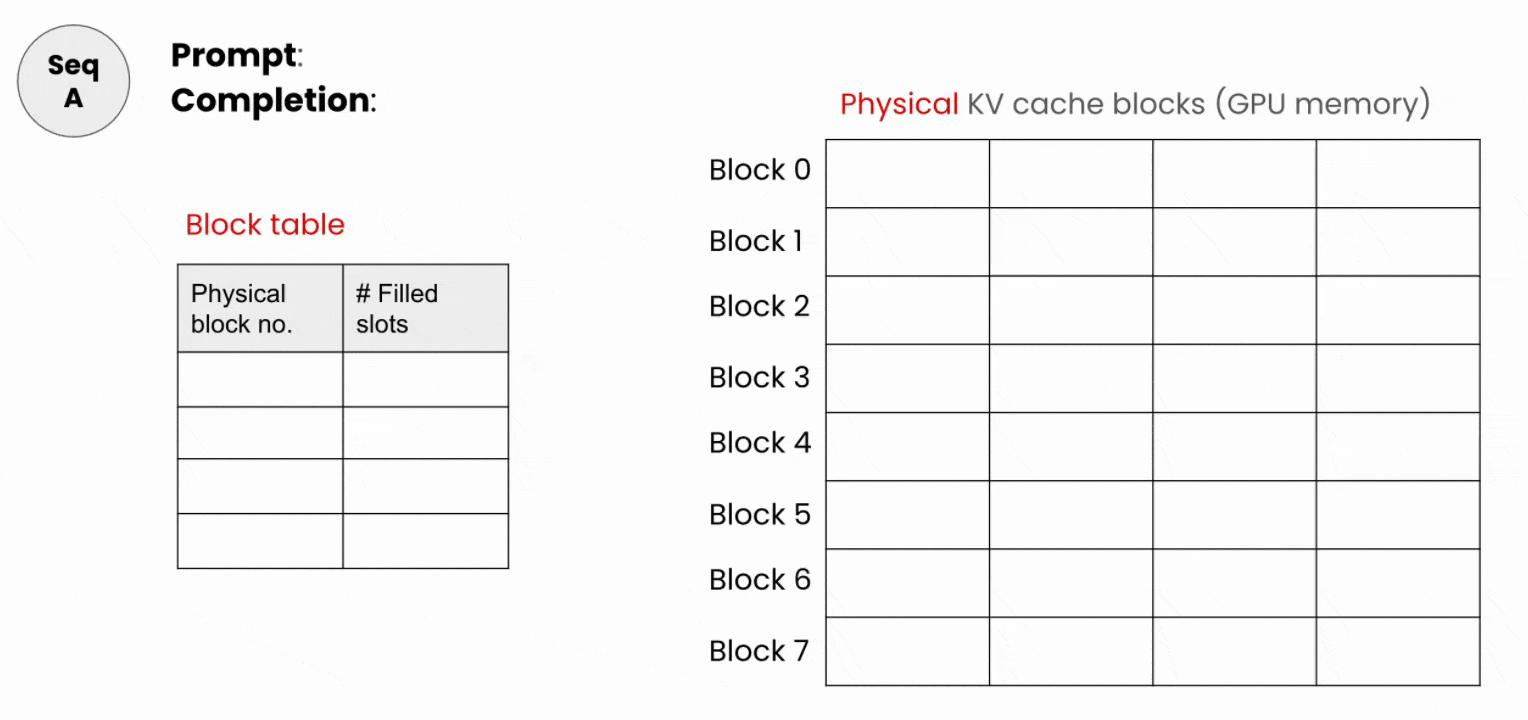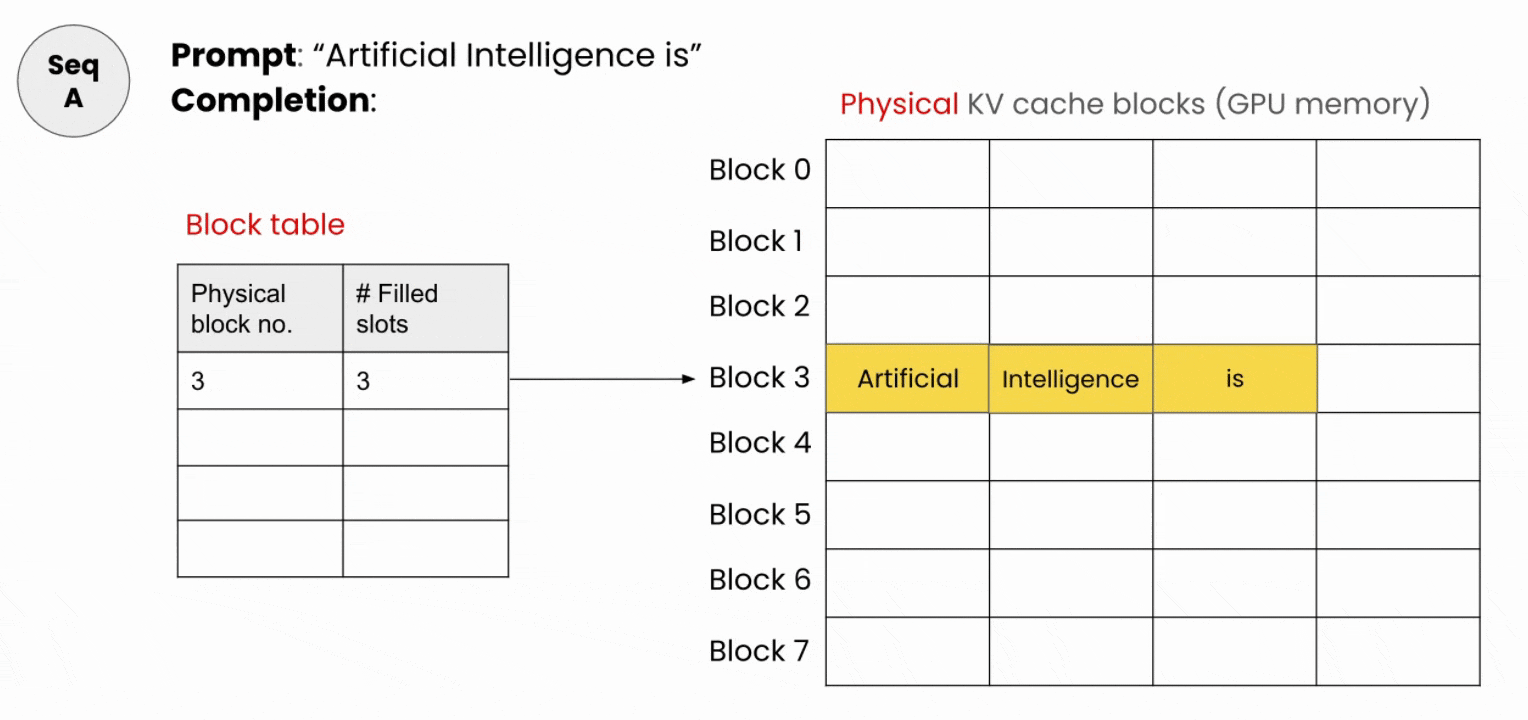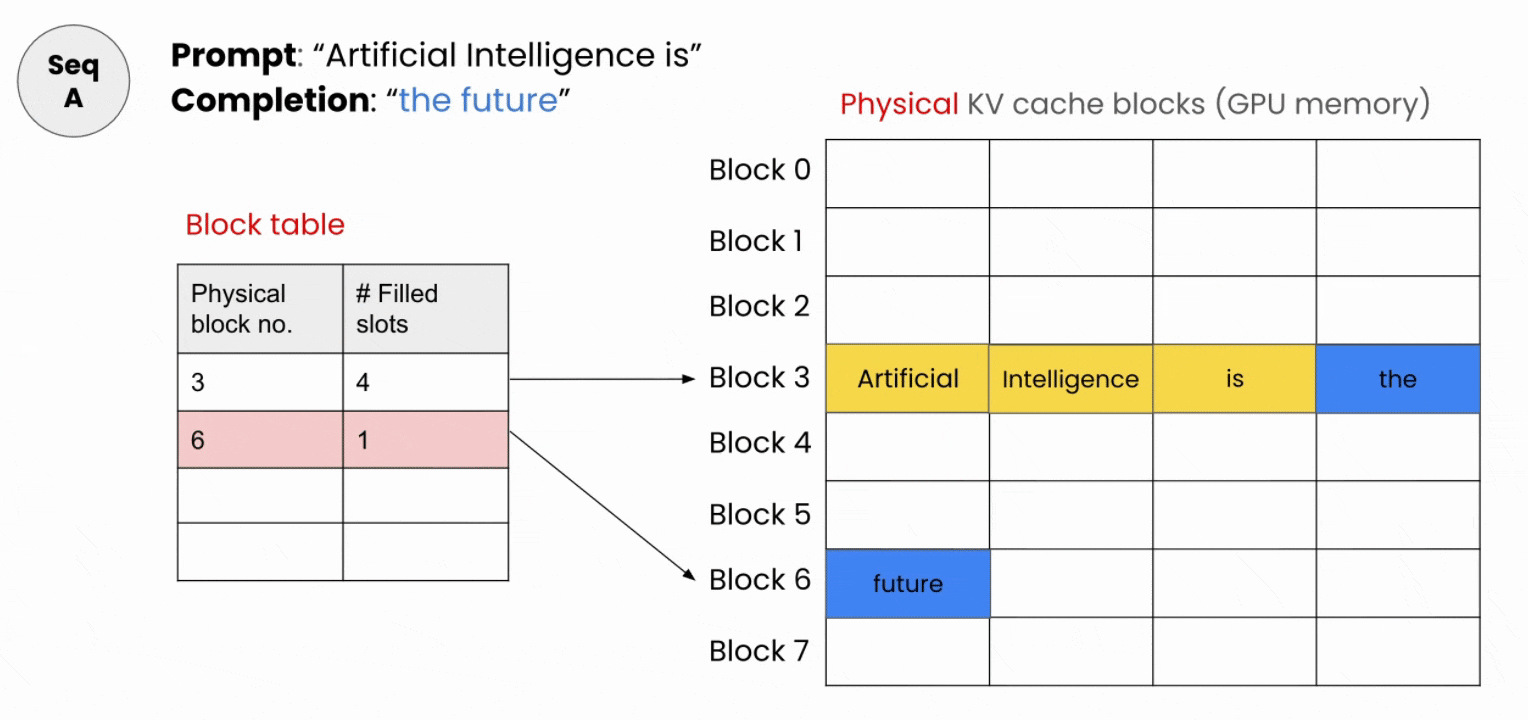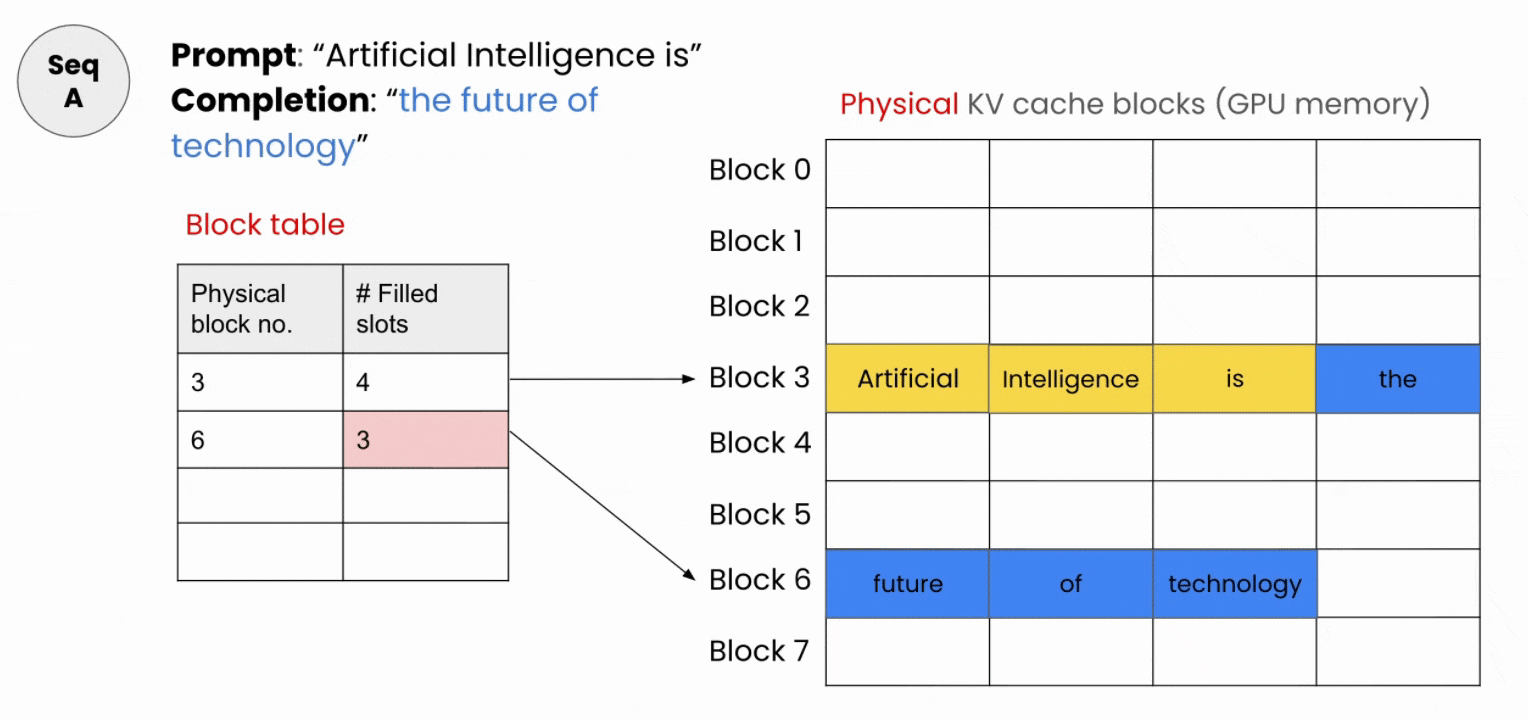
Figura 6: PagedAttention distribuye la memoria caché en pequeños bloques de tamaño fijo y les hace seguimiento con una tabla de consulta, por lo que no se reserva nada por adelantado.
2. Procesamiento por lotes continuo
Con el procesamiento por lotes continuo, en lugar de esperar a que finalice un lote completo, las solicitudes terminadas salen y las nuevas entran a medida que se liberan espacios. La GPU se mantiene ocupada continuamente.
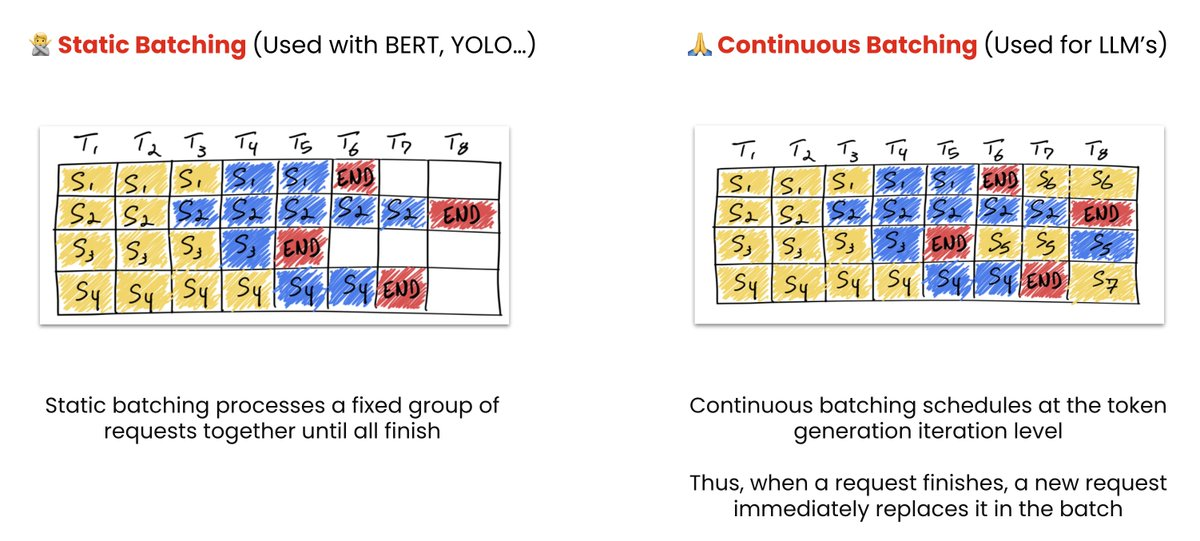
Figura 7: El procesamiento por lotes estático hace que cada solicitud espere a la más lenta, mientras que el procesamiento por lotes continuo ocupa de inmediato cada espacio liberado.
3. Almacenamiento en caché de prefijos
Cuando las solicitudes comparten un prefijo (una petición del sistema, un documento recuperado o el mismo archivo de repositorio en el contexto de un agente de programación), esto reutiliza las K y V almacenadas en caché en lugar de volver a calcularlas.
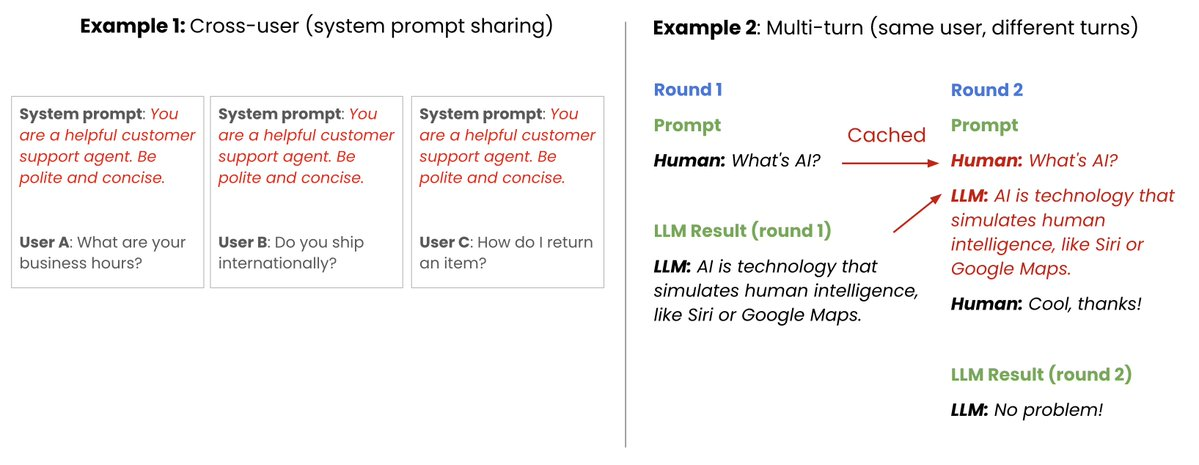
Figura 8: Cuando las solicitudes comparten el mismo texto inicial, el trabajo ya realizado para ese prefijo se reutiliza en lugar de recalcularse.
Ninguna de estas técnicas modifica el modelo, pero cambian la eficiencia con la que lo ejecutas.
Luego está la reducción del propio modelo
La cuantificación es un método para almacenar pesos (o activaciones) con menor precisión, de modo que ocupen menos espacio y se procesen más rápido. La mayoría de los modelos se distribuyen en BF16, o 16 bits por parámetro. Cuando pasas a FP8 (coma flotante de 8 bits) o INT8 (entero de 8 bits), reduces a la mitad la cantidad de memoria utilizada sin comprometer la precisión de referencia. Pasa a 4 bits y se reduce a una cuarta parte. Por ejemplo, todos los modelos cuantificados en el repositorio de Hugging Face de Red Hat AI recuperan más del 99 % de su precisión de referencia.
El modelo gpt-oss-120b es un caso muy útil porque el trabajo ya está hecho para ti. Con 117B parámetros en BF16, los pesos serían de unos 234 GB y necesitarías 3 GPU de 80 GB para cargarlos. OpenAI entrenó posteriormente el modelo con cuantificación MXFP4 en los pesos de MoE (Mixture of Experts), lo que reduce su tamaño por debajo de los 80 GB y permite ejecutarlo en una sola tarjeta.
- BF16 (hipotético): ~234 GB → 3 GPU
- MXFP4, tal como se distribuye: Cabe en una sola GPU de 80 GB
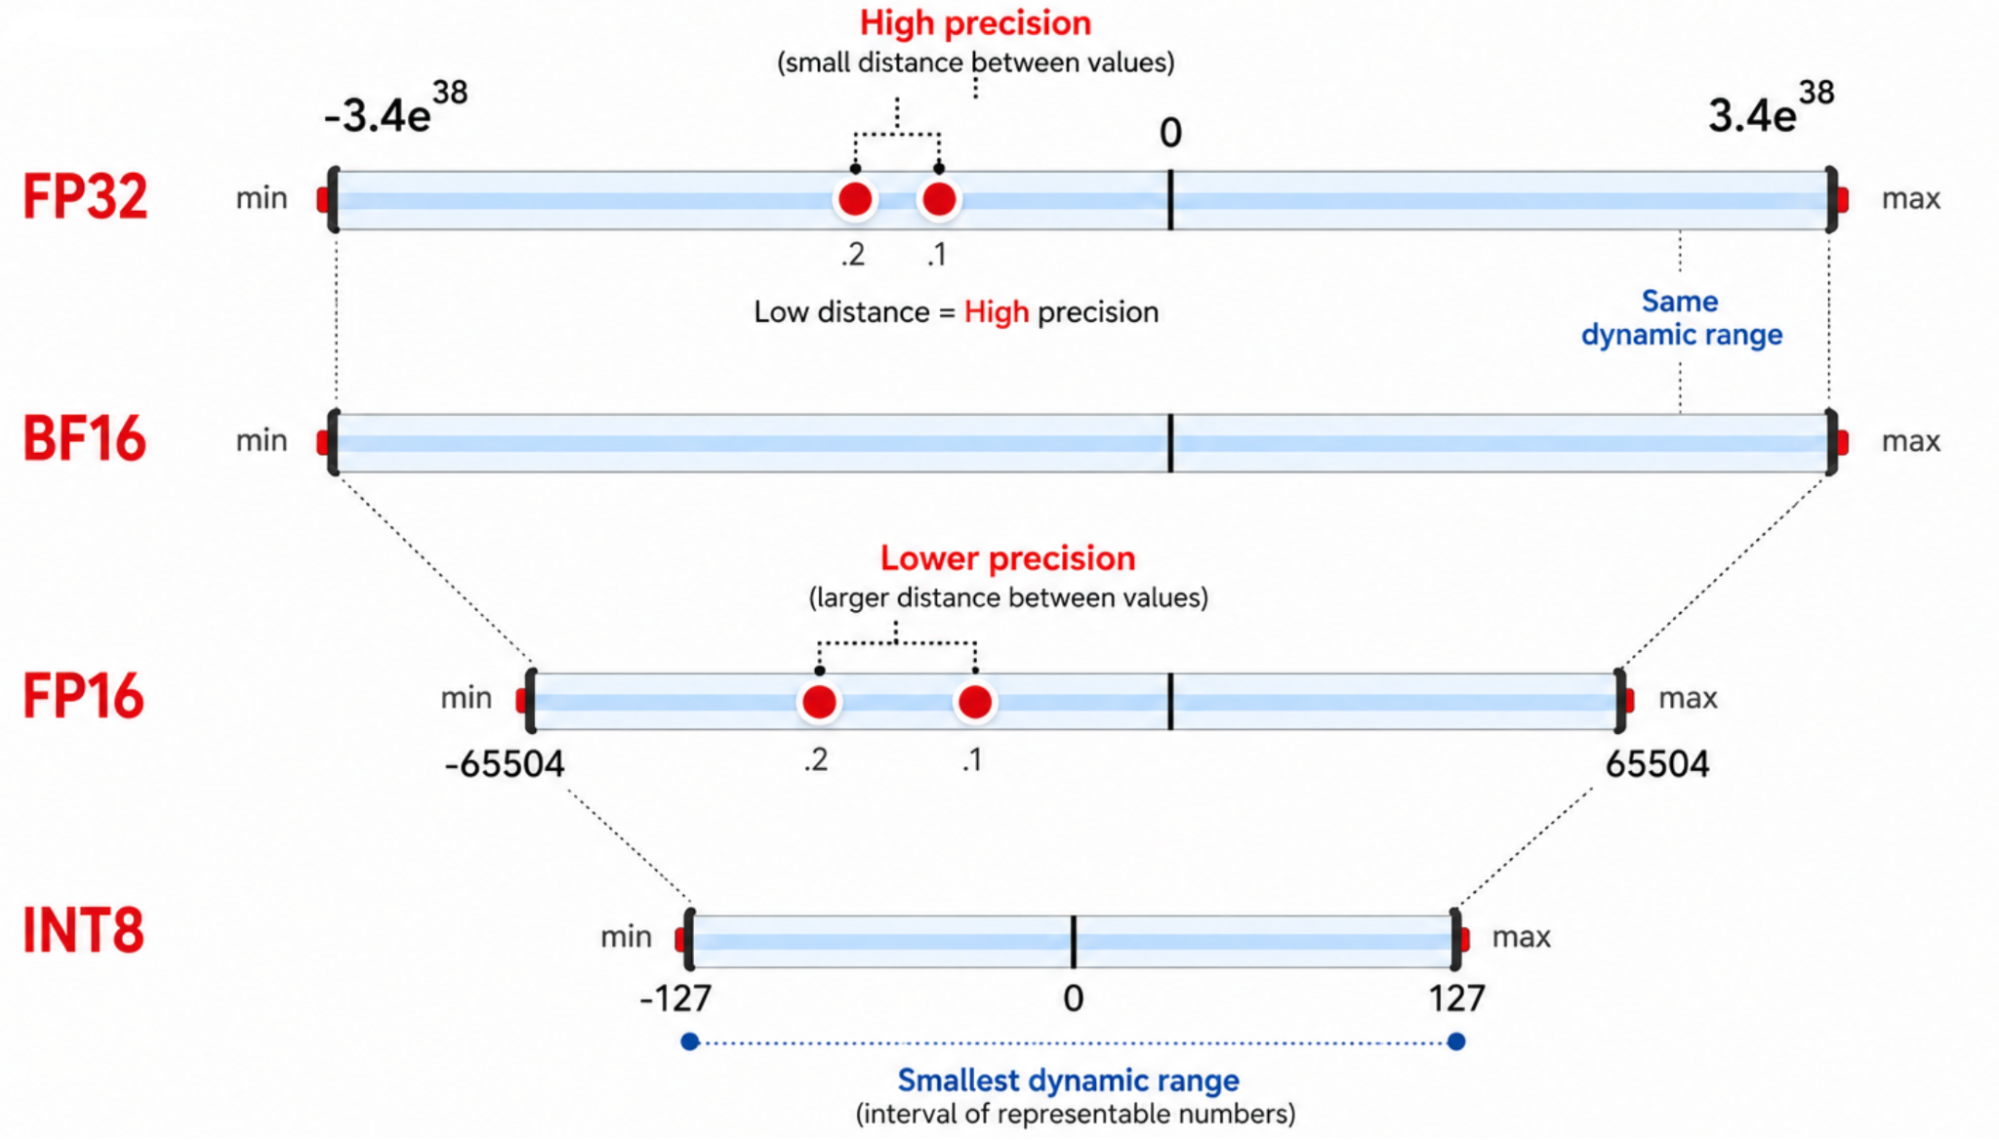
Figura 9: Los formatos numéricos de menor precisión sacrifican rango y detalle a cambio de una huella de memoria mucho menor.
La mayoría de los modelos no vienen así, momento en el que debes hacerlo tú mismo o consultar nuestros modelos comprimidos en HuggingFace. Al final, la cuantificación ofrece 2 grandes ventajas: Los pesos cuantificados implican que se transfieren menos datos desde la memoria de gran ancho de banda (HBM) a la memoria estática de acceso aleatorio (SRAM) en cada propagación hacia adelante, lo cual mejora la latencia. Las activaciones cuantificadas permiten que los núcleos tensoriales hagan los cálculos con menor precisión y procesen más operaciones por segundo, lo cual aumenta el rendimiento. Los esquemas solo de pesos como W8A16 (peso de 8 bits, activación de 16 bits) te ofrecen la primera ventaja, pero formatos como W8A8 (peso Int8, activación Int8) te brindan ambas.
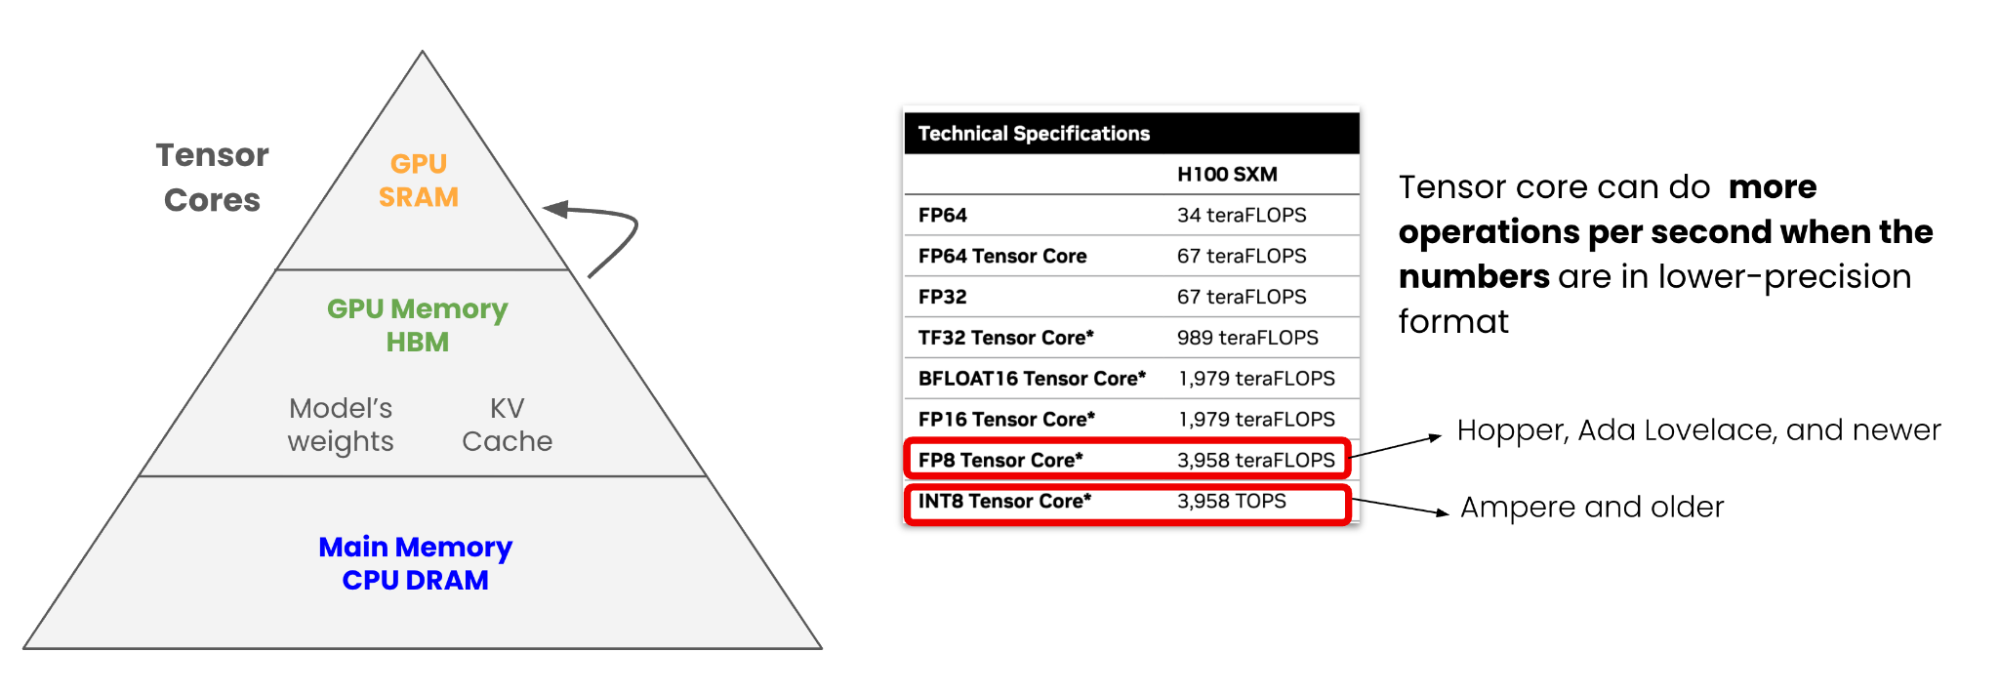
Figura 10: Los pesos más pequeños se transfieren con mayor rapidez a la memoria más rápida de la GPU, y los cálculos de baja precisión se ejecutan con un rendimiento mucho mayor en los núcleos tensoriales.
En la práctica, FP8 reduce a la mitad tus requisitos de memoria y proporciona un rendimiento hasta 1,6 veces superior con un impacto mínimo en la precisión. Y no, no estás volviendo más tonto al modelo. Las técnicas calibradas, como la cuantificación generalizada posterior al entrenamiento (GPTQ), la cuantificación de pesos en función de la activación (AWQ) y SmoothQuant, utilizan un pequeño conjunto de datos representativo para determinar qué pesos son los más importantes y protegerlos, de modo que la pérdida de calidad suele ser inferior a un punto porcentual.
Guía rápida de optimización de modelos de inteligencia artificial
Técnica | Dónde se aplica | Qué obtienes |
PagedAttention | Tiempo de ejecución | Más solicitudes simultáneas en la misma memoria |
Procesamiento por lotes continuo | Tiempo de ejecución | La GPU se mantiene ocupada entre solicitudes |
Almacenamiento en caché de prefijos | Tiempo de ejecución | Omite el recálculo en contextos compartidos |
Cuantización | Modelo, antes de la implementación | Menos GPU, carga más rápida, cálculos más veloces |
Sparsification | Modelo, antes de la implementación | Omite los pesos menos relevantes |
El entrenamiento es un costo único; la inferencia es el recurrente y representa la mayor parte de la factura. Cada token requiere una propagación hacia adelante completa. La memoria caché de KV es lo que crece con la longitud del contexto y los usuarios simultáneos, y gestionarla es la tarea principal de tu servidor de inferencia. En nuestro ejemplo, la diferencia entre una implementación básica y una optimizada en la misma GPU es de aproximadamente 3 usuarios simultáneos frente a 50. Si optimizas bien la inferencia, aprovecharás mucho mejor el hardware que ya tienes.
P. D.: ¡Si te ha gustado esto!
Si quieres ponerlo en práctica tú mismo, creamos un curso gratuito con DeepLearning.AI y Red Hat eminentemente práctico: Cuantifica un modelo Qwen con LLM Compressor y evalúa el balance de precisión, sírvelo con vLLM, realiza pruebas de rendimiento con GuideLLM y evalúalo con lm-eval: Fast & Efficient LLM Inference with vLLM.
Recurso
Get started with AI Inference: Red Hat AI experts explain
Sobre el autor
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
Más como éste
Inferencia de la IA distribuida para los proveedores de servicios de telecomunicaciones
La inteligencia artificial con agentes necesita una stack de inferencia open source
Navegar por canal

Automatización
Las últimas novedades en la automatización de la TI para los equipos, la tecnología y los entornos

Inteligencia artificial
Descubra las actualizaciones en las plataformas que permiten a los clientes ejecutar cargas de trabajo de inteligecia artificial en cualquier lugar

Nube híbrida abierta
Vea como construimos un futuro flexible con la nube híbrida

Seguridad
Vea las últimas novedades sobre cómo reducimos los riesgos en entornos y tecnologías

Edge computing
Conozca las actualizaciones en las plataformas que simplifican las operaciones en el edge

Infraestructura
Vea las últimas novedades sobre la plataforma Linux empresarial líder en el mundo

Aplicaciones
Conozca nuestras soluciones para abordar los desafíos más complejos de las aplicaciones

Virtualización
El futuro de la virtualización empresarial para tus cargas de trabajo locales o en la nube
