-
Productos y documentación Red Hat AI
Una plataforma de productos y servicios para el desarrollo y la implementación de la inteligencia artificial en la nube híbrida.
Red Hat AI Enterprise
Diseña, desarrolla e implementa aplicaciones impulsadas por la inteligencia artificial en la nube híbrida.
Red Hat AI Inference
Optimiza el rendimiento de los modelos con una stack integrada para realizar inferencias rápidas, uniformes y rentables a gran escala.
Red Hat Enterprise Linux AI
Desarrolla, prueba y ejecuta modelos de inteligencia artificial generativa para impulsar las aplicaciones empresariales.
Red Hat OpenShift AI
Diseña e implementa aplicaciones y modelos con inteligencia artificial según sea necesario en entornos híbridos.
-
Recursos de aprendizaje Conceptos básicos
- Novedades de Red Hat AI
- Why you should care about AI inference
- ¿Qué son los vLLM?
- ¿Qué es la inferencia de la inteligencia artificial?
- ¿Qué es la inteligencia artificial con agentes?
- ¿Qué es AgentOps?
- ¿Qué es llm-d?
- Más información sobre la inteligencia artificial
- Todas las publicaciones de blog sobre inteligencia artificial
Motivos para elegir Red Hat AI
-
Partners de IA
La importancia de la inferencia de la inteligencia artificial
Por decirlo de una manera sencilla, no hay inteligencia artificial sin inferencia. Es la base de la inteligencia artificial generativa.
La buena noticia es que sabemos todo el éxito que puede tener. El desafío es saber cómo expandirla.
Analicemos el modo de ampliar la inferencia de la inteligencia artificial con herramientas open source como vLLM y llm-d.
¿Por qué la inferencia es clave?
La inferencia es la etapa final, en la que un modelo ofrece el resultado deseado. Es una función imprescindible para que la inteligencia artificial genere valor.
Es por eso que el hardware y el software que permiten realizar inferencias pueden facilitar o entorpecer tu estrategia de inteligencia artificial.
La arquitectura que ofrece la mayor cantidad de opciones de expansión se basa en la tecnología de open source.
Desafíos que frenan tu capacidad de ajuste
Sabemos que la inteligencia artificial funciona; el desafío es aplicarla en toda la empresa.
Cuando amplías la infraestructura, los modelos requieren más datos y más memoria. Es entonces cuando el hardware y los aceleradores empiezan a quedarse atrás.
Un proveedor externo podría ser la solución más sencilla. Sin embargo, los costos de los tókenes aumentan rápidamente y pueden superar los de la propia aplicación de inteligencia artificial.
40 %
Para el año 2030, la inferencia será la carga de trabajo predominante en los centros de datos de inteligencia artificial, y se espera que consuma hasta el 40 % de la demanda total de los centros de datos1.
Formas de optimizar la inferencia
Al optimizar la inferencia en la arquitectura open source, los modelos de inteligencia artificial se ejecutan con mayor rapidez y eficiencia.
Estas son algunas de las estrategias de optimización:
- compresión de modelos con cuantización;
- procesamiento más eficiente de las GPU;
- decodificación especulativa;
- inferencia distribuida;
- delegación de la memoria y las tareas de organización a las CPU.
Optimizaciones de este tipo aseguran que la inferencia de inteligencia artificial siga siendo rentable, lo que facilita su ajuste conforme aumentan las demandas de tu equipo.
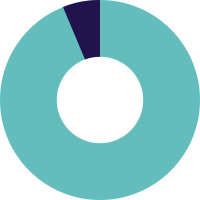
19 %
de ahorro de costos a gran escala con el uso de técnicas de decodificación especulativa2.

2
veces más rendimiento informático con modelos comprimidos, sin comprometer la precisión3.
90 %
de latencia integral total representada por las CPU4.
Optimización de la inferencia con vLLM
La optimización de modelos representa solo una parte del desafío. También se requiere un motor de inferencia de alto rendimiento, y, en este aspecto, vLLM resulta clave.
Los sistemas convencionales de gestión de memoria en los modelos de lenguaje de gran tamaño no organizan los datos de la mejor manera, lo que reduce su velocidad. vLLM implementa PagedAttention, una técnica que detecta valores clave repetidos para reducir el trabajo innecesario del modelo.
Esto permite al vLLM aprovechar mejor la memoria de la GPU y acelerar la inferencia de la inteligencia artificial generativa. Aumenta el rendimiento (tokens procesados por segundo) para prestar servicio a muchos usuarios a la vez.
El uso eficiente de los aceleradores permite que los modelos realicen operaciones más complejas en menos tiempo, para que los equipos puedan responder más rápido a un mayor número de usuarios y agentes.
75 %
de reducción de los requisitos de memoria, lo que disminuye el número de GPU requeridas5.
4
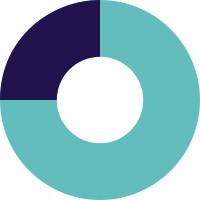
veces más tókenes por segundo procesados en comparación con la mayoría de los proveedores de inferencias6.
24
veces más rendimiento con vLLM respecto a la competencia7.
Motivos que explican el éxito de vLLM
vLLM aborda los desafíos centrales de la eficiencia en el uso de la GPU, reduce el costo por token y logra una latencia estable a gran escala, todo ello con un enfoque de implementación abierto y portátil.
Con compatibilidad desde el día cero con todos los modelos y aceleradores más utilizados, su accesibilidad facilita la adopción en empresas y ámbitos académicos. Por eso, cuenta con una comunidad activa y dinámica.
Las contribuciones de equipos como Hugging Face, UC Berkeley, NVIDIA y Red Hat impulsan mejoras permanentes y aseguran que el software evolucione constantemente dentro del proyecto open source.
Más de 10 000
commits de vLLM en GitHub*, lo que supone un aumento de más del 200 % en 2026.
La comunidad vLLM hoy
Más de 500 000
GPU implementadas de manera ininterrumpida8
Más de 200
tipos diferentes de aceleradores9
Más de 500
arquitecturas de modelos compatibles9
Más de 3100
El papel de la inferencia distribuida
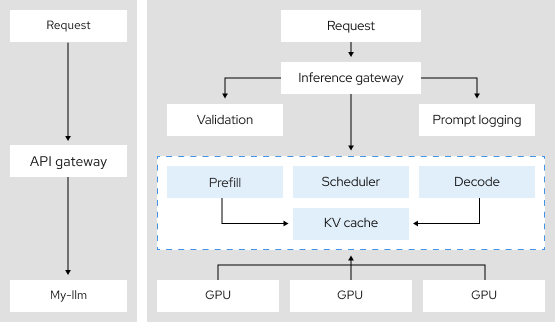
Con la inferencia distribuida, los modelos de inteligencia artificial dividen la carga de trabajo entre un grupo de dispositivos interconectados.
Cuando un modelo puede satisfacer diferentes solicitudes de manera simultánea, disminuyen los requisitos de hardware y la eficiencia de la inferencia mejora.
La inferencia distribuida utiliza técnicas como el paralelismo tensorial, la programación inteligente de la inferencia y la desagregación. En combinación con vLLM, permite que la inferencia funcione como una máquina multitarea altamente eficiente.
Así, se mantiene ajustable, uniforme y fácil de supervisar.
99 %
de reducción del tiempo hasta el primer token (TTFT) con carga equivalente10.

¿Hay una comunidad open source para esto?
Sí, se denomina llm-d.
Es un marco open source que ofrece a los desarrolladores un plan para diseñar una inferencia distribuida a gran escala.
Gracias a su arquitectura modular, se adapta a las complejas exigencias de recursos de los modelos de lenguaje de gran tamaño complejos y sustituye los procesos manuales y fragmentados por procesos integrados y optimizados, lo que acelera la transición de la fase inicial a la de producción.
Con llm-d, la inferencia llega a Kubernetes. Su kit de herramientas estandarizado permite implementar inferencia distribuida adaptada a los casos prácticos específicos de tu empresa.
2
veces más usuarios sostenidos en el mismo hardware con clústeres optimizados para llm-d11.
Recursos adicionales de inteligencia artificial
Red Hat AI Inference
Acelera la transición de tus modelos de lenguaje de gran tamaño de la fase de desarrollo a la producción.
Nuestro motor de inferencia para empresas se basa en vLLM y ofrece mayor velocidad sin afectar al rendimiento.
Ajusta la capacidad en la nube híbrida con el modelo de inteligencia artificial generativa optimizado que elijas, con cualquier acelerador y en cualquier entorno de nube.

Referencias
[1] "The future of AI workloads". McKinsey & Company, 24 de febrero de 2026.
[2] Umesh, Harshith. "Performance improvements with speculative decoding in vLLM for gpt-oss". Blog de Red Hat Developer, 16 de abril de 2026.
[3] Kurtić, Eldar, et al. "2:4 Sparse Llama: Smaller models for efficient GPU inference". Blog de Red Hat Developer, 28 de febrero de 2025.
[4] Bowerman, Sawyer. Ableidinger, Grace. "The CPU is back: Rethinking the CPU-GPU split for LLM inference". Blog de Red Hat, 6 de agosto de 2026.
[5] "What is LLM Compressor?". Documentos de vLLM.
[6] "vLLM Tops the Artificial Analysis Leaderboard". Blog de vLLM, 11 de mayo de 2026.
[7] Kwon, Woosuk, et al. "vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention". Blog de vLLM, 20 de junio de 2023.
[8] Goin, Michael. "[vLLM Office Hours #38] vLLM 2025 Retrospective & 2026 Roadmap - December 18, 2025". YouTube, 8 de diciembre de 2025.
[9] Kwon, Woosuk. "Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale". X, 26 de enero de 2026.
[10] Singh, Naina. "Las mismas 16 GPU, el doble de usuarios: Enrutamiento con reconocimiento de inferencias para clústeres de LLM". Blog de Red Hat, 27 de mayo de 2026.
[11] Singh, Naina. "Las mismas 16 GPU, el doble de usuarios: Enrutamiento con reconocimiento de inferencias para clústeres de LLM". Blog de Red Hat, 27 de mayo de 2026.
