La vitesse à laquelle les nouvelles fonctionnalités sont ajoutées et les applications évoluent accroît directement la complexité architecturale. Ce rythme incessant n'est pas seulement dicté par le désir de nouvelles fonctionnalités ; il est de plus en plus imposé par la découverte constante de nouvelles vulnérabilités. L'application d'un correctif sur une seule dépendance critique peut déclencher une cascade de mises à jour requises et de changements architecturaux inattendus, car chaque produit et solution s'accompagne d'une multitude d'options de mise en œuvre et de diverses fonctionnalités à activer ou à désactiver. L'adaptation de cette complexité à votre environnement spécifique rend difficile la garantie que chaque composant est déployé conformément aux meilleures pratiques du secteur. Les modèles validés comblent ce fossé en proposant des modèles de déploiement testés et prêts à l'emploi pour divers cas d'utilisation, évitant ainsi d'avoir à créer de toutes pièces des architectures complexes axées sur la sécurité.
La vérité dérangeante sur la gestion des vulnérabilités
En 2025, plus de 40 000 nouvelles CVE ont été publiées. Cela représente plus de 100 nouvelles vulnérabilités chaque jour. Aujourd'hui, la génération d'exploits par l'IA accélère considérablement le délai entre la divulgation d'une vulnérabilité et son exploitation réelle. « À la recherche du Graal » montre que viser un score parfait de zéro CVE peut parfois s'avérer contre-productif si cela détourne l'attention des stratégies de défense en profondeur plus complexes. Un composant « propre » à 9 h 00 peut présenter une vulnérabilité nouvellement divulguée d'ici 17 h 00. Même lorsqu'on atteint le chiffre de zéro CVE connue, il reste toujours des vulnérabilités inconnues.
Le calcul des correctifs (l'idée fausse selon laquelle la sécurité n'est qu'un jeu de chiffres où moins de CVE signifie moins de risques) ne tient tout simplement pas la route dans les environnements d'entreprise exécutant des centaines de charges de travail conteneurisées. Contrairement aux architectures monolithiques traditionnelles s'exécutant sur un seul système d'exploitation, les environnements de conteneurs distribués introduisent une complexité architecturale nettement plus élevée. D'innombrables microservices et points de contact réseau offrent bien plus d'options de configuration où une erreur peut se produire et créer par inadvertance une faille de sécurité. Vouloir tout corriger instantanément est un travail de Sisyphe qui entre en conflit avec une stratégie de sécurité moderne basée sur les risques. Cela ignore également une vérité fondamentale : quel que soit l'empressement mis à appliquer les mises à jour, il y aura toujours un délai.
Dès lors, que faire pendant le laps de temps qui s'écoule entre la divulgation de la vulnérabilité et le déploiement du correctif ? La réponse réside dans un principe de sécurité qui existe depuis des années, mais qui est plus crucial aujourd'hui que jamais : Architecture de Zero Trust
Ce que le Zero Trust signifie pour votre cluster Red Hat OpenShift
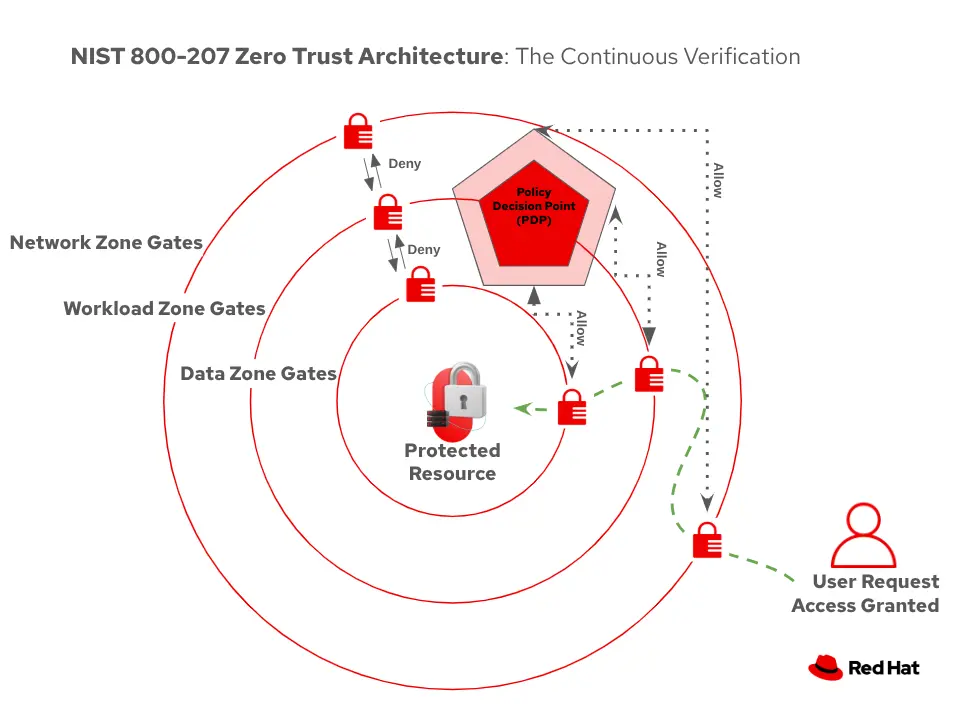
Le Zero Trust n'est pas un produit que l'on installe. Il s'agit d'une philosophie architecturale qui part du principe qu'une violation a déjà eu lieu, exigeant que chaque interaction soit explicitement vérifiée et autorisée. Selon la publication NIST SP 800-207, le Zero Trust consiste à supprimer la confiance implicite accordée aux ressources (actifs, applications ou comptes d'utilisateur) uniquement sur la base de leur emplacement physique ou réseau. L'authentification et l'autorisation sont des fonctions distinctes effectuées avant l'établissement de toute session vers une ressource d'entreprise.
La mise en œuvre du Zero Trust dans Kubernetes et Red Hat OpenShift nécessite une approche multicouche englobant l'identité des charges de travail, la gestion des secrets et le contrôle d'accès au moment de l'exécution. Plus précisément dans le domaine des réseaux, l'une des implications les plus critiques de cette philosophie consiste à dépasser la posture de réseau plat par défaut où chaque pod peut communiquer librement. Par défaut, Kubernetes n'applique aucune restriction de réseau interne, ce qui revient à laisser chaque porte intérieure d'un bâtiment non verrouillée simplement parce que celui-ci possède une porte d'entrée (comme un contrôleur d'entrée de cluster, une passerelle d'API ou un pare-feu de périmètre). Toutefois, s'appuyer uniquement sur cette défense périmétrique est fondamentalement insuffisant pour les environnements cloud-native modernes.
Selon le modèle de Zero Trust, nous supposons qu'une violation a déjà eu lieu et que des acteurs malveillants se trouvent déjà dans votre environnement, qu'il s'agisse d'attaquants externes ayant contourné le périmètre, d'un composant de la chaîne logistique compromis ou de menaces internes malveillantes opérant directement de l'intérieur. En mettant en œuvre des restrictions sur les ressources réseau Kubernetes, nous créons par défaut une connexion réseau avec refus par défaut avec une authentification et une autorisation explicites pour utiliser le réseau et atteindre les autres ressources qui y sont rattachées (Figure 1).
De la théorie à la pratique : le Layered Zero Trust Validated Pattern (ZTVP)
Pour concrétiser ces meilleures pratiques, nous utilisons le Layered Zero Trust Validated Pattern (ZTVP). Un modèle validé incarne les meilleures pratiques de l'Infrastructure as Code (IaC) et l'automatisation GitOps, réduisant considérablement le temps de configuration pour les déploiements OpenShift complexes conçus pour la sécurité et l'évolutivité. Au cours des trois derniers mois, le projet ZTVP a réalisé des progrès significatifs, obtenant l'accréditation Tested Tier.
Le modèle regroupe plusieurs composants dans une architecture de Zero Trust cohérente, déployée via GitOps :
- Zero Trust Workload Identity Manager : Fournit aux charges de travail des identités cryptographiques de courte durée basées sur le projet SPIFFE/SPIRE.
- HashiCorp Vault: Stocke les actifs sensibles et les secrets de cluster de manière hautement sécurisée, avec une intégration à ZTWIM pour l'authentification JWT.
- Red Hat build of Keycloak : Gère l'authentification des utilisateurs et l'identité fédérée.
- Red Hat Advanced Cluster Security for Kubernetes : Agit comme le cerveau de sécurité intelligent, fournissant une surveillance multi-cluster unifiée, un contrôle d'admission proactif, une détection des anomalies comportementales en temps réel et, point crucial dans notre exemple, un analyseur de politiques réseau.
Politiques réseau : la dernière ligne de défense
Bien que les politiques réseau soient souvent présentées comme le fondement du Zero Trust, elles ne constituent pas un principe en soi. Il s'agit plutôt d'un mécanisme architectural proactif utilisé pour appliquer les résultats souhaités d'un modèle de Zero Trust. Red Hat définit quatre principes fondamentaux du Zero Trust, et des politiques réseau bien conçues soutiennent activement chacun d'entre eux :
- Microsegmentation : en régissant le trafic au niveau de chaque pod, les politiques réseau divisent intrinsèquement le cluster en segments granulaires à sécurité renforcée.
- Accès au moindre privilège : une posture de refus par défaut garantit que les charges de travail ne reçoivent que les autorisations réseau exactes dont elles ont absolument besoin pour fonctionner, et rien de plus.
- Déperimétrisation : les contrôles de sécurité ne sont plus seulement situés à la « porte d'entrée » du cluster, mais appliqués directement autour des charges de travail elles-mêmes.
- Supposition de violation : en éliminant proactivement les chemins d'attaque latérale, des règles d'entrée et de sortie strictes sont déjà en place pour limiter le rayon d'impact dès qu'une compromission survient.
En outre, un aspect extrêmement important des politiques réseau de Kubernetes est qu'elles résident sur un plan de contrôle distinct des pods d'application qu'elles protègent. Cela signifie que même si un attaquant parvient à pénétrer dans un conteneur et obtient des privilèges élevés au sein de cette application, il ne peut pas simplement redéfinir ou contourner les limites du réseau qui le restreignent. Pour renforcer la posture de sécurité globale de l'environnement interne et mettre véritablement ces principes en pratique, nous devons définir des politiques réseau précises qui régissent à la fois le trafic entrant et sortant au niveau du pod :
- Politiques d'entrée (ingress policies) : celles-ci contrôlent le trafic entrant vers un pod, en appliquant une règle selon laquelle un service n'accepte que les connexions provenant de sources explicitement autorisées. Si un pod voisin dans le cluster est compromis, une politique d'entrée stricte empêche l'attaquant d'accéder latéralement à vos charges de travail sensibles.
- Politiques de sortie (egress policies) : celles-ci contrôlent le trafic sortant d'un pod. Leur but est de limiter strictement les ressources externes ou internes qu'un pod peut atteindre. Si un pod est compromis, les politiques de sortie neutralisent la capacité d'un attaquant à exfiltrer des données, à effectuer une reconnaissance réseau étendue ou à télécharger des charges malveillantes à partir de serveurs de commande et de contrôle (C2) externes.
Le fondement du refus par défaut
Bien que la définition de règles d'entrée et de sortie spécifiques soit cruciale, s'y fier exclusivement laisse une lacune dangereuse, ouvrant la porte aux erreurs humaines et aux attaques trompeuses. Par défaut, Kubernetes fonctionne sur un modèle d'autorisation générale, ce qui signifie que tout trafic non explicitement restreint est autorisé. Si une personne en charge du développement oublie simplement d'appliquer une politique, ce pod reste largement ouvert. Mais le risque va au-delà des simples erreurs commises de bonne foi. Dans une attaque de la chaîne logistique, une personne en charge du développement peut être trompée et déployer sans le savoir un composant tiers compromis, ignorant tout de la charge malveillante cachée ou de ses conséquences.
Une politique de refus par défaut fait basculer ce paradigme d'une liste de blocage vers une liste d'autorisation. Le principe fondamental du Zero Trust exigeant que chaque interaction soit explicitement autorisée, il s'ensuit logiquement qu'aucun accès ne peut être implicite. En bloquant strictement tout le trafic d'emblée, une posture de refus par défaut crée un environnement où une omission accidentelle (ou un conteneur malveillant habilement déguisé tentant de communiquer avec l'extérieur) se solde par une connexion bloquée en toute sécurité. Elle oblige à accorder explicitement l'accès par conception, transformant ce qui pourrait être une violation silencieuse et catastrophique en une erreur de déploiement visible et facile à corriger.
L'approche commence par une règle simple mais puissante : refuser tout le trafic par défaut. Chaque espace de noms reçoit une NetworkPolicy de refus par défaut qui bloque toutes les entrées et sorties pour chaque pod, à moins qu'une politique d'autorisation explicite n'existe.
apiVersion : networking.k8s.io/v1 kind: NetworkPolicy metadata: name : default-deny-in-namespace spec: podSelector: {} policyTypes: - Ingress - EgressDès qu'une NetworkPolicy cible un pod dans un espace de noms, celui-ci ne conserve plus un accès illimité. En définissant une politique qui bloque l'accès par défaut, elle s'aligne sur une posture de Zero Trust avec refus par défaut.
Pourquoi cela est important lorsque vous ne pouvez pas appliquer de correctifs
Considérons un scénario d'entreprise rappelant la tristement célèbre crise Log4j ou des chocs plus récents liés aux frameworks comme la vulnérabilité React2Shell (CVE-2025-55182) :
- Une vulnérabilité critique d'exécution de code à distance (RCE) est soudainement divulguée dans une bibliothèque omniprésente utilisée par votre application.
- La vulnérabilité permet une prise de contrôle totale du serveur si un attaquant parvient à envoyer une requête spécialement conçue au service concerné.
- Comme la bibliothèque est profondément ancrée dans vos dépendances, un correctif validé ne pourra pas être testé et déployé en production avant plusieurs jours.
L'impact sur une organisation disposant de politiques réseau de Zero Trust est minime :
- Un attaquant compromettant n'importe quel pod peut facilement atteindre le service vulnérable dans n'importe quel espace de noms (absence d'isolement latéral).
- Avec les politiques réseau ZTVP : l'attaquant ne peut pas atteindre le service à partir d'un autre espace de noms (isolement des espaces de noms).
- Un attaquant peut se connecter à n'importe quel port exposé sur le service, y compris les ports critiques ou de gestion (absence de filtrage au niveau des ports).
- Avec les politiques réseau ZTVP : l'attaquant ne peut pas se connecter aux ports qui ne sont pas explicitement autorisés (filtrage au niveau des ports).
- Un attaquant peut librement établir des connexions sortantes pour exfiltrer des données ou établir des canaux de commande et de contrôle (C2) (absence de restrictions de sortie).
- Avec les politiques réseau ZTVP : l'attaquant ne peut pas exfiltrer de données vers des points de terminaison externes (restrictions de sortie).
Démonstration : éliminer le chemin d'attaque
Nous avons créé une vidéo de démonstration dans laquelle nous observons comment des politiques réseau correctement mises en œuvre éliminent activement les chemins d'attaque. Au départ, nous voyons un environnement sans posture de refus par défaut, où un attaquant exploitant une vulnérabilité de la chaîne logistique peut facilement effectuer une reconnaissance approfondie, sondant librement le réseau à la recherche d'autres composants non corrigés à exploiter. Ensuite, nous voyons qu'une fois que des politiques réseau strictes sont appliquées, la donne change complètement.
Même si un attaquant parvient à pénétrer dans un pod, sa capacité à explorer le réseau, à rechercher des vulnérabilités ou à pivoter latéralement est entièrement neutralisée. Les politiques le confinent au conteneur compromis, contenant ainsi efficacement la menace et vous faisant gagner le temps crucial nécessaire pour mettre en œuvre des mesures correctives. Bien qu'elles ne soient pas le seul garde-fou d'une stratégie de sécurité complète, l'établissement de limites réseau strictes est sans doute le meilleur point de départ pour construire votre dernière ligne de défense.
Cette démonstration montre comment les politiques réseau limitent une attaque au conteneur compromis, contenant ainsi efficacement la menace et vous faisant gagner le temps crucial nécessaire pour mettre en œuvre des mesures correctives.
Vue d'ensemble : défense en profondeur
Les politiques réseau ne sont qu'une couche d'une stratégie globale. Le Layered Zero Trust Validated Pattern combine ces politiques avec les identités de charge de travail SPIFFE/SPIRE (en utilisant Zero Trust Workload Identity Manager), les secrets gérés par Vault, l'authentification centralisée à l'aide d'un fournisseur d'identité (IdP) tel que notre version par défaut Red Hat build of Keycloak, et la surveillance de l'exécution avec Red Hat Advanced Cluster Security for Kubernetes. Les politiques réseau complètent le tableau en garantissant que même en cas de défaillance de l'identité, des secrets et de la sécurité des applications, la couche réseau assure le confinement.
Mais comment savoir si vos politiques réseau fonctionnent réellement, ou si un conteneur compromis sonde de manière répétée vos limites internes ? Que se passe-t-il lorsqu'un exploit zero-day déclenche une connexion refusée ?
Nous aidons à répondre à ces questions cruciales tout au long de cette série d'articles de blog explorant la manière dont le Layered Zero Trust Validated Pattern met en œuvre les pratiques de sécurité de Zero Trust. Voici ce à quoi vous pouvez vous attendre pour la suite :
- Défense active avec Red Hat Advanced Cluster Security for Kubernetes : mise en œuvre d'une surveillance approfondie au moment de l'exécution, analyse automatisée des politiques réseau et alertes en temps réel pour agir comme votre cerveau de sécurité central.
- Identité et secrets : gestion plus sécurisée des identités de charge de travail avec Zero Trust Workload Identity Manager et l'intégration de Vault.
- Chaîne d'approvisionnement : verrouillage de votre chaîne logistique logicielle de bout en bout en imposant des signatures de contenu et en vérifiant les tâches du pipeline pour garantir que seul le code de confiance atteint votre cluster.
Prêt à le voir en action ? N'attendez pas le prochain article pour commencer. Consultez le Layered Zero Trust Validated Pattern pour explorer l'architecture et essayez par vous-même la démonstration des politiques réseau.
Références
- NIST SP 800-207 : Architecture de Zero Trust
- NIST SP 800-207A : Le Zero Trust pour les applications cloud-native
- CISA : Conseils sur la microsegmentation en mode Zero Trust
- Layered Zero Trust Validated Pattern
- Modèles validés
- À la recherche du Graal : Pourquoi le projet Hummingbird de Red Hat vise un nombre de CVE proche de zéro
- Mesures des CVE
Essai de produit
Red Hat OpenShift Container Platform | Essai de produit
À propos de l'auteur
Przemysław “Rogue” Roguski is a Security Architect at Red Hat who specializes in shift-left security initiatives focusing on embedding security best practices and attestation into the earliest stages of the SDLC. He contributes security analysis work on Red Hat OpenShift and other OpenShift-related products. He also designs security solutions and processes across Red Hat.
He contributes to the security ecosystem as a member of the CISA SBOM/VEX working groups, an OASIS OpenEoX Technical Committee member and a key contributor to the CWE program.
Plus de résultats similaires
Les menaces liées à l'IA évoluent. Vos défenses doivent en faire autant.
Au-delà de l'automatisation : pourquoi la montée des vulnérabilités de sécurité liées à l'IA exige une expertise technique humaine
Can Compliance Be A Piece Of Cake? | Compiler
Scaling with Orchestrators | Compiler
Parcourir par canal

Automatisation
Les dernières nouveautés en matière d'automatisation informatique pour les technologies, les équipes et les environnements

Intelligence artificielle
Actualité sur les plateformes qui permettent aux clients d'exécuter des charges de travail d'IA sur tout type d'environnement

Cloud hybride ouvert
Découvrez comment créer un avenir flexible grâce au cloud hybride

Sécurité
Les dernières actualités sur la façon dont nous réduisons les risques dans tous les environnements et technologies

Edge computing
Actualité sur les plateformes qui simplifient les opérations en périphérie

Infrastructure
Les dernières nouveautés sur la plateforme Linux d'entreprise leader au monde

Applications
À l’intérieur de nos solutions aux défis d’application les plus difficiles

Virtualisation
L'avenir de la virtualisation d'entreprise pour vos charges de travail sur site ou sur le cloud
