-
Produits et documentation Red Hat AI
Plateforme de produits et de services pour le développement et le déploiement de l'IA dans le cloud hybride.
Red Hat AI Enterprise
Assemblez, développez et déployez des applications basées sur l'IA dans le cloud hybride.
Red Hat AI Inference
Optimisez les performances des modèles à l'aide d'une pile intégrée pour des opérations d'inférence rapides, cohérentes et économiques à grande échelle.
Red Hat Enterprise Linux AI
Développez, testez et exécutez des modèles d'IA générative pour alimenter les applications d'entreprise.
Red Hat OpenShift AI
Assemblez et déployez des applications et modèles basés sur l'IA à grande échelle dans des environnements hybrides.
-
Se former Notions de base
- Nouveautés de Red Hat AI
- Comprendre l'importance de l'inférence d'IA
- Le framework vLLM, qu'est-ce que c'est ?
- L'inférence d'IA, qu'est-ce que c'est ?
- L'IA agentique, qu'est-ce que c'est ?
- L'AgentOps, qu'est-ce que c'est ?
- Le framework llm-d, qu'est-ce que c'est ?
- Voir tous les thèmes liés à l'IA
- Voir tous les articles de blog sur l'IA
Avantages de Red Hat AI
Ressources techniques
-
Partenaires pour l'IA
Comprendre l'importance de l'inférence d'IA
Pour faire simple, l'IA ne pourrait pas fonctionner sans l'inférence. Cette opération est au cœur de l'IA générative.
Si nous connaissons déjà son potentiel, nous devons maintenant réussir à la mettre à l'échelle.
C'est là qu'interviennent des outils Open Source tels que vLLM et llm-d.
L'importance de l'inférence
L'inférence intervient à la fin du processus, lorsqu'un modèle fournit le résultat souhaité. Il s'agit d'une opération essentielle au bon fonctionnement de l'IA.
C'est pourquoi la réussite des stratégies d'IA dépend du matériel et des logiciels sur lesquels repose l'inférence.
Les architectures basées sur des technologies Open Source sont celles qui offriront le plus d'options de mise à l'échelle.
Les obstacles à la mise à l'échelle
Si elles ont conscience de l'efficacité de l'IA, les entreprises ont parfois du mal à la déployer à grande échelle.
La mise à l'échelle des modèles nécessite davantage de données et de mémoire. Et le matériel et les accélérateurs ne sont pas toujours capables de suivre le rythme.
On pourrait penser que la solution la plus simple est de recourir à un fournisseur tiers. Mais les coûts liés aux jetons textuels peuvent vite augmenter et même dépasser ceux de l'application d'IA elle-même.
40 %
D'ici 2030, l'inférence deviendra la principale charge de travail dans les datacenters d'IA. Elle devrait consommer jusqu'à 40 % de la demande totale des datacenters1.
Les pistes d'amélioration de l'inférence
Lorsque l'inférence est optimisée sur une architecture Open Source, les modèles d'IA s'exécutent plus rapidement et efficacement.
Il existe plusieurs stratégies d'optimisation :
- Compression des modèles à l'aide de techniques de quantification
- Traitement plus efficace des processeurs graphiques (GPU)
- Décodage spéculatif
- Inférence distribuée
- Délégation des tâches d'orchestration et de mémoire aux processeurs
Grâce à ces optimisations, l'inférence d'IA reste économique et peut être mise à l'échelle au rythme de l'évolution de l'entreprise.
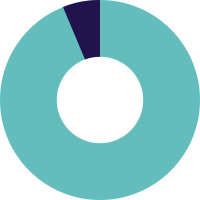
19 %
d'économies à grande échelle grâce aux techniques de décodage spéculatif2

2 fois
plus de débit de calcul grâce à la compression des modèles, sans dégrader la précision3
90 %
de latence absorbée au total de bout en bout par les processeurs4
L'optimisation de l'inférence avec vLLM
L'optimisation des modèles ne représente qu'une partie de la solution : il faut également déployer un moteur d'inférence hautement efficace. C'est là qu'intervient le framework vLLM.
Les systèmes traditionnels de gestion de la mémoire des LLM manquent d'efficacité, ce qui ralentit les performances des LLM. Le framework vLLM utilise le mécanisme PagedAttention, une technique de gestion de la mémoire qui identifie les valeurs clés répétitives pour alléger le travail des LLM.
vLLM peut ainsi utiliser plus efficacement la mémoire GPU et accélérer l'inférence d'IA générative. Le débit (nombre de jetons textuels traités par seconde) peut aussi être optimisé, pour servir plusieurs utilisateurs à la fois.
L'utilisation plus efficace des accélérateurs permet aux modèles d'effectuer plus de calculs en moins de temps. Les équipes peuvent ainsi répondre aux besoins d'un plus grand nombre d'utilisateurs et d'agents.
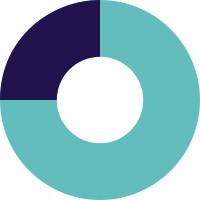
75 %
de diminution des besoins en mémoire, réduisant ainsi le nombre de GPU nécessaires5
4 fois
plus de jetons textuels traités par seconde par rapport à la majorité des fournisseurs d'inférence6
24 fois
plus de débit grâce à vLLM par rapport à la concurrence7
Les avantages du framework vLLM
vLLM a apporté une réponse aux principaux problèmes liés à l'efficacité de l'utilisation des GPU, en réduisant le coût par jeton textuel et en assurant la stabilité de la latence à grande échelle grâce à une approche de déploiement ouverte et portable.
Parce qu'il prend en charge dès la conception tous les principaux modèles et accélérateurs, vLLM est très accessible et intéresse les entreprises comme les milieux universitaires. Ces avancées témoignent du dynamisme de la communauté vLLM,
qui repose notamment sur les contributions de Hugging Face, UC Berkeley, NVIDIA et Red Hat. La communauté teste et améliore sans cesse le framework dans le cadre du projet Open Source.
Plus de 10 000
contributions* au GitHub vLLM en 2026, soit une augmentation de plus de 200 %
La communauté vLLM en quelques chiffres
Plus de 500 000
GPU déployés 24 h/24, 7 j/78
Plus de 200
types d'accélérateurs différents9
Plus de 500
architectures de modèles prises en charge9
Plus de 3 100
La place de l'inférence distribuée
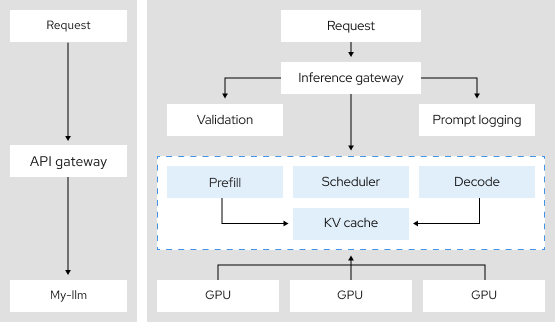
L'inférence distribuée permet aux modèles d'IA de répartir les tâches liées à l'inférence entre plusieurs équipements interconnectés.
Lorsqu'un modèle est capable de répondre simultanément à plusieurs requêtes, les besoins matériels sont considérablement réduits et l'inférence est plus efficace.
L'inférence distribuée repose sur des techniques telles que le parallélisme des tenseurs, l'ordonnancement intelligent des tâches d'inférence et la désagrégation. Et avec vLLM, l'inférence devient une machine multitâche très efficace.
Tous ces avantages rendent l'inférence plus observable, évolutive et cohérente.
99 %
de réduction du délai de génération du premier jeton textuel pour une charge équivalente10

Une communauté Open Source spécialisée dans l'inférence
Il existe une communauté qui se spécialise dans l'inférence, et qui se nomme llm-d.
llm-d est un framework Open Source qui propose aux équipes de développement un modèle pour mettre en place l'inférence distribuée à grande échelle.
Grâce à son architecture modulaire, ce framework gère les besoins complexes en ressources des LLM plus évolués. Il remplace les processus manuels et fragmentés par des schémas bien définis et intégrés qui permettent d'accélérer la mise en production.
llm-d intègre l'inférence à Kubernetes, offrant ainsi une boîte à outils standardisée aux entreprises qui souhaitent appliquer l'inférence distribuée à leur propre cas d'utilisation.
2 fois
plus d'utilisateurs pris en charge sur le même matériel reposant sur des clusters optimisés avec llm-d11
Autres ressources sur l'IA
Red Hat AI Inference
Accélérez la mise en production de vos LLM.
Basé sur vLLM, notre moteur d'inférence pour les entreprises permet d'accélérer l'inférence sans dégrader les performances.
Avec Red Hat AI Inference, passez au cloud hybride et déployez le modèle d'IA générative optimisé de votre choix, avec tout accélérateur d'IA et dans tout type d'environnement cloud.

Sources citées
[1] « The future of AI workloads », McKinsey & Company, 24 février 2026.
[2] Umesh, Harshith, « Performance improvements with speculative decoding in vLLM for gpt-oss », blog Red Hat Developer, 16 avril 2026.
[3] Kurtić, Eldar, et coll., « 2:4 Sparse Llama: Smaller models for efficient GPU inference », blog Red Hat Developer, 28 février 2025.
[4] Bowerman, Sawyer, Ableidinger, Grace, « Le retour du processeur : repenser la séparation entre le processeur et le GPU pour l'inférence des LLM », blog Red Hat, 6 août 2026.
[5] « What is LLM Compressor? », documents vLLM.
[6] « vLLM Tops the Artificial Analysis Leaderboard », blog vLLM, 11 mai 2026.
[7] Kwon, Woosuk, et coll., « vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention », blog vLLM, 20 juin 2023.
[8] Goin, Michael, « [vLLM Office Hours #38] vLLM 2025 Retrospective & 2026 Roadmap », YouTube, 18 décembre 2025.
[9] Kwon, Woosuk, « Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale », X, 26 janvier 2026.
[10] Singh, Naina, « Routage optimisé pour l'inférence pour les clusters LLM », blog Red Hat, 27 mai 2026.
[11] Singh, Naina, « Routage optimisé pour l'inférence pour les clusters LLM », blog Red Hat, 27 mai 2026.
