Si vous utilisez de grands modèles de langage (LLM) ou concevez des applications basées sur ceux-ci, le concept le plus important à comprendre est sans doute le fonctionnement de l'inférence et du cache clé-valeur (KV). En effet, que vous travailliez avec des agents de codage, la génération augmentée de récupération (RAG) ou le réglage fin, l'inférence correspond à ce qui se produit chaque fois que vous envoyez une requête à un modèle et recevez une réponse (et constitue donc la part principale des dépenses).
Alors que la formation n'a lieu qu'une seule fois, l'inférence se produit chaque fois qu'un utilisateur envoie une invite. Voyons donc comment cela fonctionne, ce qu'est le cache clé-valeur et les optimisations que la plupart des équipes utilisent pour réduire les coûts d'infrastructure et la latence.
L'inférence est une pile, pas un simple fichier de modèle
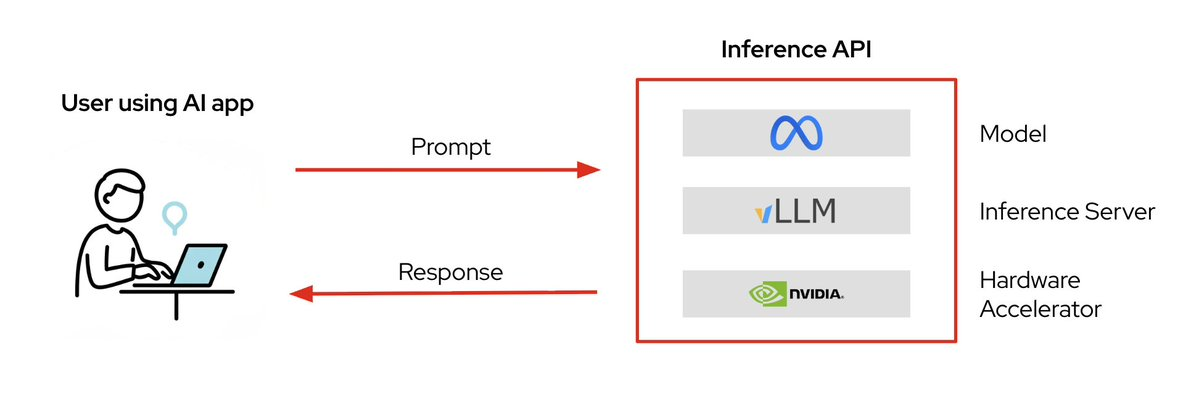
Figure 1 : La mise à disposition d'un modèle nécessite trois éléments fonctionnant ensemble : les pondérations, un serveur d'inférence et le matériel sous-jacent.
Un modèle installé sur votre machine (ou sur HuggingFace) n'est pour l'instant utile à personne. Pour que l'inférence soit possible, trois éléments doivent fonctionner ensemble :
- Pondérations du modèle : le ou les fichiers contenant les milliards de paramètres appris (Kimi, GLM, Qwen ou le modèle de votre choix).
- Serveur d'inférence : des logiciels tels que vLLM qui chargent le modèle, gèrent les requêtes entrantes et appliquent les optimisations présentées ci-dessous.
- Accélérateur matériel : généralement un GPU, qui effectue les calculs numériques intensifs.
Vous pouvez ignorer la couche intermédiaire et exécuter un modèle directement sur un GPU avec PyTorch. Cette approche fonctionne très bien pour un notebook ou un utilisateur unique. Cependant, dès que vous devez servir plusieurs personnes à la fois, le serveur d'inférence permet d'utiliser le GPU à l'échelle de la production (comme lorsque vous ouvrez un fichier HTML en local plutôt que de le distribuer via un serveur HTTP Apache).
Les modèles génèrent un jeton textuel à la fois
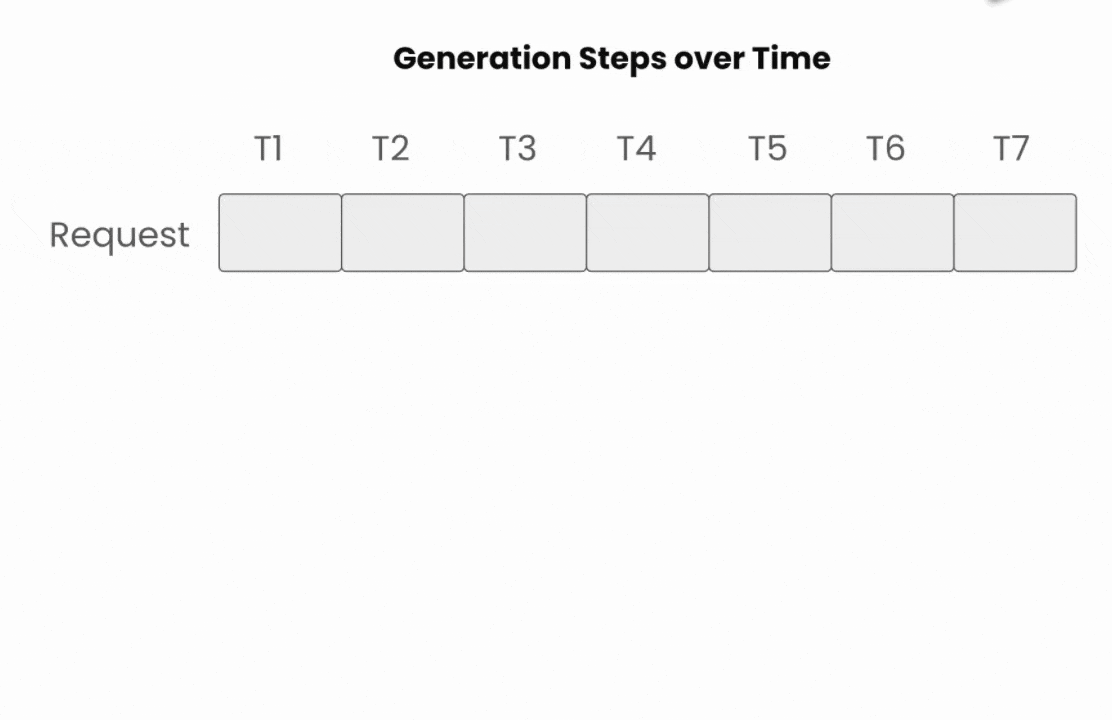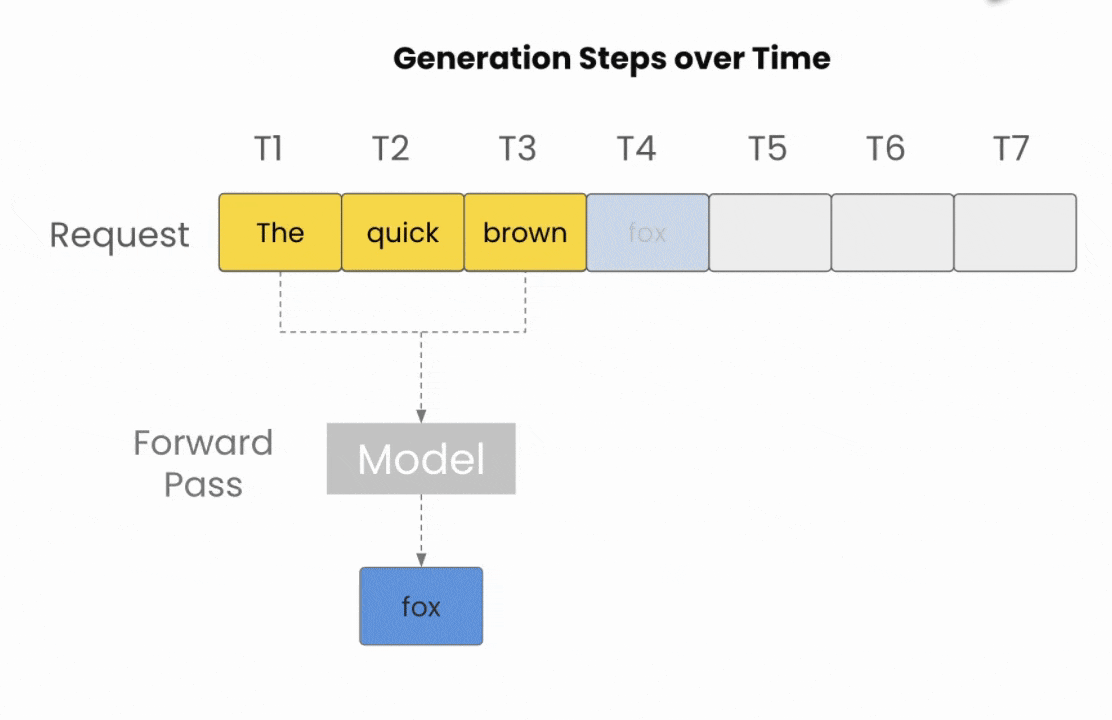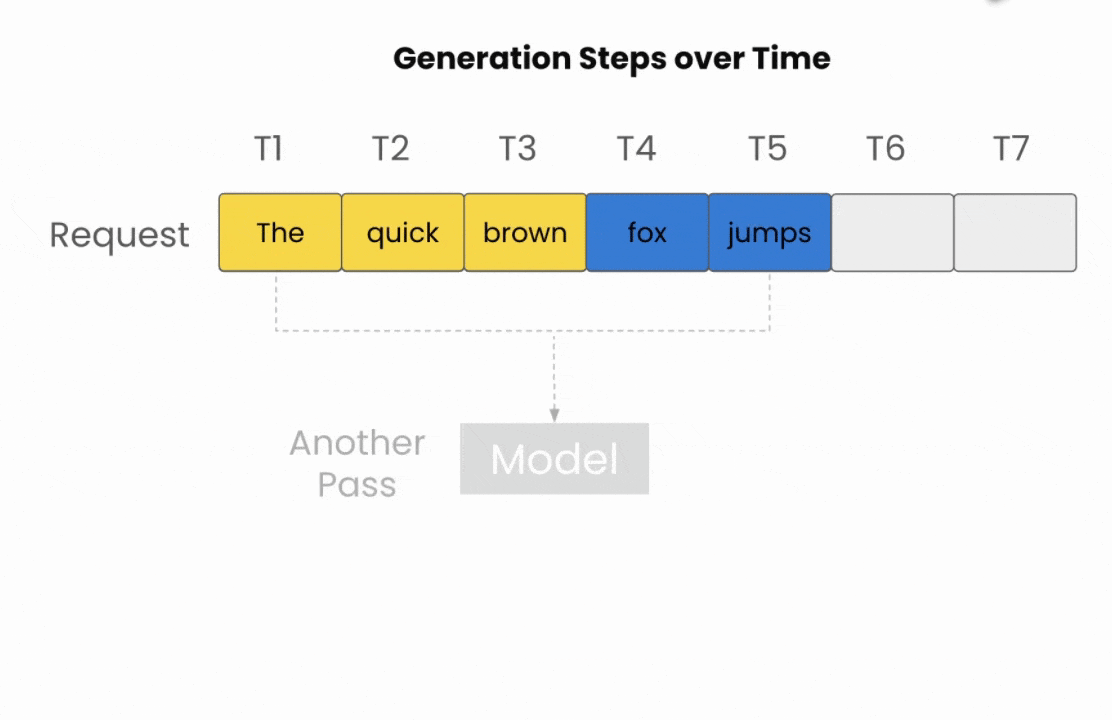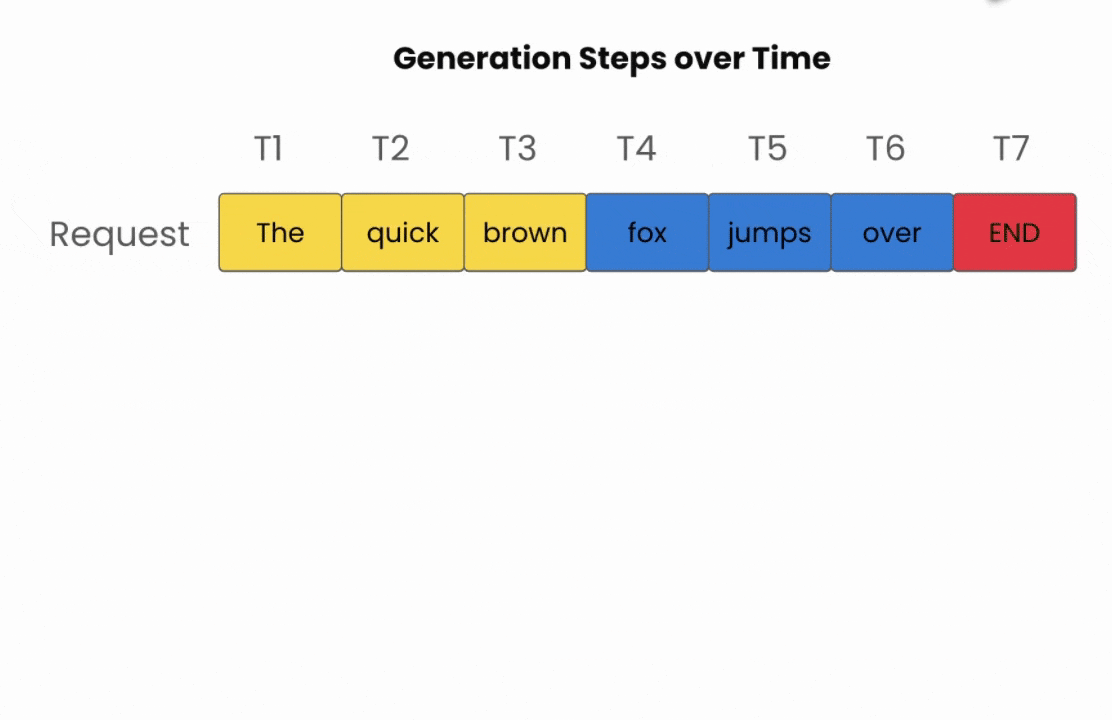
Figure 2 : Chaque propagation avant produit exactement un nouveau jeton textuel, qui est ensuite réinjecté pour produire le suivant.
Les LLM ne produisent pas de longues réponses en une seule fois : ils génèrent un jeton textuel à la fois et chaque nouveau jeton dépend de tous les jetons qui le précèdent (y compris ceux que le modèle vient de générer lui-même).
Prenons l'exemple d'une invite : « The quick brown »
- Le modèle prédit « fox » → qui est ajouté
- « The quick brown fox » → il prédit « jumps » → ajouté
- Et ainsi de suite, jusqu'à ce que le modèle émette un jeton textuel spécial de fin de séquence.
C'est le principe de la génération autorégressive, et ce que l'on sous-estime souvent, c'est que chaque jeton textuel d'une réponse nécessite une propagation complète dans le modèle. Une réponse de 500 jetons textuels implique 500 exécutions du modèle, ce qui illustre la rapidité avec laquelle les besoins en ressources de calcul augmentent.
Pourquoi le cache clé-valeur existe
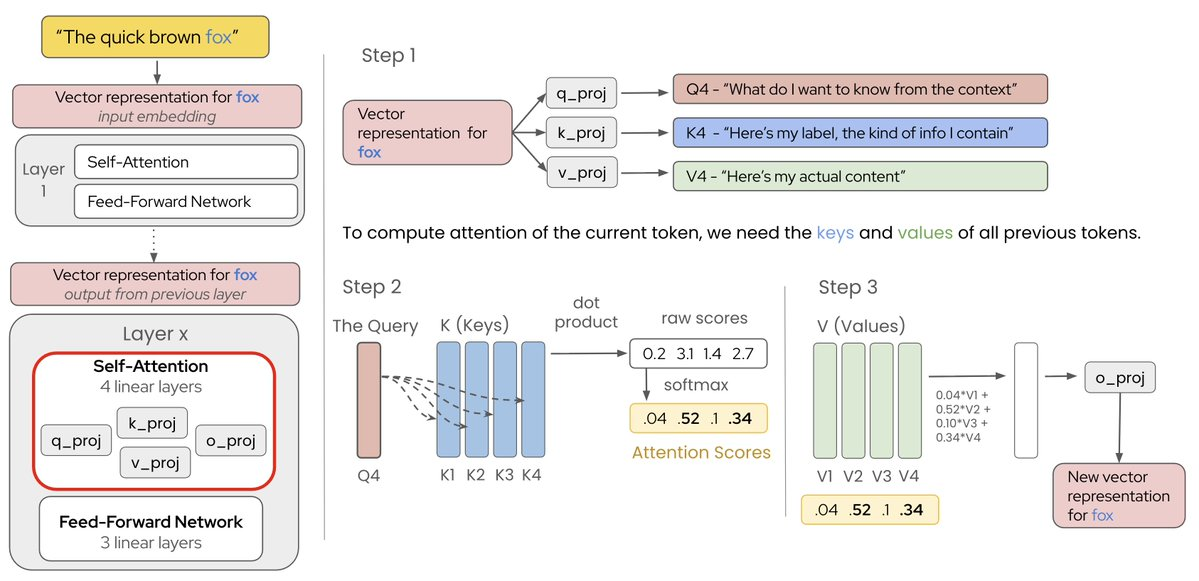
Figure 3 : Chaque jeton textuel passe par le bloc d'attention de chaque couche, en comparant sa requête aux clés et aux valeurs de tous les éléments qui le précèdent.
À chacun de ces passages, les jetons textuels deviennent des plongements (une représentation numérique) qui traversent une pile de couches de transformateur, et chaque couche possède un bloc d'auto-attention dans lequel les jetons interagissent entre eux. C'est là que commence le problème de mémoire.
Le mécanisme d'attention calcule trois vecteurs par jeton textuel :
- Q, la requête : ce que ce jeton textuel cherche à extraire du contexte
- K, la clé : le type d'informations qu'il contient
- V, la valeur : son contenu réel
Pour générer le jeton textuel suivant, vous comparez sa requête à la clé de chaque jeton précédent et calculez la somme pondérée des valeurs.
Mais ! Voici le point essentiel : la requête n'est nécessaire que pour le jeton textuel en cours. Les clés et les valeurs sont requises pour l'ensemble de l'historique, mais elles ne changent pas. La clé et la valeur du jeton textuel 4 sont identiques à l'étape 5 et à l'étape 4.
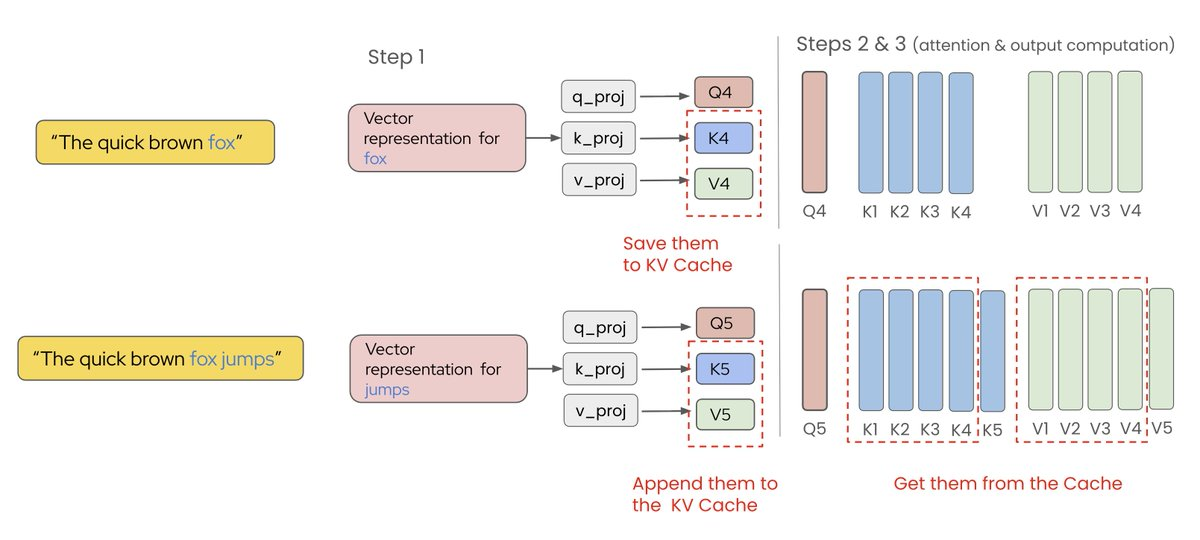
Figure 4 : Comme les clés et les valeurs des jetons textuels précédents ne changent jamais, elles sont enregistrées une seule fois et réutilisées au lieu d'être recalculées à chaque étape.
Plutôt que de les recalculer à chaque étape, nous les enregistrons dans la mémoire GPU et calculons uniquement K et V pour le nouveau jeton textuel. C'est le principe du cache clé-valeur ; il intervient sur chacune des N couches du modèle, ce qui multiplie les gains par N.
Quelle taille le cache clé-valeur peut-il atteindre ?
Chaque jeton textuel doit avoir ses clés et ses valeurs stockées à chaque couche, avec plusieurs ensembles parallèles par couche (les têtes KV). La formule est la suivante :
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
Prenons l'exemple de gpt-oss-120b : 36 couches, 8 têtes KV, une dimension de tête de 64, 2 octets par valeur. Cela représente environ 72 Ko par jeton textuel, mais comme gpt-oss ne conserve l'historique complet que sur la moitié de ses couches, le volume effectif est plus proche de 36 Ko par jeton textuel.
- 2k (un tour de discussion classique) : ~75 Mo
- 8k (niveau de production standard) : ~300 Mo
- 32k (un long document ou un référentiel de code) : ~1,2 Go
- 128k (maximum pour gpt-oss) : ~4,8 Go
Et il s'agit d'un modèle optimisé pour un déploiement efficace. Un modèle dense de 70B avec 80 couches et une dimension de tête de 128 (comme Llama 3.3 70B) nécessite près de 320 Ko par jeton textuel, soit 9 fois plus pour la même conversation. C'est pourquoi les choix d'architecture de modèle sont essentiels pour maîtriser vos coûts d'IA.
Où passe votre budget GPU
Un modèle comme gpt-oss-120b tient sur un seul GPU NVIDIA H100 de 80 Go. C'était une avancée majeure à la sortie du modèle, mais après avoir chargé les pondérations sur la carte, il ne reste qu'environ 15 à 20 Go de marge pour le cache clé-valeur et les frais généraux d'inférence. Servir de véritables utilisateurs devient alors complexe, par exemple :
- Si votre serveur réserve de la mémoire par requête selon le contexte maximal possible (comme le faisaient les méthodes antérieures), chaque requête mobilise 4,8 Go, qu'elle les utilise ou non. Cela ne représente que trois utilisateurs simultanés sur un GPU H100. Ouf !
- Si vous allouez plutôt l'espace réellement consommé par chaque requête, une requête standard de 8k n'occupe que 300 Mo. Même carte, même modèle, 50 ou 60 utilisateurs. Le matériel reste identique, mais la différence réside entièrement dans la gestion de la mémoire GPU, d'où l'importance de ce sujet.
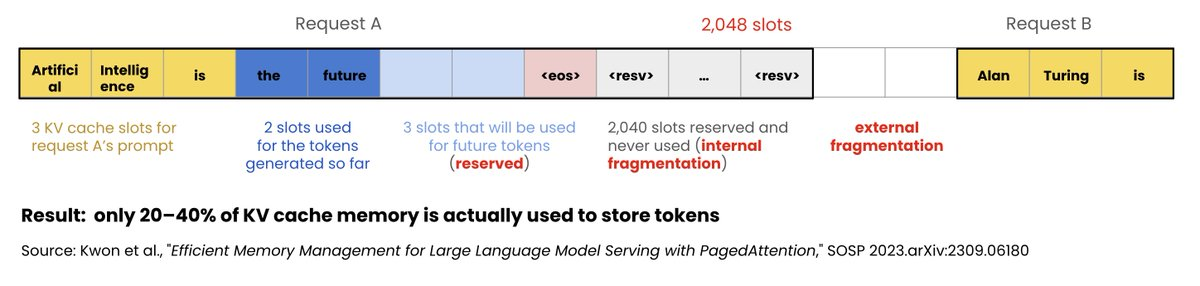
Figure 5 : Réserver de la mémoire pour la longueur de contexte maximale laisse la majeure partie du cache clé-valeur vide.
Comment les serveurs d'inférence de production, tels que vLLM, traitent-ils ce problème ?
Principalement grâce à trois mécanismes :
1. PagedAttention
PagedAttention divise le cache clé-valeur en petits blocs de taille fixe pouvant être situés n'importe où en mémoire, avec une table de suivi localisant les blocs de chaque requête. Aucun espace n'est réservé pour un contexte qui pourrait ne jamais être utilisé. Si vous avez déjà travaillé avec la mémoire virtuelle dans un SE, le principe est identique : c'est de là que vient l'idée.
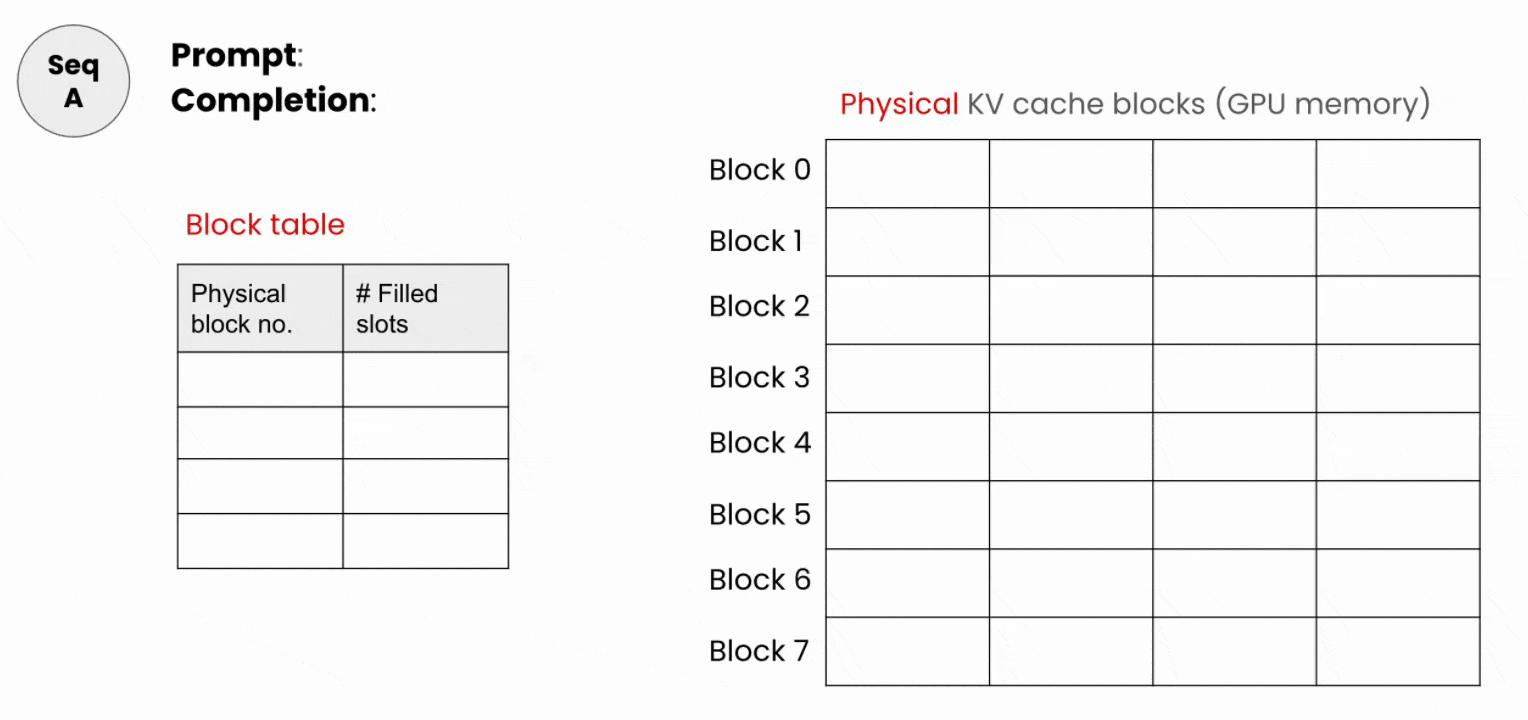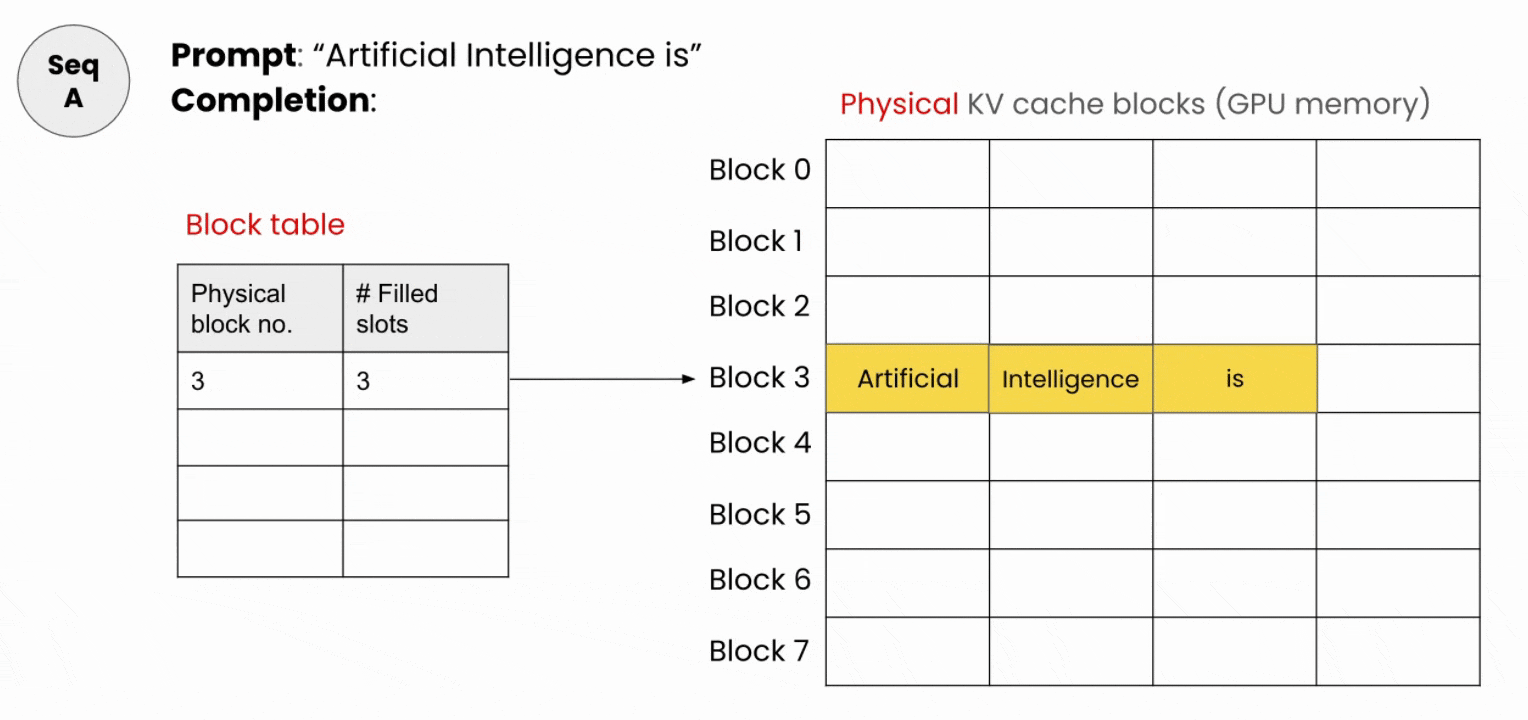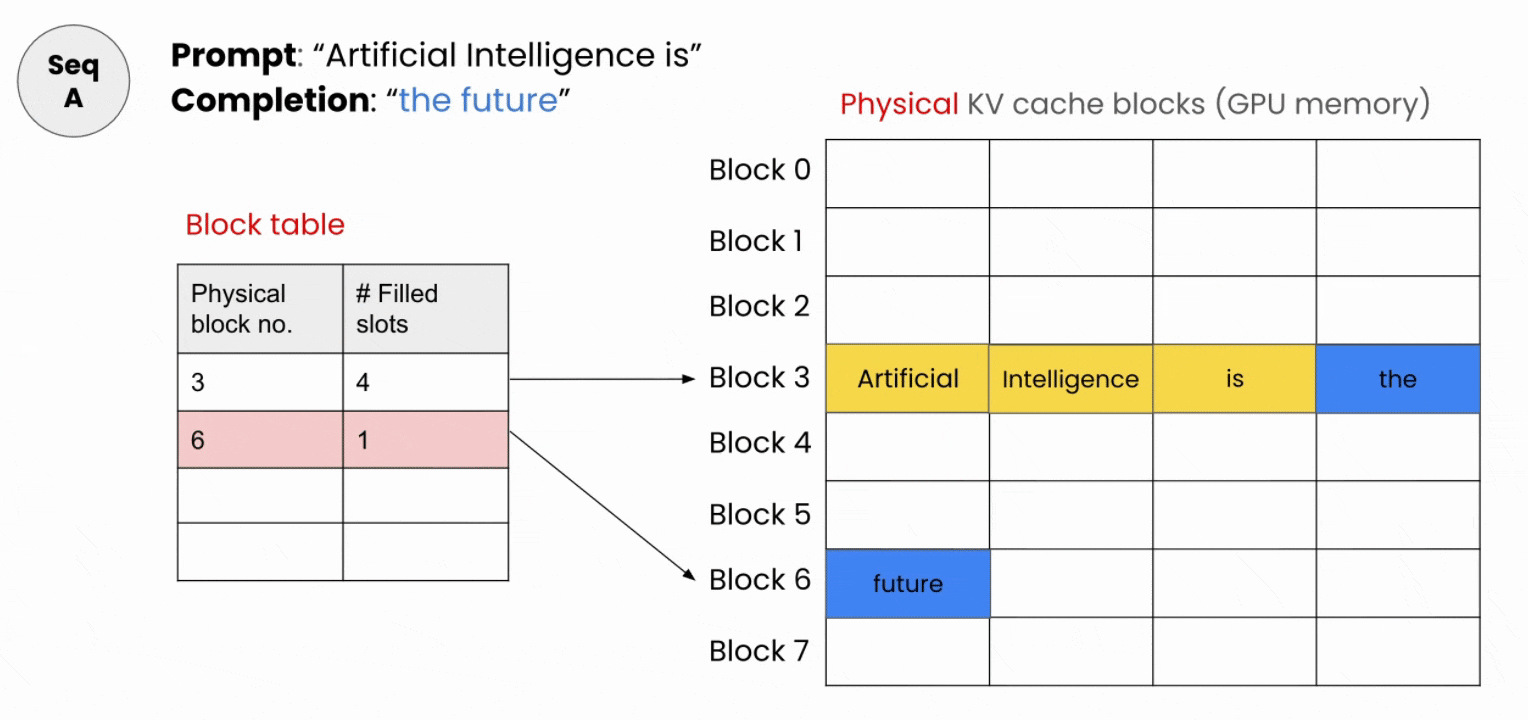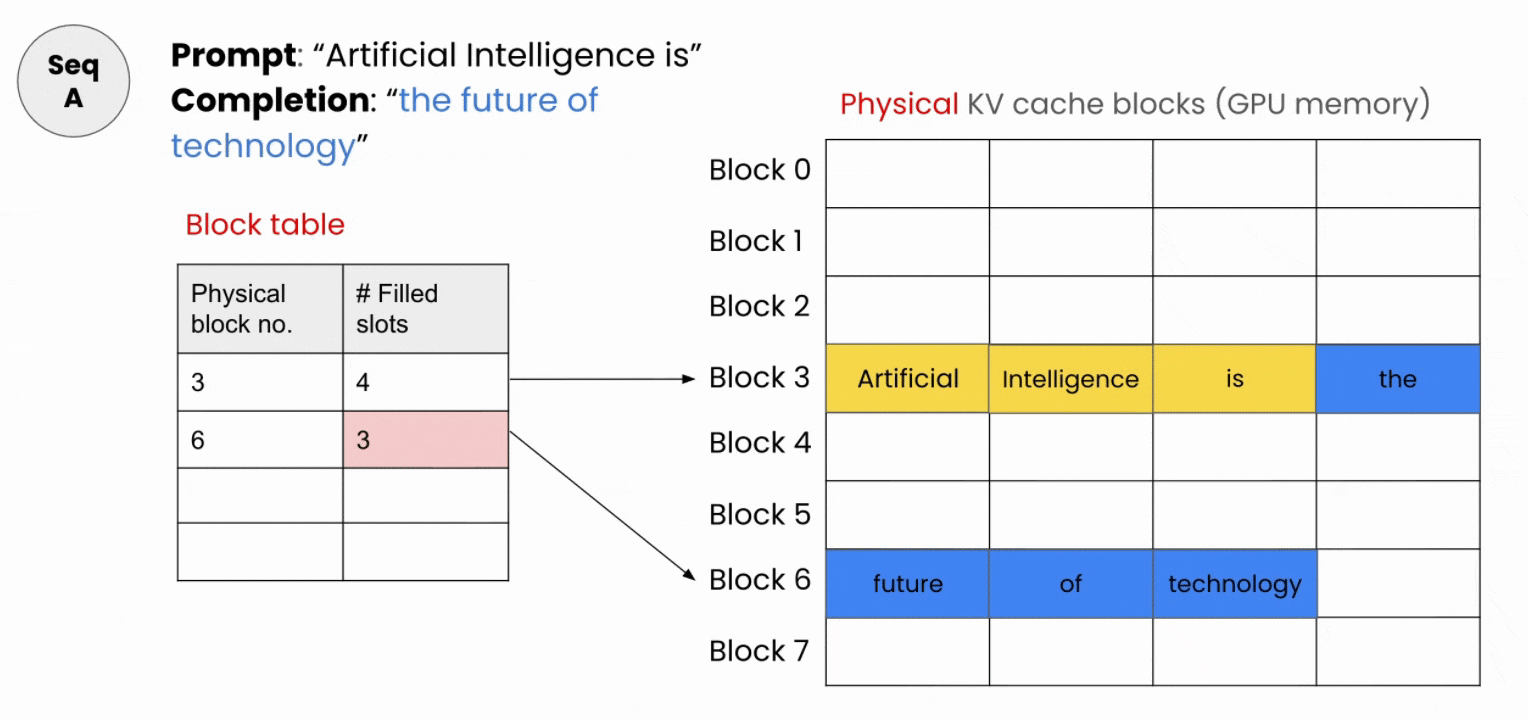
Figure 6 : PagedAttention répartit le cache en petits blocs de taille fixe et les suit via une table de recherche, évitant ainsi toute réservation initiale.
2. Traitement par lots continu
Avec le traitement par lots continu, au lieu d'attendre la finalisation de tout un lot, les requêtes terminées sont libérées et de nouvelles s'insèrent dès qu'un emplacement se libère. Le GPU reste alimenté.
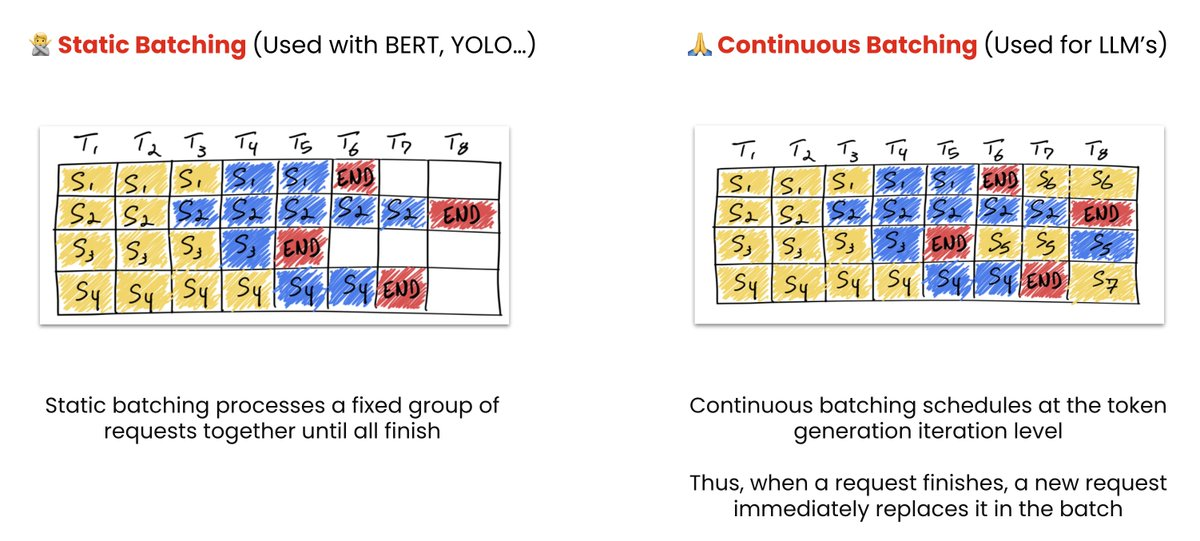
Figure 7 : Le traitement par lots statique contraint chaque requête à attendre la plus lente, tandis que le traitement par lots continu comble immédiatement chaque emplacement libéré.
3. Mise en cache des préfixes
Lorsque des requêtes partagent un préfixe (une invite système, un document récupéré, le même fichier de référentiel dans le contexte d'un agent de codage), les clés et valeurs mises en cache sont réutilisées au lieu d'être recalculées.
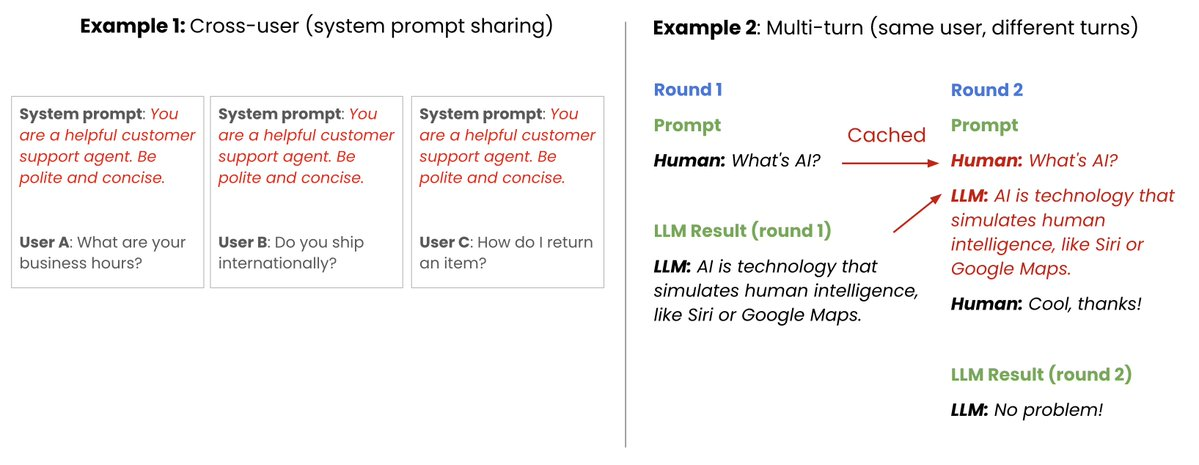
Figure 8 : Lorsque des requêtes partagent le même texte de début, le travail déjà effectué pour ce préfixe est réutilisé au lieu d'être recalculé.
Aucune de ces méthodes ne modifie le modèle, mais elles améliorent l'efficacité de son exécution.
La réduction de la taille du modèle lui-même
La quantification est une méthode permettant de stocker les pondérations (ou les activations) avec une précision moindre afin de réduire leur empreinte mémoire et d'accélérer les calculs. La plupart des modèles sont fournis au format BF16, soit 16 bits par paramètre. En passant au format FP8 (virgule flottante 8 bits) ou INT8 (entier 8 bits), vous divisez par deux la quantité de mémoire utilisée sans compromettre la précision de base. En passant à 4 bits, vous la réduisez à un quart. Par exemple, tous les modèles quantifiés du dépôt Hugging Face de Red Hat AI conservent plus de 99 % de leur précision initiale.
Le modèle gpt-oss-120b est un exemple intéressant, car l'optimisation a déjà été effectuée. Avec 117B paramètres en BF16, les pondérations occuperaient environ 234 Go et nécessiteraient trois GPU de 80 Go pour être chargées. OpenAI a post-entraîné le modèle avec une quantification MXFP4 sur les pondérations MoE (Mixture of Experts), ce qui permet de le faire passer sous les 80 Go et de l'exécuter sur une seule carte.
- BF16 (hypothétique) : ~234 Go → 3 GPU
- MXFP4, tel que fourni : tient sur un seul GPU de 80 Go
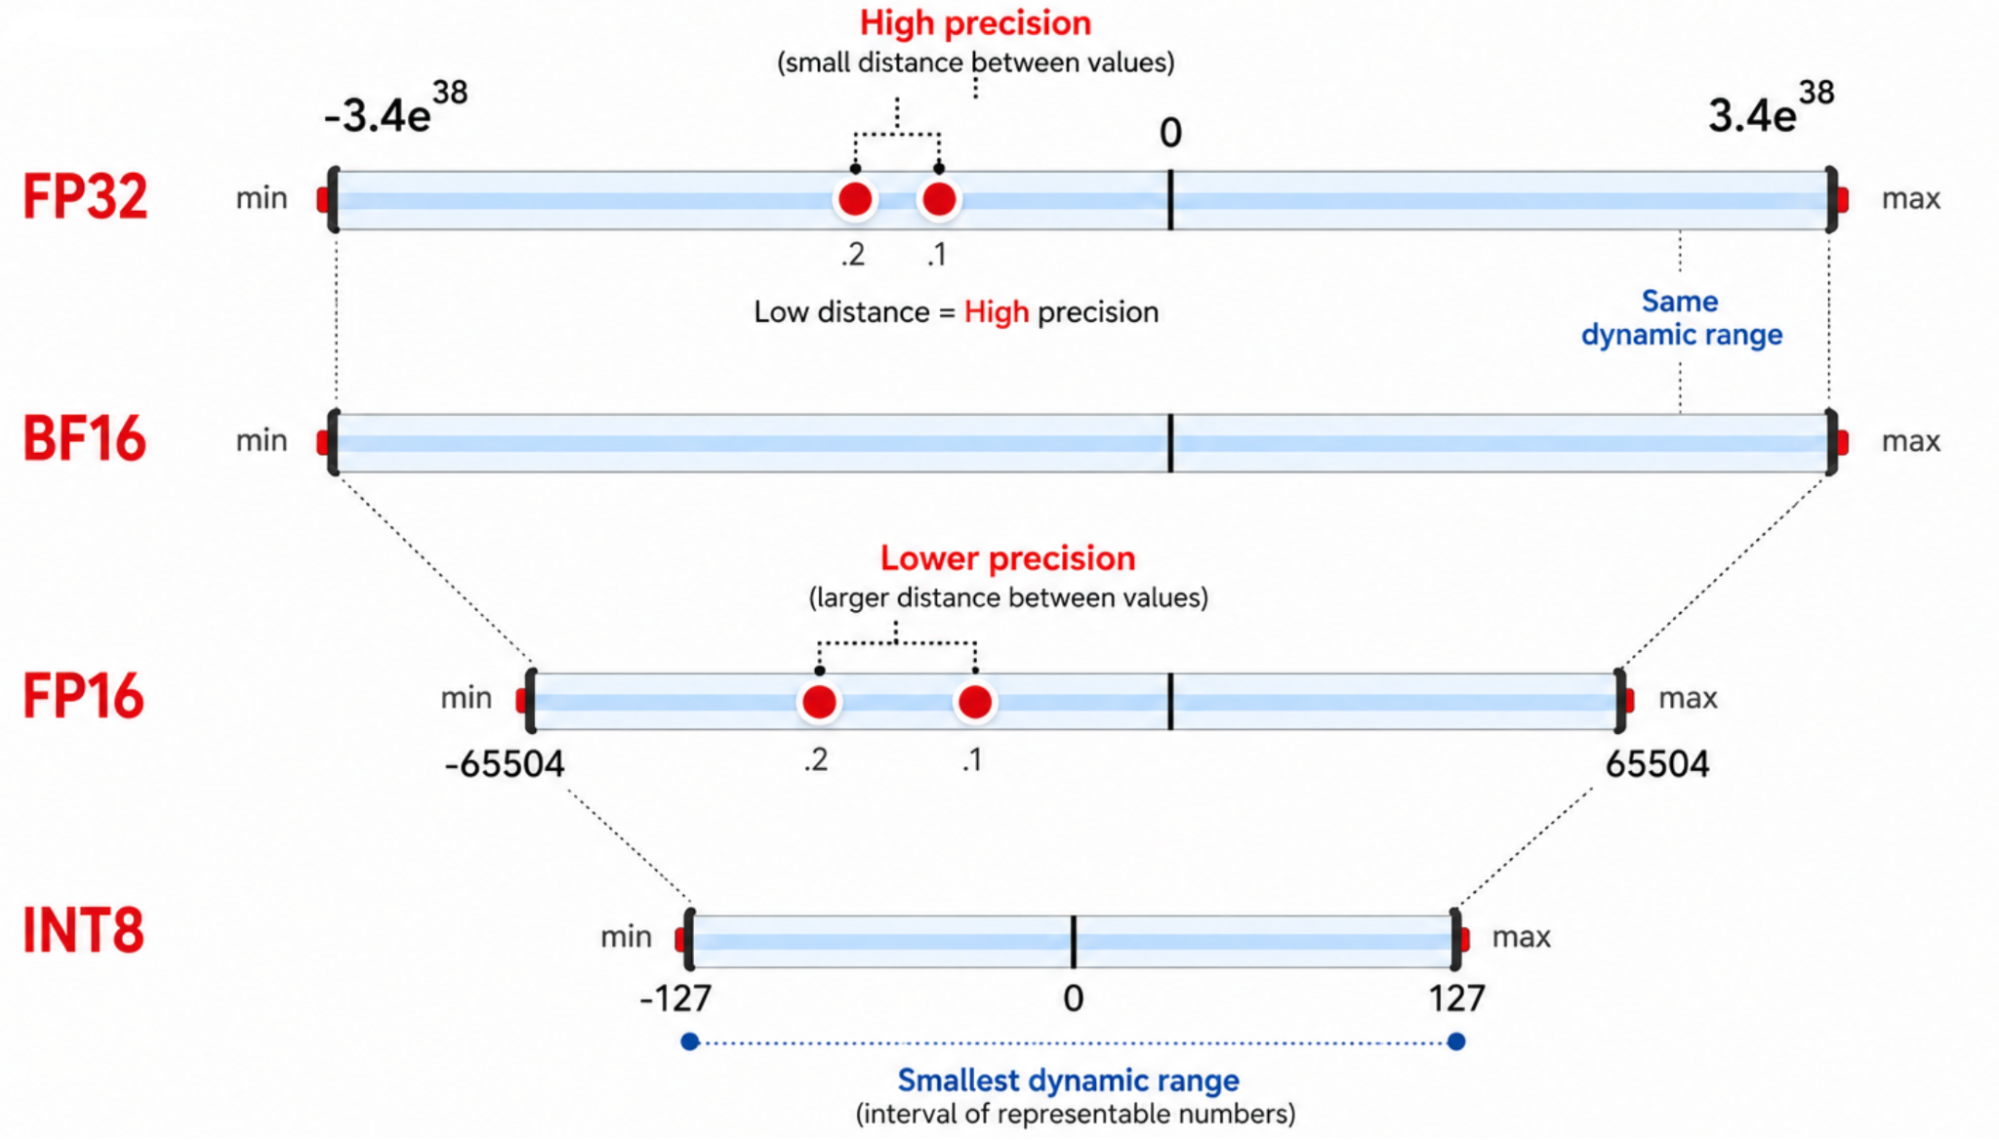
Figure 9 : Les formats numériques de moindre précision réduisent l'étendue et le niveau de détail en échange d'une empreinte mémoire considérablement réduite.
La plupart des modèles ne sont pas fournis sous cette forme : vous devez alors réaliser la conversion vous-même ou utiliser nos modèles compressés sur HuggingFace. En fin de compte, la quantification apporte deux avantages majeurs. Des pondérations quantifiées réduisent le volume de données transférées de la mémoire à large bande passante (HBM) vers la mémoire vive statique (SRAM) à chaque propagation avant, ce qui améliore la latence. Des activations quantifiées permettent aux cœurs Tensor d'effectuer les calculs avec une moindre précision et d'exécuter davantage d'opérations par seconde, ce qui améliore le débit. Les approches limitées aux pondérations telles que W8A16 (pondération 8 bits, activation 16 bits) apportent le premier gain, tandis que des formats comme W8A8 (pondération Int8, activation Int8) combinent les deux.
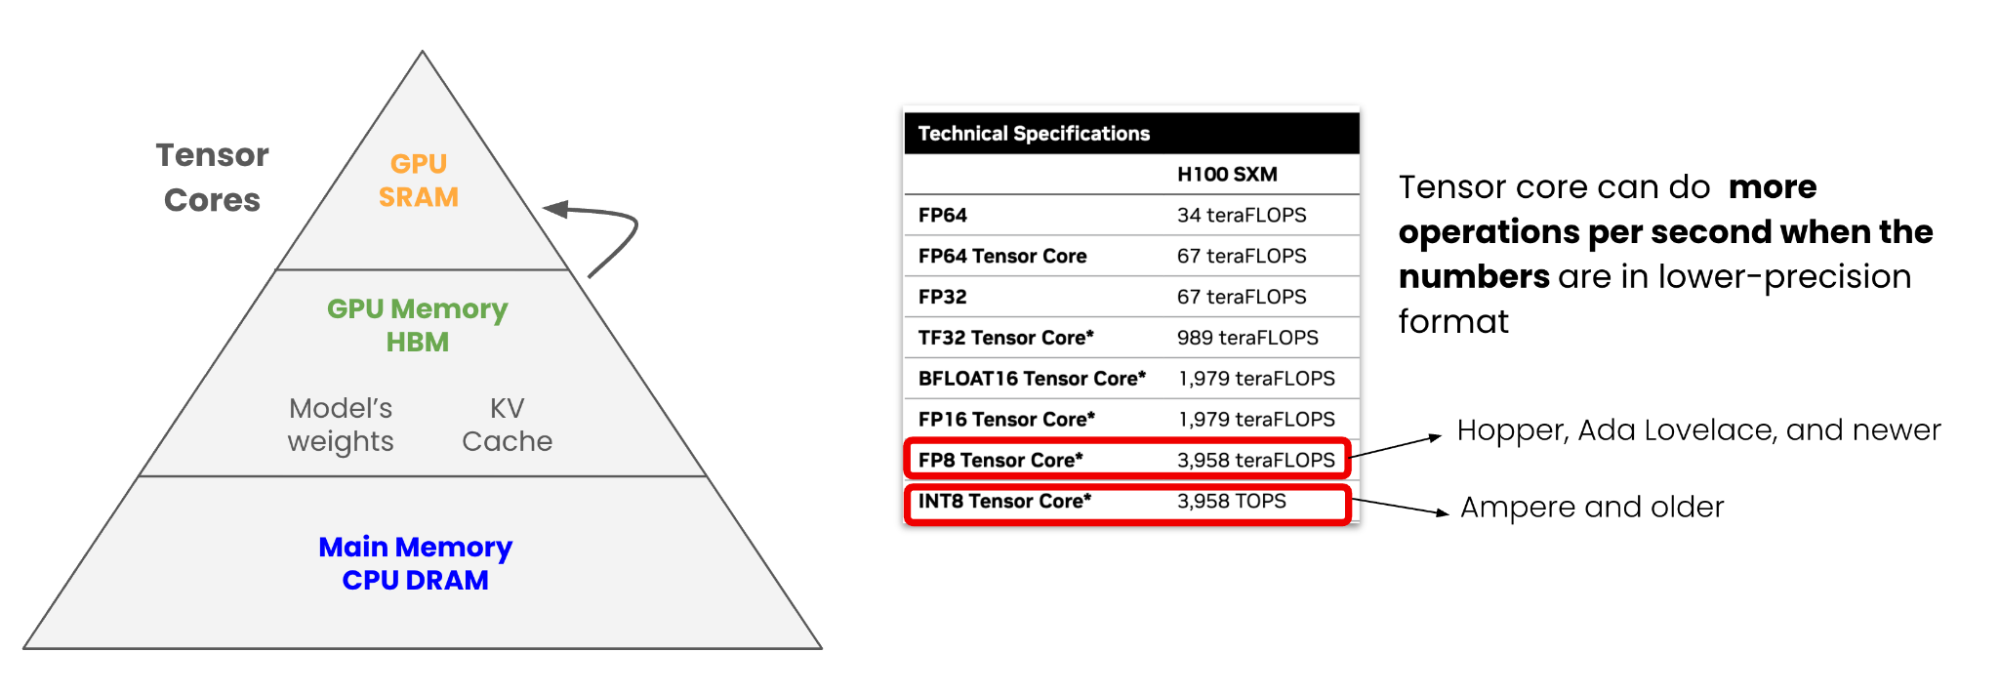
Figure 10 : Des pondérations plus légères sont transférées plus vite vers la mémoire la plus rapide du GPU, et les calculs de faible précision s'exécutent avec un débit bien plus élevé sur les cœurs Tensor.
En pratique, le format FP8 réduit vos besoins en mémoire de moitié et multiplie le débit jusqu'à 1,6 fois avec un impact minimal sur la précision. Et non, cela ne dégrade pas les capacités du modèle. Des techniques calibrées telles que GPTQ (generalized post-training quantization), AWQ (activation-aware weight quantization) et SmoothQuant s'appuient sur un échantillon représentatif de données pour identifier et préserver les pondérations essentielles, limitant la perte de qualité à moins d'un point de pourcentage.
Aide-mémoire pour l'optimisation des modèles d'IA
Technique | Champ d'application | Avantages |
PagedAttention | Environnement d'exécution | Davantage de requêtes simultanées dans la même mémoire |
Traitement par lots continu | Environnement d'exécution | Le GPU reste actif entre les requêtes |
Mise en cache des préfixes | Environnement d'exécution | Évite le recalcul sur le contexte partagé |
Quantification | Modèle, avant déploiement | Moins de GPU, chargement plus rapide, calculs accélérés |
Sparsification | Modèle, avant déploiement | Ignore les pondérations les moins importantes |
La formation représente un coût ponctuel ; l'inférence constitue la dépense récurrente et représente la majeure partie de la facture. Chaque jeton textuel nécessite une propagation avant complète. Le cache clé-valeur augmente avec la longueur du contexte et le nombre d'utilisateurs simultanés, et sa gestion constitue la tâche principale de votre serveur d'inférence. Dans notre exemple, l'écart entre un déploiement standard et un déploiement optimisé sur le même GPU est d'environ trois utilisateurs simultanés contre 50. En optimisant l'inférence, vous tirerez bien plus parti du matériel dont vous disposez déjà.
P.-S. Si vous avez apprécié cet article !
Si vous souhaitez tester ces principes par vous-même, nous avons conçu un cours pratique et gratuit avec DeepLearning.AI et Red Hat : quantifiez un modèle Qwen avec LLM Compressor et évaluez le compromis de précision, mettez-le en service avec vLLM, effectuez des bancs d'essai avec GuideLLM et évaluez-le avec lm-eval : Fast & Efficient LLM Inference with vLLM.
Ressource
Bien débuter avec l'inférence d'IA
À propos de l'auteur
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
Plus de résultats similaires
Inférence d'IA distribuée : ce que les opérateurs de télécommunications doivent savoir
Pourquoi l'IA agentique nécessite une pile d'inférence ouverte
Parcourir par canal

Automatisation
Les dernières nouveautés en matière d'automatisation informatique pour les technologies, les équipes et les environnements

Intelligence artificielle
Actualité sur les plateformes qui permettent aux clients d'exécuter des charges de travail d'IA sur tout type d'environnement

Cloud hybride ouvert
Découvrez comment créer un avenir flexible grâce au cloud hybride

Sécurité
Les dernières actualités sur la façon dont nous réduisons les risques dans tous les environnements et technologies

Edge computing
Actualité sur les plateformes qui simplifient les opérations en périphérie

Infrastructure
Les dernières nouveautés sur la plateforme Linux d'entreprise leader au monde

Applications
À l’intérieur de nos solutions aux défis d’application les plus difficiles

Virtualisation
L'avenir de la virtualisation d'entreprise pour vos charges de travail sur site ou sur le cloud
