Dans l'enseignement supérieur comme dans les entreprises, les organisations font face à une hausse des coûts de virtualisation, à l'évolution des modèles de licences et à des décisions architecturales qui ne peuvent plus être différées. Dans ce contexte, les responsables informatiques ont besoin d'une stratégie de migration peu perturbatrice qui protège les charges de travail critiques aujourd'hui tout en établissant une base de cloud hybride moderne pour l'avenir.
À l'occasion du Red Hat Summit 2026, Joseph Seegmiller, ingénieur en infrastructure à l'université Brigham Young, a rejoint les architectes de solutions Red Hat John Quigley et John Call pour relever précisément ces défis. En utilisant Red Hat OpenShift pour exécuter des machines virtuelles (VM) et des conteneurs côte à côte, l'université Brigham Young a consolidé son infrastructure et simplifié son exploitation.
Nous avons finalement décidé de migrer l'ensemble de notre virtualisation vers Red Hat OpenShift Virtualization. En seulement six semaines, nous avons migré 1 500 machines virtuelles.
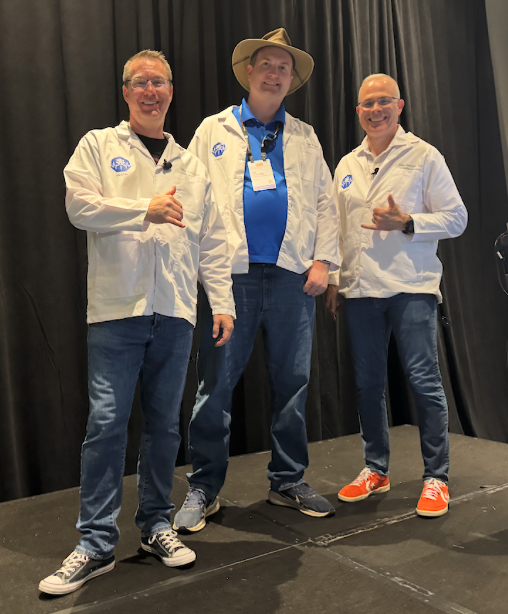
Figure 1. Joseph Seegmiller, ingénieur en infrastructure à l'université Brigham Young, a rejoint sur scène les architectes de solutions Red Hat John Quigley et John Call.
Bien qu'une migration rapide constitue une étape importante, le maintien d'une haute disponibilité et la protection des charges de travail de bases de données stateful une fois sur la nouvelle plateforme restent la priorité absolue des équipes d'infrastructure.
Le risque sous-jacent de corruption des données dans les environnements de stockage partagé
Pour bâtir une plateforme résiliente, les responsables informatiques doivent comprendre comment Red Hat OpenShift gère les défaillances de nœuds différemment des hyperviseurs traditionnels. Par défaut, lorsqu'un nœud exécutant des VM ou des charges de travail conteneurisées ne répond plus, il ne replanifie pas instantanément les charges de travail affectées. Ce délai est une fonction de sécurité délibérée conçue pour protéger l'intégrité des données.
Dans un environnement de stockage partagé, un scénario de split-brain (littéralement, « cerveau scindé ») représente une menace majeure. Si un nœud perd la communication avec le plan de contrôle du cluster mais reste sous tension, il peut encore écrire des données sur le disque.
Si un nœud perd sa connectivité réseau mais que sa connexion Fibre Channel reste active, les machines virtuelles continuent de s'exécuter et d'écrire sur le disque. La replanification automatique de cette machine virtuelle sur un nouveau nœud monte deux fois le disque, ce qui provoque une grave corruption des données. C'est pourquoi le redémarrage et le fencing (isolement forcé d’un nœud) automatisés des nœuds sont indispensables.
Sans correction automatisée, la résolution de ces défaillances nécessite une intervention manuelle. L'opérateur doit vérifier que le nœud défaillant est complètement hors ligne avant de mettre fin en toute sécurité à l'ancienne instance de VM et d'en démarrer une nouvelle. Dans un environnement de grande envergure, ce processus manuel engendre d'importants retards de reprise.
La panne a transformé les tableaux de bord de notre équipe d'exploitation en véritable sapin de Noël avec une multitude de voyants clignotants. Il nous a fallu deux heures pour résoudre ce problème. Si nous avions mis en œuvre ces stratégies de correction des nœuds, le système aurait résolu le problème en quelques minutes au lieu de plusieurs heures.
Récupération automatisée en quelques minutes avec Medik8s
Pour éliminer les corrections manuelles et réduire les temps d'arrêt de plusieurs heures à quelques minutes seulement, Red Hat OpenShift intègre le framework d'opérateur Medik8s. Ce framework assure la correction automatisée des nœuds et la haute disponibilité des charges de travail, y compris les VM.
Le processus de récupération automatisé fonctionne à travers trois composants distincts :
- Opérateur Node Health Check : ce composant agit comme un détecteur de fumée pour le cluster. Il surveille en permanence l'état des nœuds de calcul. Si un nœud signale un état NotReady ou Unknown pendant la durée configurée (60 secondes en général), l'opérateur émet une alerte et déclenche un modèle de correction.
- Fence Agents Remediation (FAR) : il s'agit de la méthode de fencing basée sur l'alimentation la plus rapide. Il interagit directement avec les interfaces BMC (Baseboard Management Controller) du matériel physique, telles que Dell iDRAC ou HPE iLO, à l'aide de l'API Redfish standard. L'agent commande au BMC de redémarrer le matériel. Dès que le BMC confirme le cycle d'alimentation, le cluster supprime en toute sécurité les charges de travail de VM et de conteneurs bloquées et les replanifie sur des nœuds sains, achevant l'opération en environ 155 secondes.
- Self Node Remediation (SNR) : faisant office de solution de repli logicielle fiable, cet agent utilise un watchdog au niveau du noyau. L'agent doit interagir avec le minuteur du watchdog toutes les 30 secondes. Si l'agent détecte que le nœud est isolé de ses pairs et du serveur d'API, il cesse de réinitialiser le minuteur du watchdog (ou de « caresser le watchdog » dans le jargon des administrateurs système). Le délai du watchdog expire alors et force le système d'exploitation local à redémarrer, libérant ainsi ses verrous de stockage en toute sécurité.
En déployant ces stratégies, les équipes d'infrastructure protègent les VM contre la corruption des données tout en assurant une reprise automatique sans intervention humaine.
Rééquilibrage des charges de travail actives à l'aide de la pression réelle sur les ressources
Pour atteindre la haute disponibilité, il ne suffit pas de surmonter les pannes de nœuds. Cela requiert également une distribution proactive des charges de travail pour éviter que les nœuds ne s'épuisent en ressources.
L'ordonnanceur Kubernetes par défaut évalue uniquement les décisions de placement des ressources lors du démarrage initial d'une VM. Au fil du temps, à mesure que les utilisateurs se connectent ou exécutent des tâches intensives, certaines VM peuvent consommer plus de ressources que prévu initialement, entraînant une saturation des ressources sur certains nœuds.
Pour corriger ce déséquilibre, l'opérateur Descheduler évalue régulièrement le cluster. Au lieu de s'appuyer uniquement sur des demandes de ressources statiques et préallouées, le Descheduler peut exploiter les données de consommation des ressources en temps réel fournies par l'interface Pressure Stall Information (PSI) du noyau.
Les métriques PSI mesurent le temps passé par les VM ou les conteneurs à attendre des ressources de processeur, de mémoire ou de disque (E/S). Si le Descheduler détecte qu'un nœud subit une pression sur ses ressources, il identifie les VM éligibles et lance une migration à chaud pour les déplacer vers des nœuds sous-utilisés. Ce rééquilibrage proactif garantit des performances applicatives constantes sur l'ensemble du parc.
Modernisez votre stratégie d'infrastructure
La migration vers une plateforme unifiée d'applications de cloud hybride aide les entreprises à maîtriser leurs coûts opérationnels, à éliminer les silos d'infrastructure et à établir un environnement sécurisé pour le développement d'applications modernes. En associant Red Hat OpenShift Virtualization à la correction automatisée et au rééquilibrage proactif des charges de travail, les responsables informatiques peuvent garantir une haute disponibilité prévisible pour leurs charges de travail les plus critiques.
Passez à l'étape suivante de votre parcours de modernisation de la virtualisation :
Générer un rapport automatisé sur l'état de préparation à la migrationPage affichée en Anglais (Français non disponible) : évaluez instantanément l'état de préparation de vos charges de travail VMware pour la migration grâce à l'outil gratuit Red Hat OpenShift Migration Advisor.- Télécharger le guide d'architecture : accédez à des instructions pas à pas, à des plans d'architecture et aux bonnes pratiques pour migrer vers Red Hat OpenShift Virtualization.
- Découvrir les démonstrations interactives : observez Red Hat OpenShift Virtualization en action et découvrez comment gérer des VM et des conteneurs depuis une console unique et unifiée.
Ressource
15 bonnes raisons d'adopter Red Hat OpenShift Virtualization
À propos de l'auteur
Debbie Margulies is a principal product marketing manager for Red Hat OpenShift and has been at Red Hat since 2019 through the acquisition of StackRox.
Plus de résultats similaires
Pourquoi les décisions concernant la virtualisation ne cessent d'être reportées
Gérer des machines virtuelles sur Red Hat OpenShift avec Service Mesh
Virtualization Is (Still) King | Compiler
Parcourir par canal

Automatisation
Les dernières nouveautés en matière d'automatisation informatique pour les technologies, les équipes et les environnements

Intelligence artificielle
Actualité sur les plateformes qui permettent aux clients d'exécuter des charges de travail d'IA sur tout type d'environnement

Cloud hybride ouvert
Découvrez comment créer un avenir flexible grâce au cloud hybride

Sécurité
Les dernières actualités sur la façon dont nous réduisons les risques dans tous les environnements et technologies

Edge computing
Actualité sur les plateformes qui simplifient les opérations en périphérie

Infrastructure
Les dernières nouveautés sur la plateforme Linux d'entreprise leader au monde

Applications
À l’intérieur de nos solutions aux défis d’application les plus difficiles

Virtualisation
L'avenir de la virtualisation d'entreprise pour vos charges de travail sur site ou sur le cloud
