Se você estiver usando ou desenvolvendo com base em large language models (LLMs), talvez o conceito mais importante a entender seja como a inferência e o cache de chave-valor (KV) funcionam. Isso porque não importa se você está trabalhando com agentes de codificação, geração aumentada de recuperação (RAG) ou ajuste fino; a inferência é o que acontece toda vez que você faz uma solicitação a um modelo e recebe uma resposta (e, portanto, para onde vai todo o dinheiro).
Enquanto o treinamento acontece uma vez, a inferência acontece toda vez que um usuário envia um prompt. Então, vamos analisar como isso funciona, o que é o cache KV e quais otimizações a maioria das equipes usa para economizar em custos de infraestrutura e reduzir a latência.
A inferência é uma stack, não um arquivo de modelo
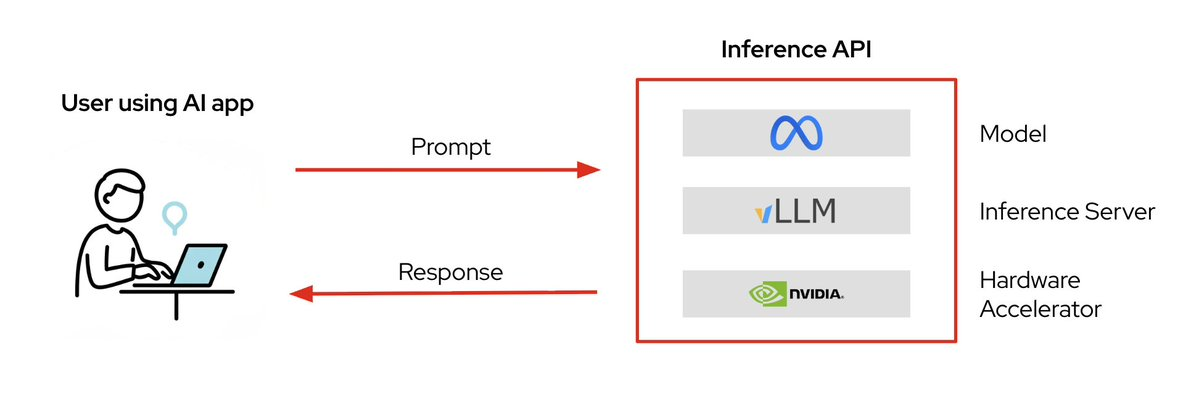
Figura 1: Disponibilizar um modelo exige três partes trabalhando juntas: os pesos, um servidor de inferência e o hardware subjacente.
Um modelo parado na sua máquina (ou no HuggingFace) ainda não atende a ninguém. Para a inferência ser possível, você precisa de três elementos trabalhando juntos:
- Pesos do modelo: os arquivos com os bilhões de parâmetros aprendidos: Kimi, GLM, Qwen ou qualquer outro escolhido.
- Servidor de inferência: softwares como o vLLM, que carregam o modelo, gerenciam as solicitações recebidas e processam as otimizações abordadas a seguir.
- Acelerador de hardware: geralmente uma GPU, responsável pelo trabalho numérico pesado.
Você pode ignorar a camada intermediária e executar um modelo diretamente em uma GPU com o PyTorch. Isso funciona bem para um notebook ou um único usuário. No entanto, a partir do momento em que você precisa atender a várias pessoas ao mesmo tempo, o servidor de inferência é o que torna a GPU utilizável em escala de produção (pense em abrir um arquivo HTML localmente em comparação a disponibilizá-lo utilizando o servidor HTTP Apache).
Os modelos geram um token por vez
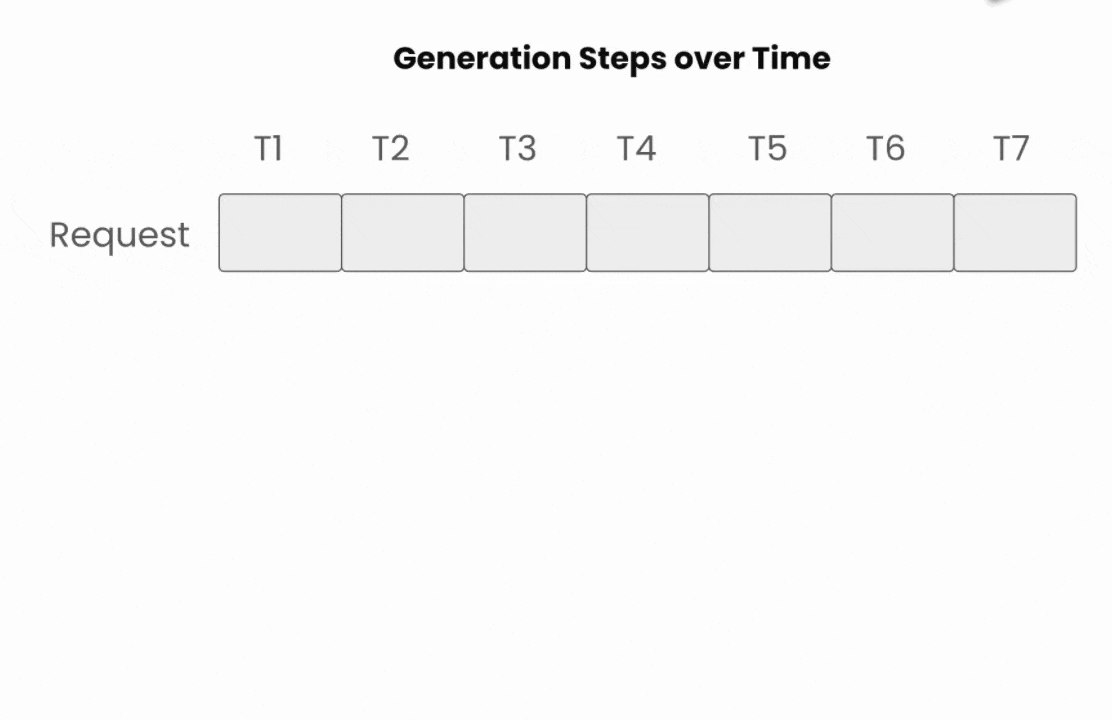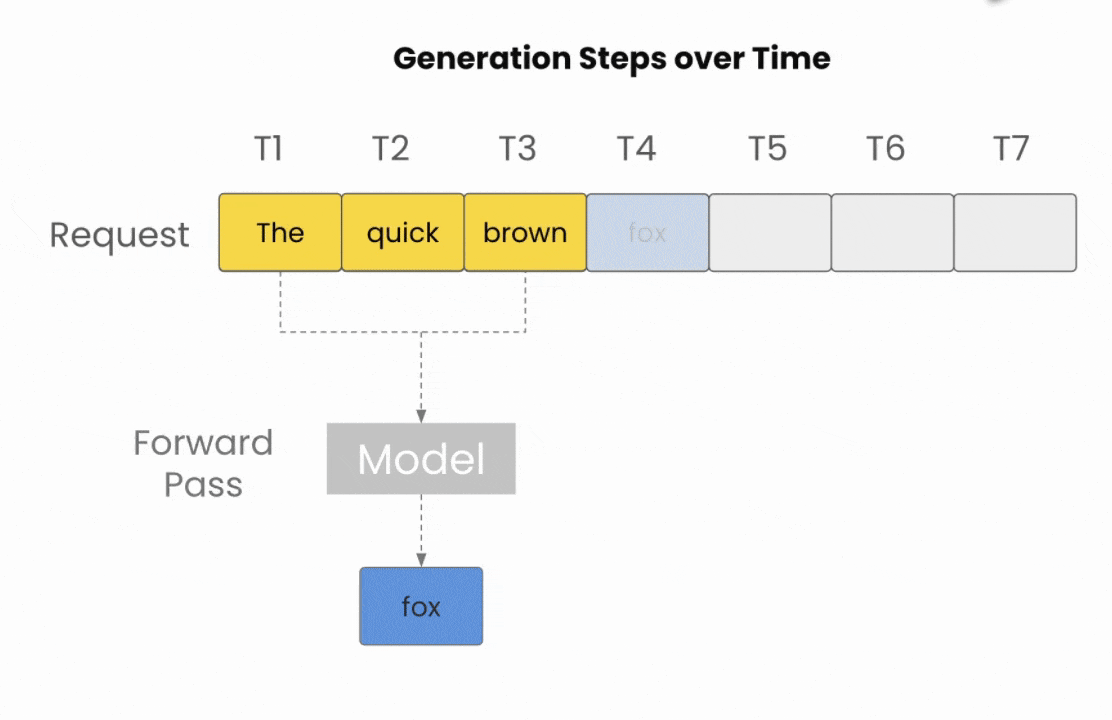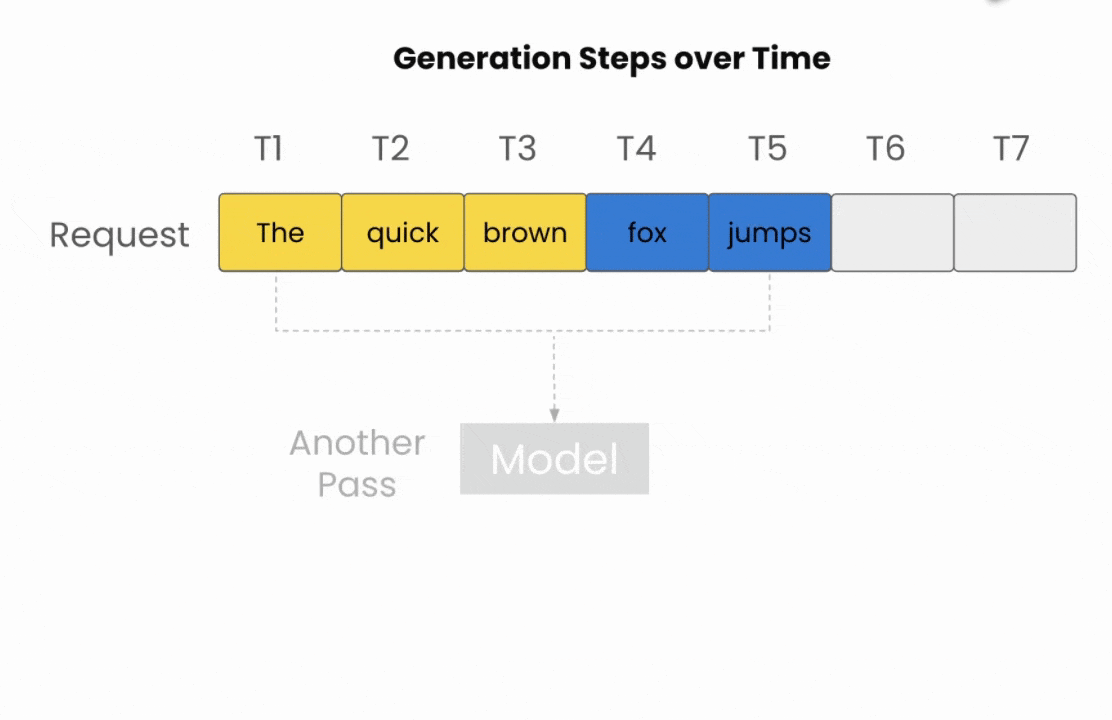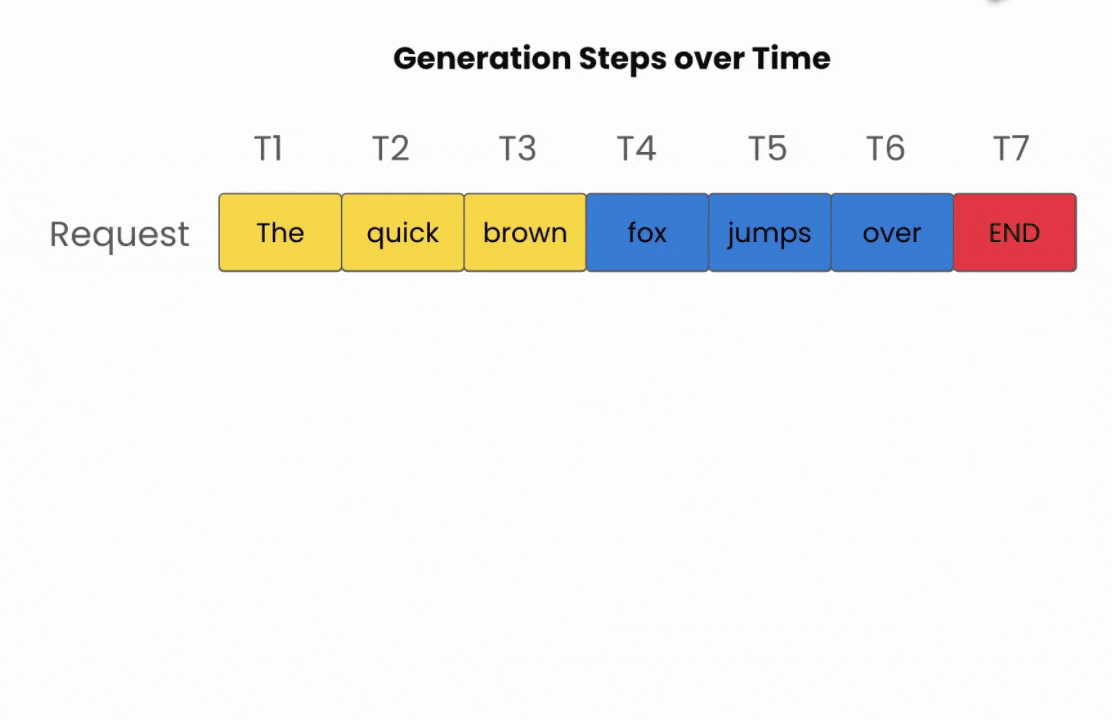
Figura 2: Cada passagem direta produz exatamente um novo token, o qual é então retroalimentado para produzir o próximo.
Os LLMs não produzem respostas longas de uma só vez; eles produzem um token por vez, e cada novo token depende de todos os tokens anteriores a ele (incluindo aqueles que o próprio modelo acabou de gerar).
Então, se começarmos com um exemplo de prompt: "The quick brown"
- O modelo prevê "fox" → que é anexado
- "The quick brown fox" → ele prevê "jumps" → anexado
- E assim por diante, até que o modelo emita um token especial de fim de sequência.
Essa é a geração autorregressiva, e o que as pessoas subestimam é que cada token em uma resposta exige uma passagem completa pelo modelo. Uma resposta de 500 tokens significa que o modelo é executado 500 vezes, e aqui você vê como a demanda de computação pode começar a crescer.
Por que o cache KV existe
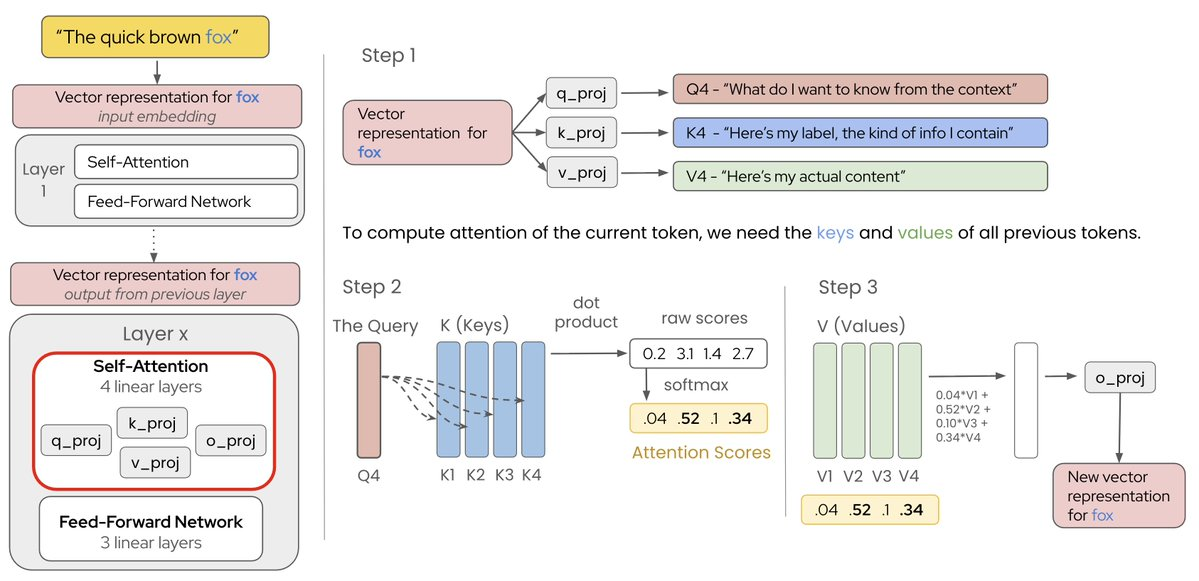
Figura 3: Cada token passa pelo bloco de atenção de cada camada, comparando sua consulta com as chaves e os valores de tudo o que veio antes dele.
Dentro de cada uma dessas etapas, os tokens se tornam embeddings (uma representação numérica) para fluir por uma pilha de camadas de transformadores, e cada camada tem um bloco de autoatenção onde os tokens interagem entre si. É aí que começa o problema de memória.
A atenção calcula três vetores por token:
- Q, a consulta: o que esse token quer saber do contexto
- K, a chave: o tipo de informação que ele contém
- V, o valor: seu conteúdo real
Para gerar o próximo token, você compara a consulta dele com a chave de cada token até o momento e calcula a soma ponderada dos valores.
Mas... Veja o que é realmente importante: a consulta só é necessária para o token atual. As chaves e os valores são necessários para todo o histórico, mas eles não mudam. A chave e o valor do token 4 são os mesmos na etapa 5 e na etapa 4.
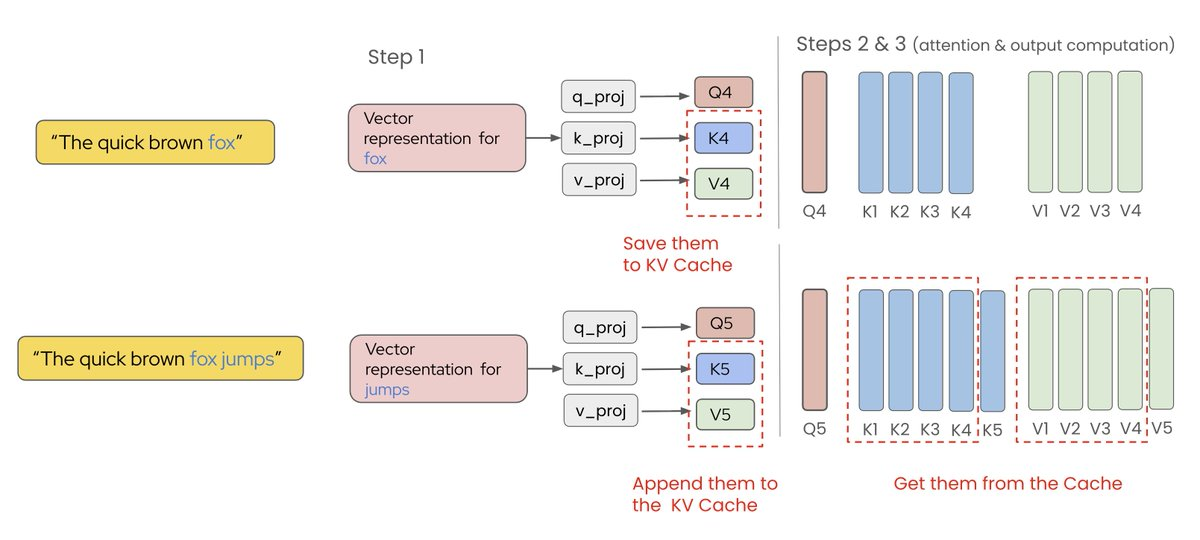
Figura 4: Como as chaves e os valores dos tokens anteriores nunca mudam, eles são salvos uma vez e reutilizados, em vez de recalculados a cada etapa.
Portanto, em vez de recalculá-los a cada etapa, nós os salvamos na memória da GPU e calculamos K e V apenas para o novo token. Esse é o cache KV, e isso acontece em cada uma das N camadas do modelo. Portanto, a economia se multiplica por N.
Qual é o tamanho real do cache KV?
Cada token precisa ter suas chaves e valores armazenados em cada camada, com vários conjuntos paralelos por camada (as cabeças KV). A fórmula é:
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
Portanto, vejamos o gpt-oss-120b: 36 camadas, 8 cabeças de KV, uma dimensão de cabeça de 64, 2 bytes por valor. Isso representa cerca de 72 KB por token, mas o gpt-oss mantém o histórico completo em apenas metade de suas camadas. Portanto, o número que realmente aumenta é mais próximo de 36 KB por token.
- 2k (um turno típico de chat): ~75 MB
- 8k (camada de produção padrão): ~300 MB
- 32k (um documento ou codebase longo): ~1,2 GB
- 128k (máximo do gpt-oss): ~4,8 GB
E esse é um modelo desenvolvido para ser eficiente na disponibilização. Um modelo denso de 70B com 80 camadas e dimensão de 128 cabeças (como o Llama 3.3 70B) fica próximo de 320 KB por token, o que é 9× mais para a mesma conversa. É por isso que as escolhas de arquitetura de modelo são muito importantes para controlar os custos de IA.
Para onde vai o orçamento da sua GPU
Um modelo como o gpt-oss-120b cabe em uma única GPU NVIDIA H100 de 80 GB. Isso foi um grande marco quando o modelo foi lançado, mas após carregar os pesos na placa, restam apenas cerca de 15 a 20 GB de espaço para o cache KV e a sobrecarga de inferência. Atender usuários reais agora se torna complicado, por exemplo:
- Se o seu servidor reservar memória por solicitação, dimensionada para o contexto máximo que essa solicitação pode alcançar (como delineavam as abordagens anteriores), cada solicitação custará 4,8 GB, quer ela use esse espaço ou não. Isso representa apenas três usuários simultâneos em uma H100. Que sufoco.
- Se você alocar apenas o que cada solicitação realmente usa, uma solicitação típica de 8k consumirá 300 MB. Mesma placa, mesmo modelo, 50 ou 60 usuários. Isso no mesmo hardware, mas a diferença está totalmente na forma como a memória da GPU é gerenciada, e é por isso que esse tópico é tão importante.
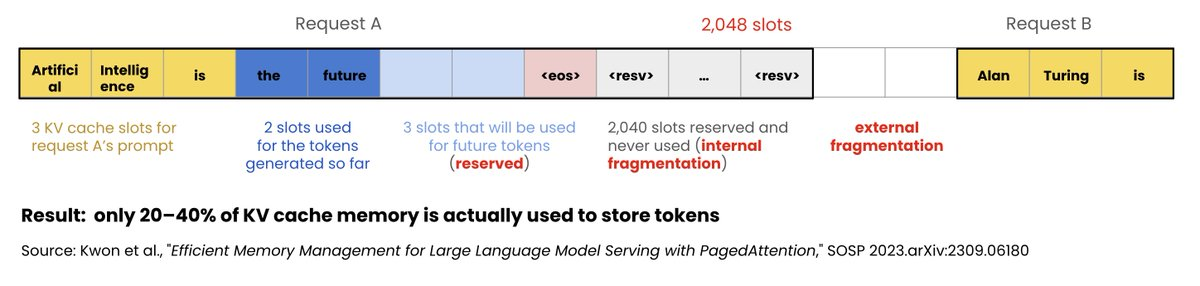
Figura 5: Reservar memória para o tamanho de contexto do pior caso deixa a maior parte do cache KV vazia.
O que os servidores de inferência em produção, como o vLLM, fazem a respeito?
Bem, três coisas, principalmente:
1. PagedAttention
O PagedAttention divide o cache KV em pequenos blocos de tamanho fixo que podem ficar em qualquer lugar da memória, com uma tabela rastreando onde estão os blocos de cada solicitação. Nada é reservado para contextos que você talvez nunca use. Se você já trabalhou com memória virtual em um sistema operacional, isso parecerá familiar; é daí que vem a ideia.
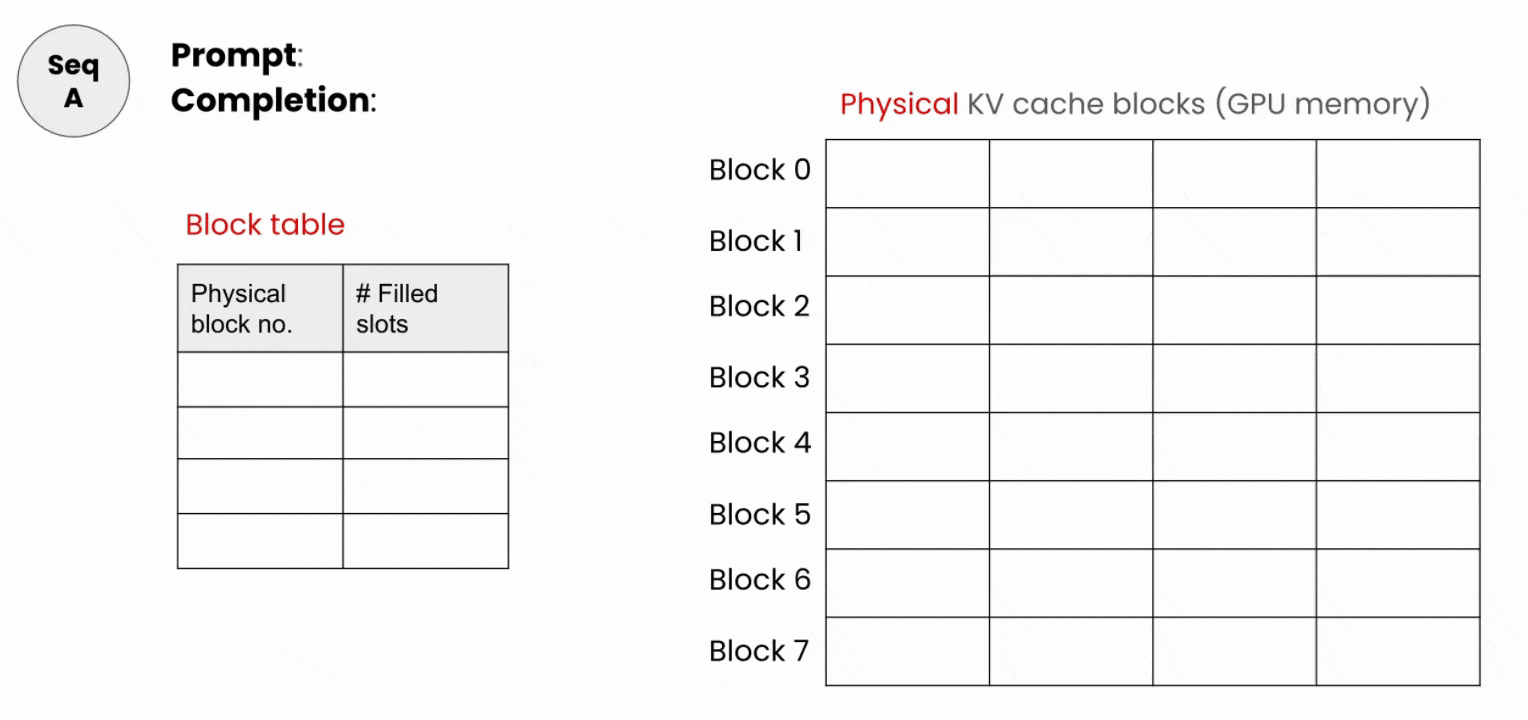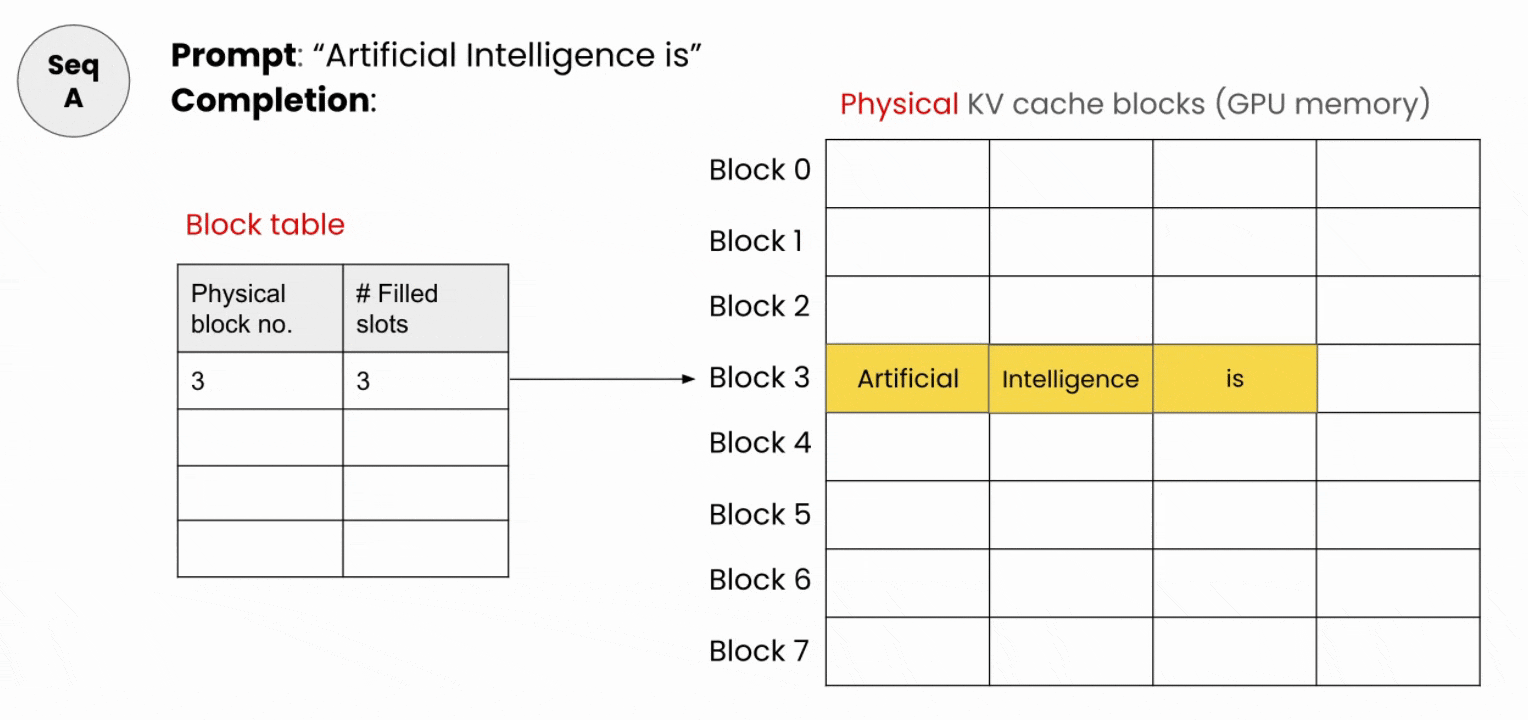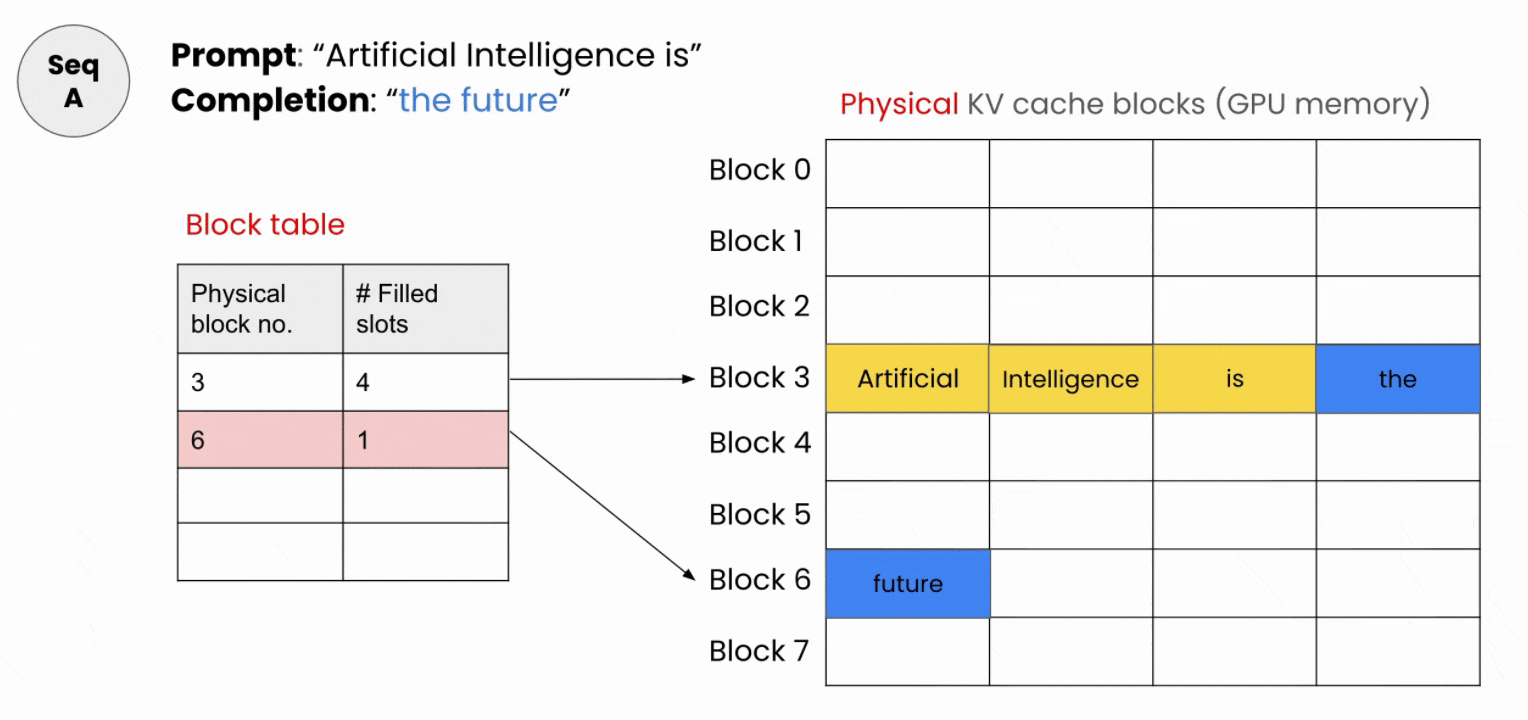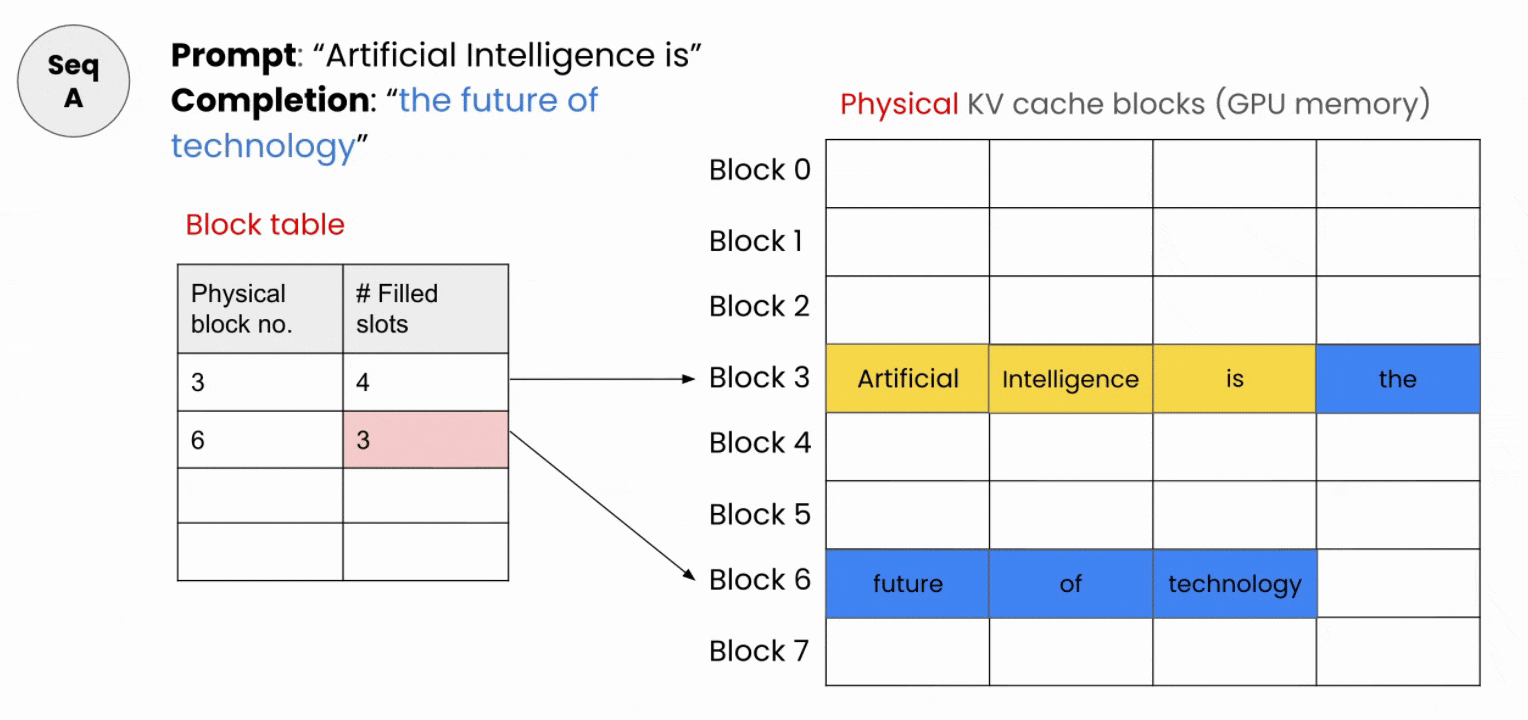
Figura 6: O PagedAttention distribui o cache em pequenos blocos de tamanho fixo e os rastreia com uma tabela de pesquisa, para nada ser reservado com antecedência.
2. Processamento contínuo em lotes
Com o processamento contínuo em lotes, em vez de esperar que um lote inteiro termine junto, as solicitações concluídas saem e novas entram conforme as vagas são liberadas. A GPU permanece ocupada continuamente.
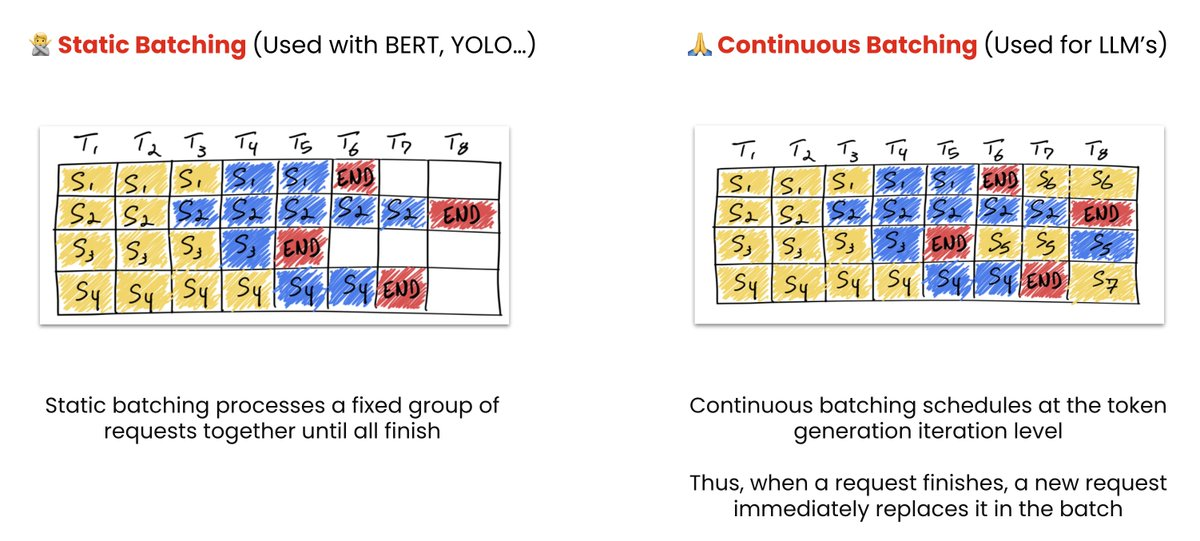
Figura 7: O processamento em lote estático faz com que cada solicitação aguarde a mais lenta, enquanto o processamento contínuo em lotes preenche cada vaga liberada imediatamente.
3. Cache de prefixo
Quando as solicitações compartilham um prefixo (um prompt do sistema, um documento recuperado ou o mesmo arquivo de repositório no contexto de um agente de codificação), o K e o V em cache são reutilizados em vez de recalculados.
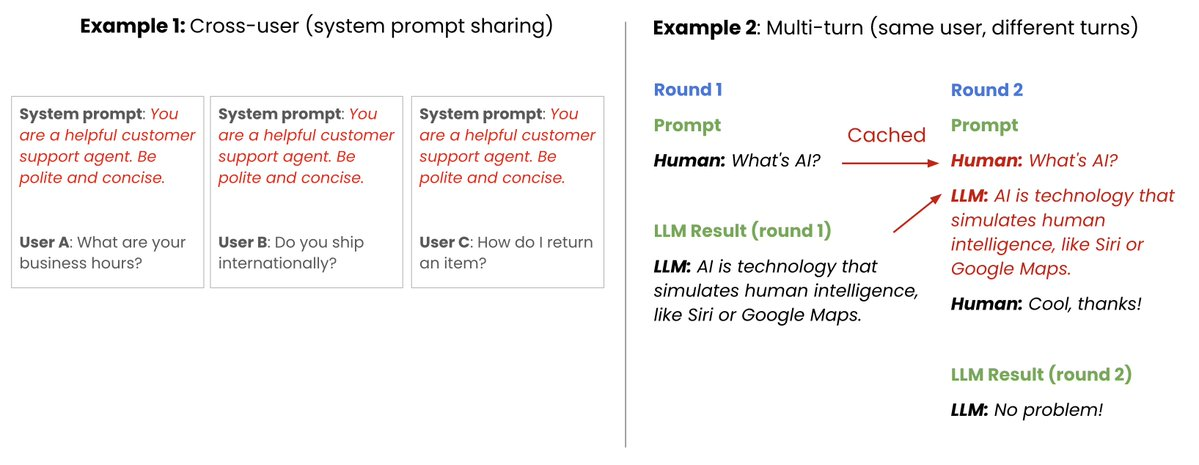
Figura 8: Quando as solicitações compartilham o mesmo texto de abertura, o trabalho já realizado para esse prefixo é reutilizado em vez de recalculado.
Nenhuma dessas técnicas altera o modelo, mas elas mudam a eficiência com que você o executa.
Além disso, é possível reduzir o próprio modelo
A quantização é um método para armazenar pesos (ou ativações) com menor precisão, para ocuparem menos espaço e sejam processados mais rapidamente. A maioria dos modelos é fornecida em BF16, ou 16 bits por parâmetro. Ao reduzir para FP8 (ponto flutuante de 8 bits) ou INT8 (inteiro de 8 bits), você reduz pela metade a quantidade de memória usada sem comprometer a precisão de referência. Ao passar para 4 bits, você atinge um quarto do consumo. Por exemplo, todos os modelos quantizados no repositório do Hugging Face da Red Hat AI recuperam >99% da precisão de referência.
O modelo gpt-oss-120b é um caso prático útil porque o trabalho já foi feito para você. Com 117B de parâmetros em BF16, os pesos seriam de aproximadamente 234 GB e você precisaria de três GPUs de 80 GB para carregá-los. A OpenAI pós-treinou o modelo com quantização MXFP4 nos pesos MoE (combinação de especialistas), reduzindo o tamanho para menos de 80 GB e permite executá-lo em uma única placa.
- BF16 (hipotético): ~234 GB → 3 GPUs
- MXFP4, conforme fornecido: Compatível com uma única GPU de 80 GB
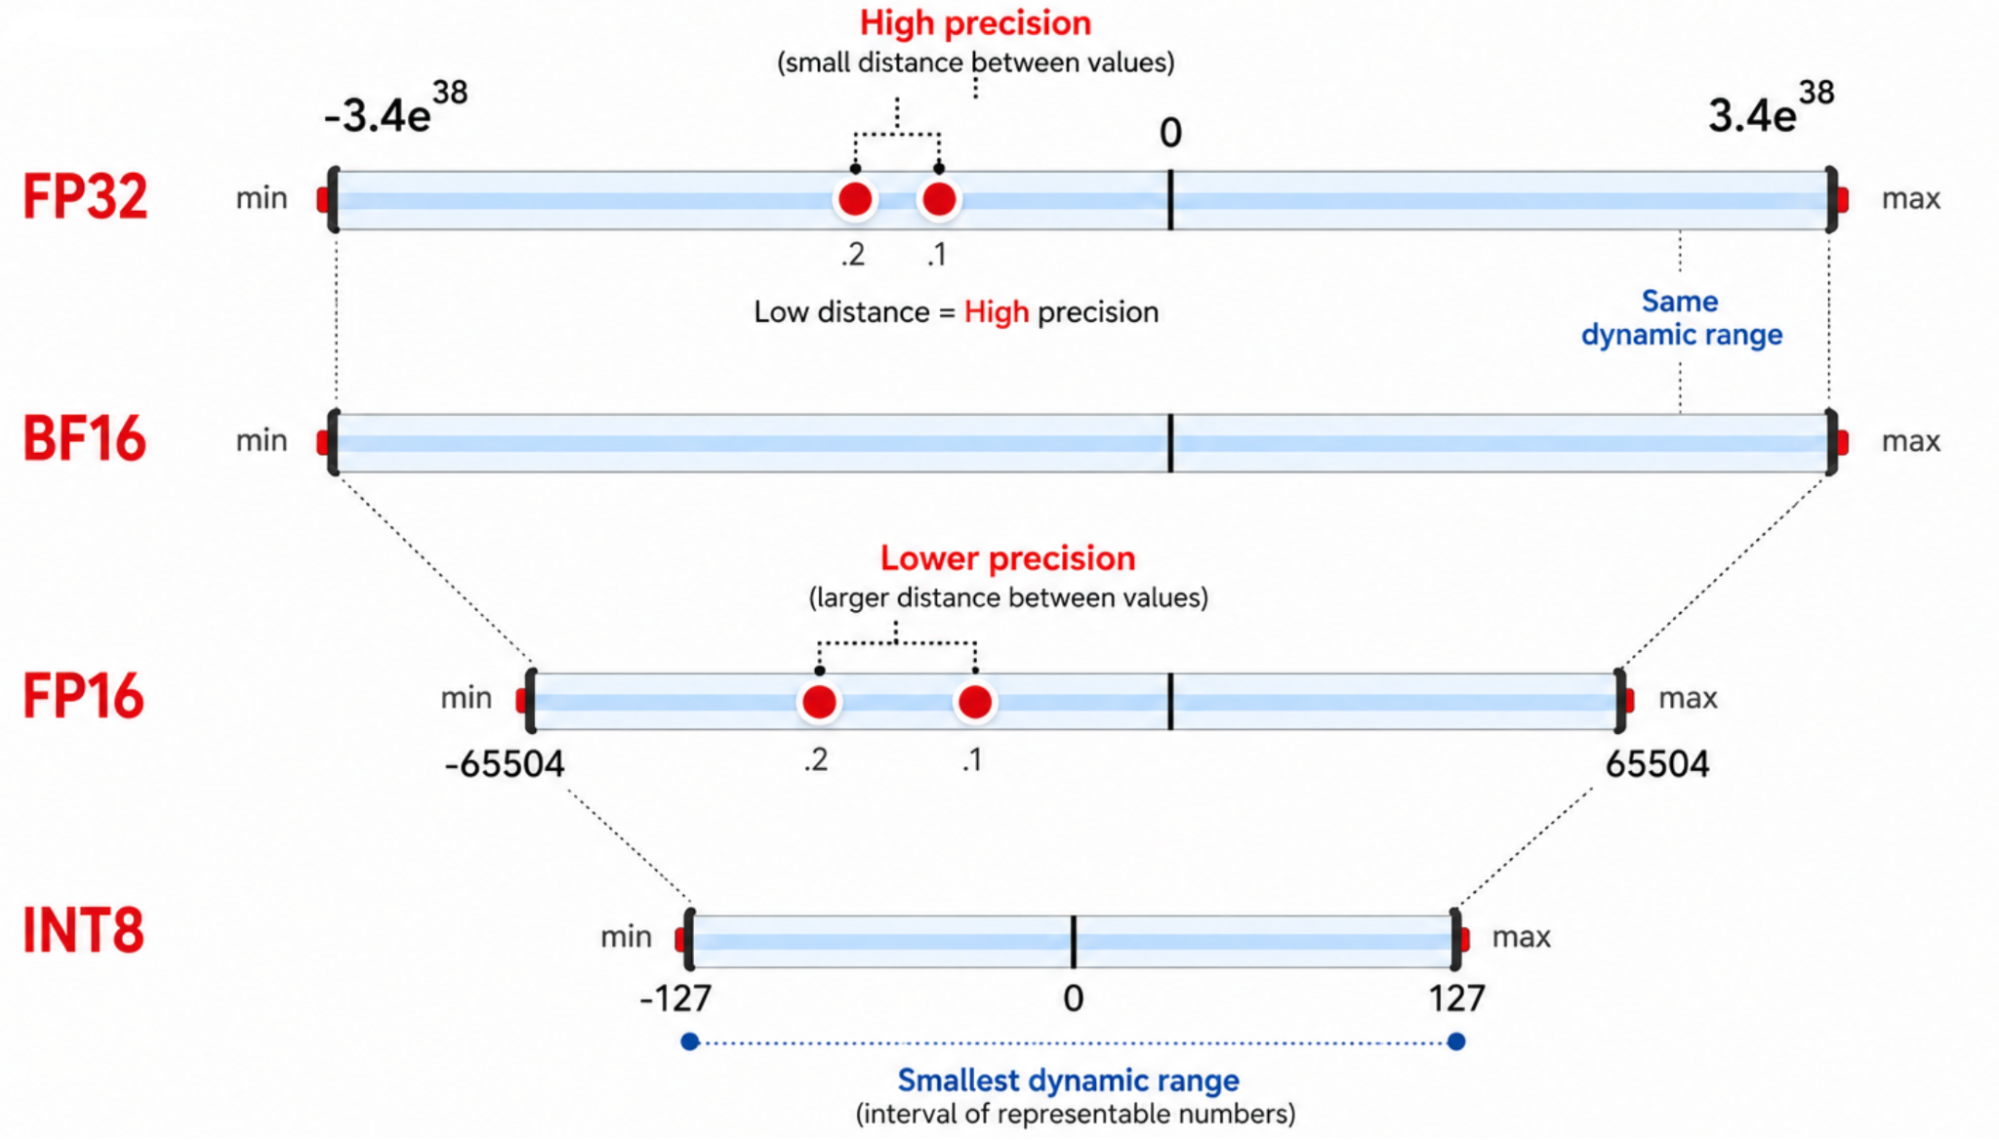
Figura 9: Formatos numéricos de menor precisão sacrificam alcance e detalhes em troca de uma pegada de memória muito menor.
A maioria dos modelos não vem pronta dessa forma, o que exige que você faça isso por conta própria ou acerte nossos modelos compactados no HuggingFace. No final das contas, a quantização traz dois grandes benefícios. Pesos quantizados significam menos dados sendo transferidos da memória de alta largura de banda (HBM) para a memória de acesso aleatório estática (SRAM) a cada passagem direta, o que resulta em ganho de latência. Ativações quantizadas significam que os núcleos de tensor realizam cálculos em menor precisão e executam mais operações por segundo, o que representa um ganho de taxa de transferência. Esquemas apenas de peso, como W8A16 (peso de 8 bits, ativação de 16 bits), oferecem a primeira vantagem, enquanto formatos como W8A8 (peso Int8, ativação Int8) oferecem ambas.
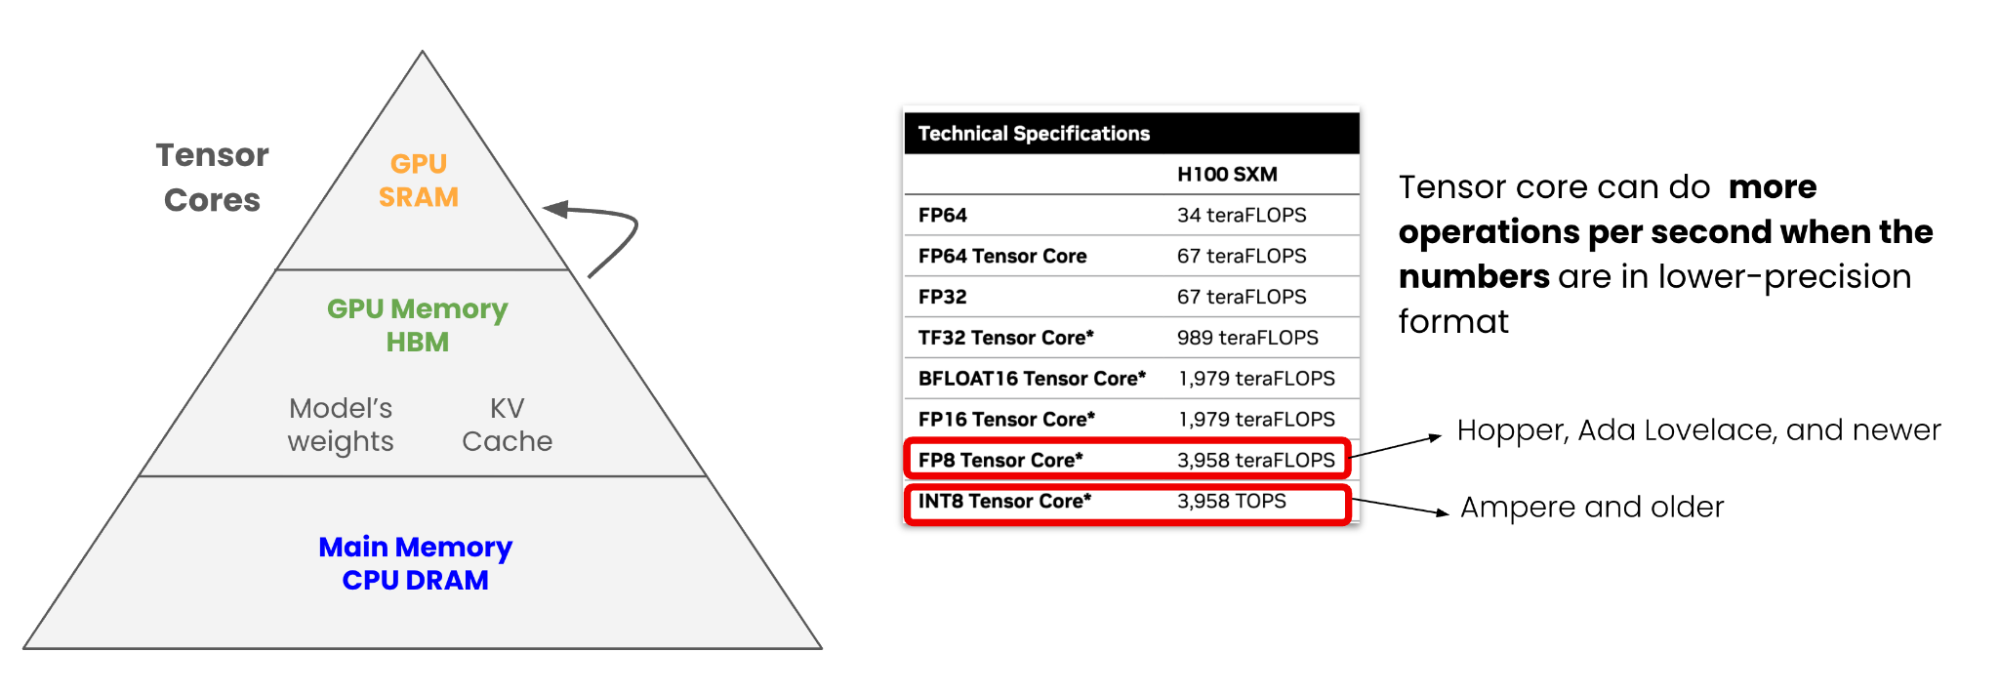
Figura 10: Pesos menores se movem mais rapidamente para a memória mais veloz da GPU, e operações matemáticas de baixa precisão rodam com uma taxa de transferência muito maior nos núcleos de tensor.
Na prática, o FP8 reduz pela metade o requisito de memória e proporciona até 1,6× mais taxa de transferência com impacto mínimo na precisão. E não, você não está tornando o modelo menos inteligente. Técnicas calibradas, como quantização pós-treinamento generalizada (GPTQ), quantização de peso com reconhecimento de ativação (AWQ) e SmoothQuant, usam um pequeno dataset representativo para identificar os pesos mais importantes e protegê-los, mantendo a perda de qualidade geralmente abaixo de um ponto percentual.
Guia de referência rápida para otimização de modelos de IA
Técnica | Onde se aplica | O que você ganha |
PagedAttention | Runtime | Mais solicitações simultâneas na mesma memória |
Processamento contínuo em lotes | Runtime | A GPU permanece ocupada entre as solicitações |
Cache de prefixo | Runtime | Ignora o recálculo no contexto compartilhado |
Quantização | Modelo, pré-implantação | Menos GPUs, carregamento mais rápido e processamento matemático mais ágil |
Esparsificação | Modelo, pré-implantação | Ignora os pesos menos importantes |
O treinamento é um custo único; a inferência é o custo recorrente e representa a maior parte da conta. Cada token é uma passagem direta completa. O cache KV é o elemento que cresce com o comprimento do contexto e com os usuários simultâneos, e gerenciá-lo é a principal tarefa do seu servidor de inferência. Em nosso exemplo, a diferença entre uma implantação simples e uma ajustada na mesma GPU é de aproximadamente três usuários simultâneos contra 50. Faça a inferência corretamente e aproveite muito mais o hardware que você já possui.
P.S.: se você gostou deste conteúdo!
Se quiser executar isso na prática, criamos um curso gratuito com a DeepLearning.AI e a Red Hat com abordagem hands-on: quantize um modelo Qwen com o LLM Compressor e meça a compensação de precisão, disponibilize-o com vLLM, compare o desempenho com GuideLLM e avalie com lm-eval: Fast & Efficient LLM Inference with vLLM.
Recurso
Por onde começar com a inferência de IA: os experts do Red Hat AI explicam
Sobre o autor
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
Mais como este
Inferência de IA distribuída
Por que agentes de IA precisam de um stack de inferência aberta
Navegue por canal

Automação
Últimas novidades em automação de TI para empresas de tecnologia, equipes e ambientes

Inteligência artificial
Descubra as atualizações nas plataformas que proporcionam aos clientes executar suas cargas de trabalho de IA em qualquer ambiente

Nuvem híbrida aberta
Veja como construímos um futuro mais flexível com a nuvem híbrida

Segurança
Veja as últimas novidades sobre como reduzimos riscos em ambientes e tecnologias

Edge computing
Saiba quais são as atualizações nas plataformas que simplificam as operações na borda

Infraestrutura
Saiba o que há de mais recente na plataforma Linux empresarial líder mundial

Aplicações
Conheça nossas soluções desenvolvidas para ajudar você a superar os desafios mais complexos de aplicações

Virtualização
O futuro da virtualização empresarial para suas cargas de trabalho on-premise ou na nuvem
