-
Prodotti e documentazione Red Hat AI
Una piattaforma di prodotti e servizi per lo sviluppo e il deployment dell'IA nel cloud ibrido.
Red Hat AI Enterprise
Crea, sviluppa e distribuisci applicazioni basate sull'IA nel cloud ibrido.
Red Hat AI Inference
Ottimizza le prestazioni dei modelli con uno stack integrato per un'inferenza rapida, coerente e conveniente su larga scala.
Red Hat Enterprise Linux AI
Sviluppa, testa ed esegui modelli di IA generativa per le applicazioni aziendali.
Red Hat OpenShift AI
Crea e distribuisci applicazioni e modelli basati sull'IA in modo scalabile negli ambienti ibridi.
-
Formazione Concetti di base
Perché scegliere Red Hat AI?
-
Partner per l'IA
L’importanza dell'inferenza IA
Senza l’inferenza, l’IA non esisterebbe. È il cuore dell'IA generativa.
La buona notizia è che ne conosciamo il potenziale. La sfida è capire come renderla scalabile.
Vediamo nel dettaglio come rendere scalabile l'inferenza dell'IA con strumenti open source come vLLM e llm-d.
Perché l'inferenza è essenziale?
L'inferenza è l'ultimo passaggio, quello in cui il modello produce l'output desiderato. È una funzione indispensabile per il funzionamento dell'IA.
Ecco perché l'hardware e il software che supportano l'inferenza possono determinare il successo o il fallimento della strategia di IA.
L'architettura che offre più possibilità di scalabilità si basa su tecnologie open source.
Quali sono le difficoltà legate alla scalabilità?
Sappiamo che l'IA funziona: la sfida è estenderla in modo scalabile a tutta l'organizzazione.
Quando aumentano le esigenze, i modelli richiedono più dati e più memoria ed è allora che hardware e acceleratori iniziano a faticare.
Affidarsi a un provider di terze parti può sembrare la soluzione più semplice, ma i costi dei token aumentano rapidamente e, a volte, possono superare quelli dell'applicazione di IA stessa.
40%
Entro il 2030, l'inferenza sarà il carico di lavoro predominante nei data center per l'IA e si prevede che possa rappresentare fino al 40% del fabbisogno complessivo dei data center.1
Come si può migliorare l'inferenza?
Ottimizzando l'inferenza su un'architettura open source, i modelli di IA riescono a lavorare in modo più veloce e intelligente.
Le strategie di ottimizzazione includono:
- Compressione dei modelli tramite quantizzazione.
- Uso più efficiente delle GPU.
- Decodifica speculativa.
- Inferenza distribuita.
- Delega alle CPU delle attività di gestione della memoria e orchestrazione.
Ottimizzazioni come queste aiutano a contenere i costi legati all’inferenza IA, in modo da adattarla con scalabilità in base all’evoluzione dei tuoi team e delle loro esigenze.
19%
Riduzione dei costi in modo scalabile grazie alle tecniche di decodifica speculativa.2

2 x
Più throughput per l'elaborazione utilizzando modelli compressi senza compromettere l'accuratezza.3
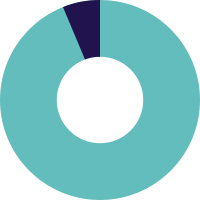
90%
Percentuale della latenza end to end dovuta alle CPU.4
In che modo vLLM ottimizza l'inferenza?
L'ottimizzazione dei modelli è solo metà dell'opera. Occorre anche un motore di inferenza ad alte prestazioni, ed è questo è il contesto in cui subentra vLLM.
I sistemi di gestione della memoria LLM tradizionali non gestiscono la memoria nel modo più efficiente, il che ne rallenta l'attività. vLLM utilizza PagedAttention, una tecnica di gestione della memoria che identifica i valori chiave ripetitivi per ridurre il sovraccarico per gli LLM.
Ciò consente a vLLM di utilizzare al meglio la memoria GPU e velocizzare l'inferenza IA generativa. Questa strategia massimizza il throughput (token elaborati al secondo) per distribuire le soluzioni a più utenti contemporaneamente.
L'utilizzo degli acceleratori in modo più efficiente consente ai modelli di svolgere più calcoli matematici in un minore intervallo di tempo, permettendo ai team di soddisfare più utenti e agenti più velocemente.
75%
Riduzione dei requisiti di memoria, con conseguente diminuzione delle GPU necessarie.5
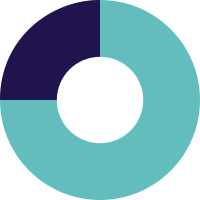
4x
Token elaborati al secondo rispetto alla maggior parte dei provider di inferenza.6
24 x
Aumento del throughput con vLLM rispetto alla concorrenza.7
Perché vLLM è così diffuso?
vLLM ha contribuito a gestire le sfide principali riguardanti un utilizzo efficiente delle GPU, consentendo di ottenere in modo scalabile un costo per token ridotto e una latenza stabile, il tutto attraverso un approccio di implementazione aperto e in grado di garantire portabilità.
Con un supporto dalla fase 0 per tutti i modelli e gli acceleratori principali, offre un'accessibilità interessante sia per l'industria che per il mondo accademico. Ecco perché la community vLLM è attiva e vivace.
I contributi provengono da Hugging Face, UC Berkeley, NVIDIA, Red Hat e molti altri. La community mette alla prova e migliora costantemente il software nel progetto open source.
Più di 10.000
Commit su GitHub per vLLM* nel 2026, con un aumento di oltre il 200%.
La community di vLLM oggi
Più di 500.000
GPU distribuitie 24 ore su 24, 7 giorni su 78
Più di 200
Acceleratori di vario tipo9
Più di 500
Architetture dei modelli supportate9
Più di 3100
Dove si inserisce l'inferenza distribuita?
Con l'inferenza distribuita i modelli di IA suddividono le attività di inferenza su un gruppo di dispositivi interconnessi.
Quando un modello è in grado di soddisfare diverse richieste tutte allo stesso tempo, riduce significativamente l'hardware necessario e aumenta l'efficienza dell'inferenza.
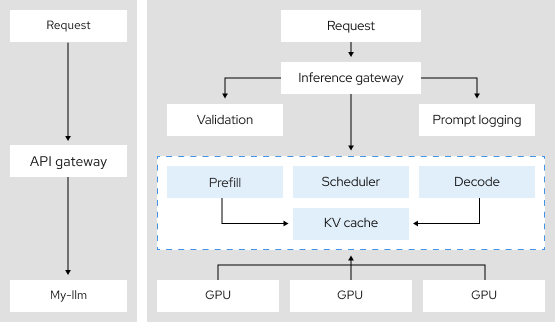
L'inferenza distribuita utilizza tecniche come il parallelismo tensoriale, la programmazione intelligente dell'inferenza e la disaggregazione. Quando integrata con vLLM, l'inferenza diventa uno strumento polivalente molto efficiente.
Ciò permette di mantenere l'inferenza monitorabile, scalabile e coerente.
99%
Riduzione del tempo per il primo token (TTFT) a parità di carico.10

Esiste una community open source dedicata all’inferenza distribuita?
Sì, si chiama llm-d.
llm-d è un framework open source che offre agli sviluppatori un modello per realizzare un'inferenza distribuita in modo scalabile.
La sua architettura modulare supporta le complesse necessità di risorse degli LLM avanzati e sostituisce i processi manuali e frammentati con percorsi integrati e ben definiti, accelerando i tempi dal progetto pilota alla produzione.
llm-d introduce l'inferenza in Kubernetes, fornendo un kit di strumenti standardizzato che aiuta ad applicare l'inferenza distribuita agli scenari di utilizzo aziendali specifici.
2 x
Utenti supportati sullo stesso hardware con cluster ottimizzati per llm-d.11
Ulteriori risorse di IA
Red Hat AI Inference
Trasferisci più rapidamente i tuoi LLM dalla fase di codice al passaggio in produzione.
Realizzato a partire da vLLM, il nostro motore di inferenza pensato per le aziende consente un'inferenza più rapida senza ripercuotersi sulle prestazioni.
Ottieni la scalabilità nel cloud ibrido con il tuo modello di IA gen preferito e ottimizzato su qualsiasi acceleratore di IA e in qualsiasi ambiente cloud.

Fonti citate
[1] "The future of AI workloads", McKinsey & Company, 24 febbraio 2026.
[2] Umesh, Harshith. "Performance improvements with speculative decoding in vLLM for gpt-oss", Red Hat Developer Blog, 16 aprile 2026.
[3] Kurtić, Eldar, et al. "2:4 Sparse Llama: Smaller models for efficient GPU inference." Blog di Red Hat Developer, 28 feb 2025.
[4] Bowerman, Sawyer. Ableidinger, Grace. “La CPU è tornata: ripensare la ripartizione tra CPU e GPU per l'inferenza degli LLM", blog di Red Hat, 6 agosto 2026.
[5] "What is LLM Compressor?", documenti vLLM.
[6] "vLLM Tops the Artificial Analysis Leaderboard", blog di vLLM, 11 maggio 2026.
[7] Kwon, Woosuk, et al. "vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention." Blog vLLM, 20 giu. 2023.
[8] Goin, Michael. "[vLLM Office Hours #38] vLLM 2025 Retrospective & 2026 Roadmap - December 18, 2025." YouTube, 8 dic. 2025.
[9] Kwon, Woosuk. "Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale." X, 26 gen. 2026.
[10] Singh, Naina. "Le stesse 16 GPU, il doppio degli utenti: routing consapevole con l'inferenza per i cluster LLM", blog di Red Hat, 27 maggio 2026.
[11] Singh, Naina. "Le stesse 16 GPU, il doppio degli utenti: routing consapevole con l'inferenza per i cluster LLM", blog di Red Hat, 27 maggio 2026.
