Se utilizzi o sviluppi modelli linguistici di grandi dimensioni (LLM), forse il concetto più importante da comprendere è il funzionamento dell'inferenza e della cache key-value (KV). Infatti, che tu stia lavorando con agenti di programmazione, Retrieval-Augmented Generation (RAG) o fine tuning, l'inferenza si verifica ogni volta che invii una richiesta a un modello e ricevi una risposta. È quindi il processo che genera gran parte dei costi.
Mentre la formazione avviene una sola volta, l'inferenza si ripete ogni singola volta che un utente invia un prompt. Vediamo quindi come funziona, cos'è la cache KV e quali sono le ottimizzazioni che la maggior parte dei team impiega per risparmiare sui costi dell'infrastruttura e ridurre la latenza.
L'inferenza è uno stack di tecnologie, non un file di modello
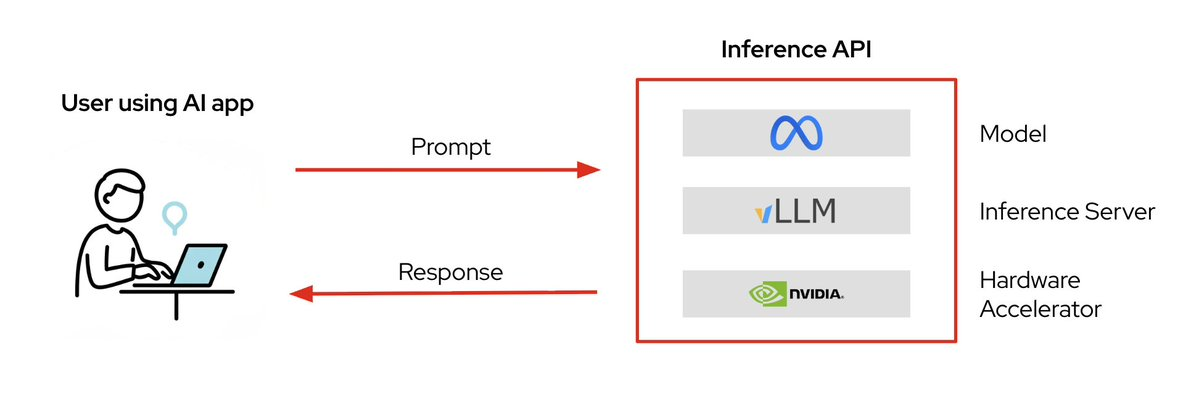
Figura 1: La distribuzione di un modello richiede l'interazione di tre componenti: i pesi, un server di inferenza e l'hardware alla base.
Un modello presente sulla tua macchina (o su HuggingFace) non è ancora utile a nessuno. Affinché l'inferenza sia possibile, è necessaria l’interazione di tre elementi.
- Pesi del modello: i file con i miliardi di parametri appresi, come Kimi, GLM, Qwen o qualsiasi altra opzione tu abbia scelto.
- Server di inferenza: software come vLLM che carica il modello, gestisce le richieste in entrata e applica le ottimizzazioni che stiamo per esaminare.
- Acceleratore hardware: di solito una GPU, che gestisce il carico computazionale più elevato.
Puoi saltare il livello intermedio ed eseguire un modello direttamente su una GPU con PyTorch. Funziona bene per un notebook o per un singolo utente. Nel momento in cui devi gestire molti utenti contemporaneamente, tuttavia, è il server di inferenza a rendere la GPU utilizzabile a livello di produzione (ad esempio, quando apri un file HTML in locale anziché distribuirlo tramite un server HTTP Apache).
I modelli generano un token alla volta
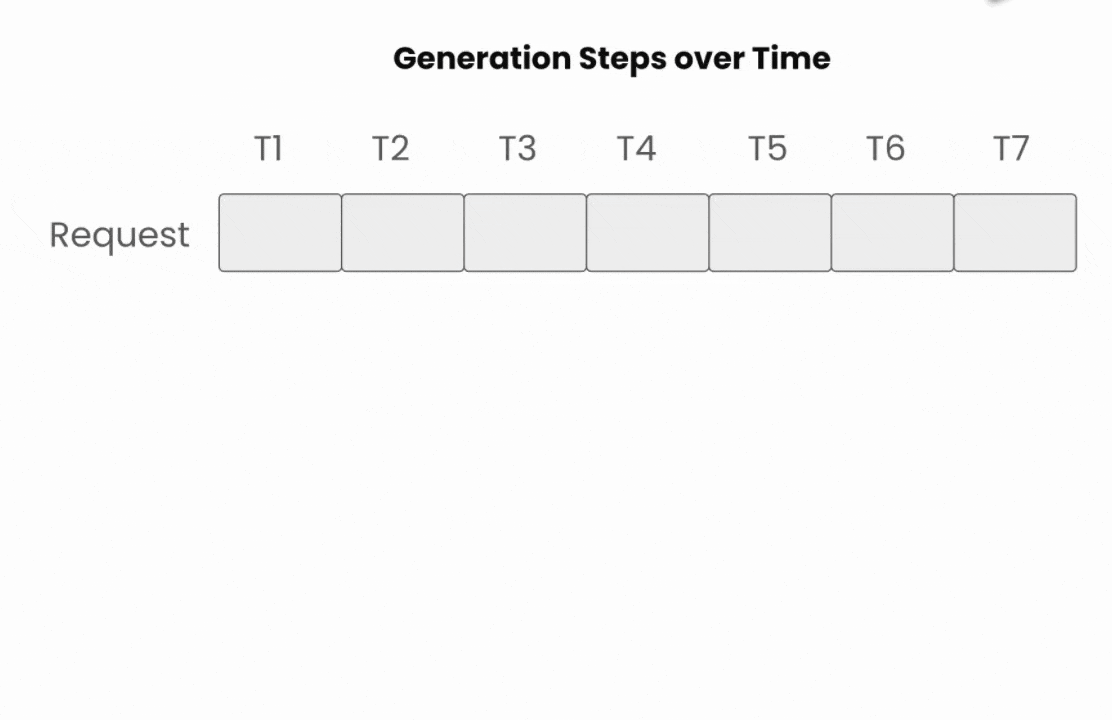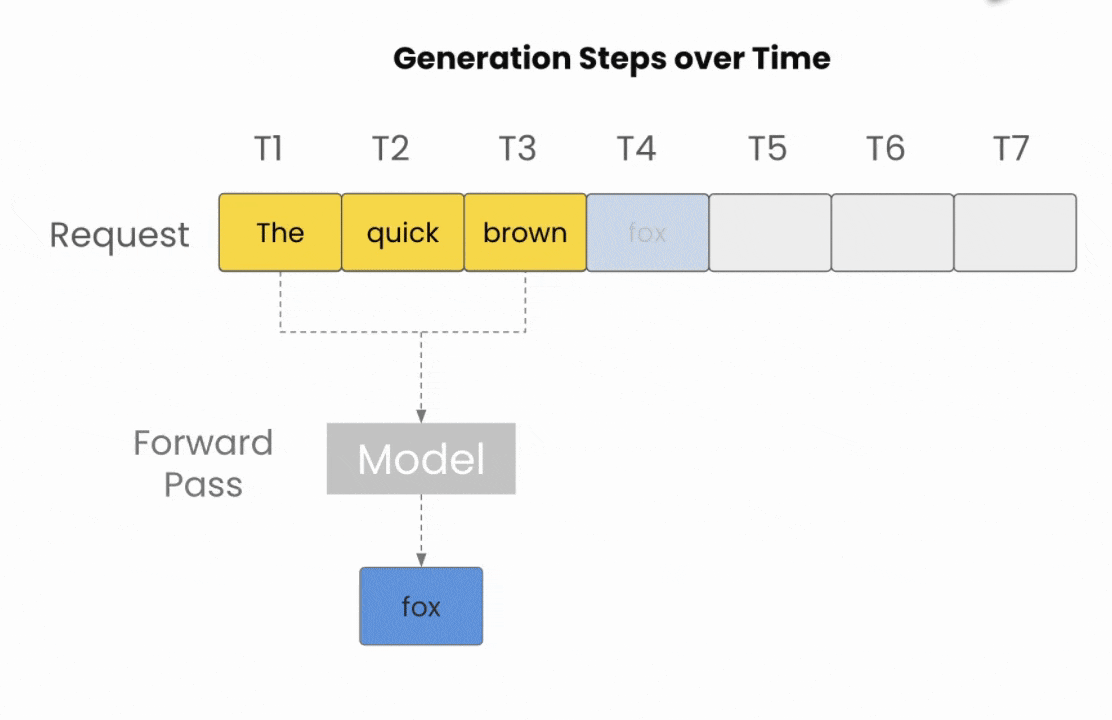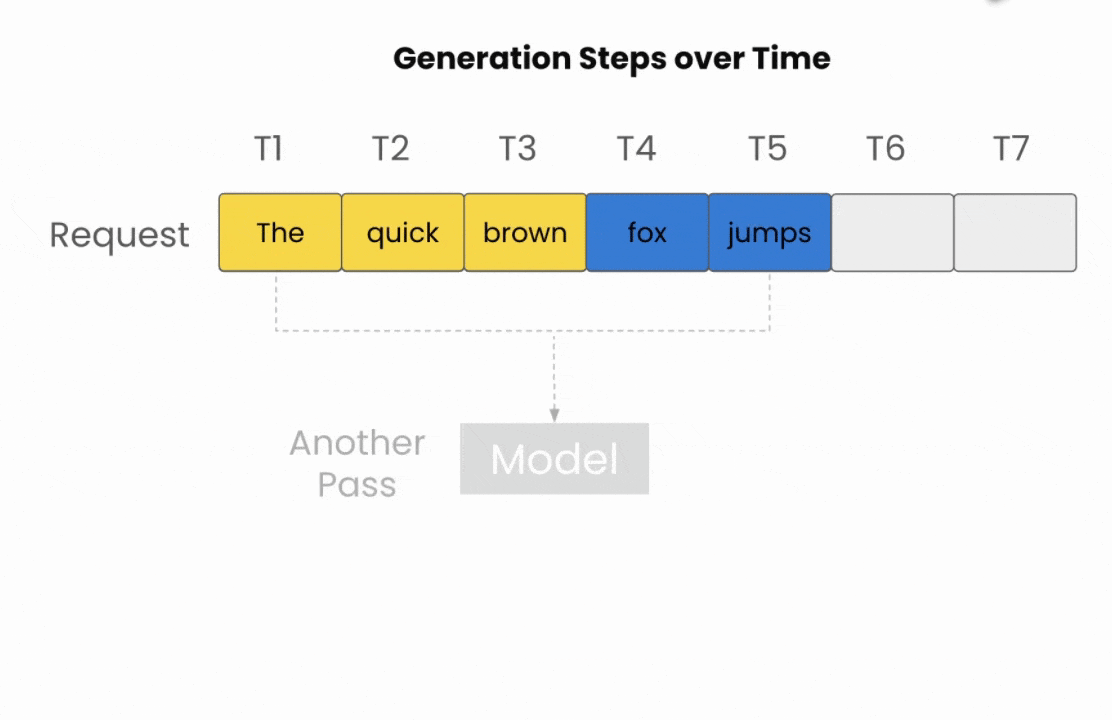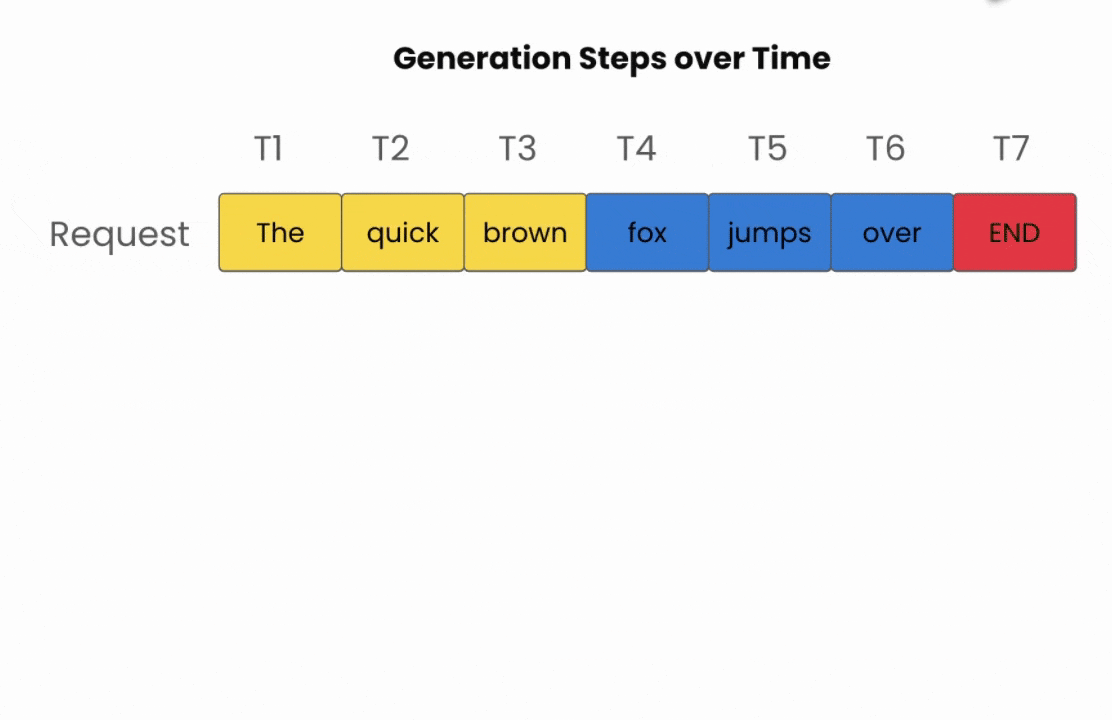
Figura 2: Ogni propagazione in avanti produce esattamente un nuovo token, che viene poi reinserito per generare il successivo.
Gli LLM non generano risposte lunghe tutte in una volta, ma producono un token alla volta, e ogni nuovo token dipende da tutti i token precedenti (inclusi quelli appena generati dal modello stesso).
Quindi, se iniziamo con un prompt di esempio: "The quick brown"
- Il modello predice "fox" → aggiungendolo;
- "The quick brown fox" → predice "jumps" → aggiungendolo;
- e così via, finché il modello non genera uno speciale token di fine sequenza.
Si tratta di generazione autoregressiva, e ciò che spesso si sottovaluta è che ogni token in una risposta richiede un passaggio completo attraverso il modello. Una risposta di 500 token significa che il modello viene eseguito 500 volte. Questo ci dà un’idea di come la richiesta di elaborazione possa iniziare a crescere.
Perché esiste la cache KV
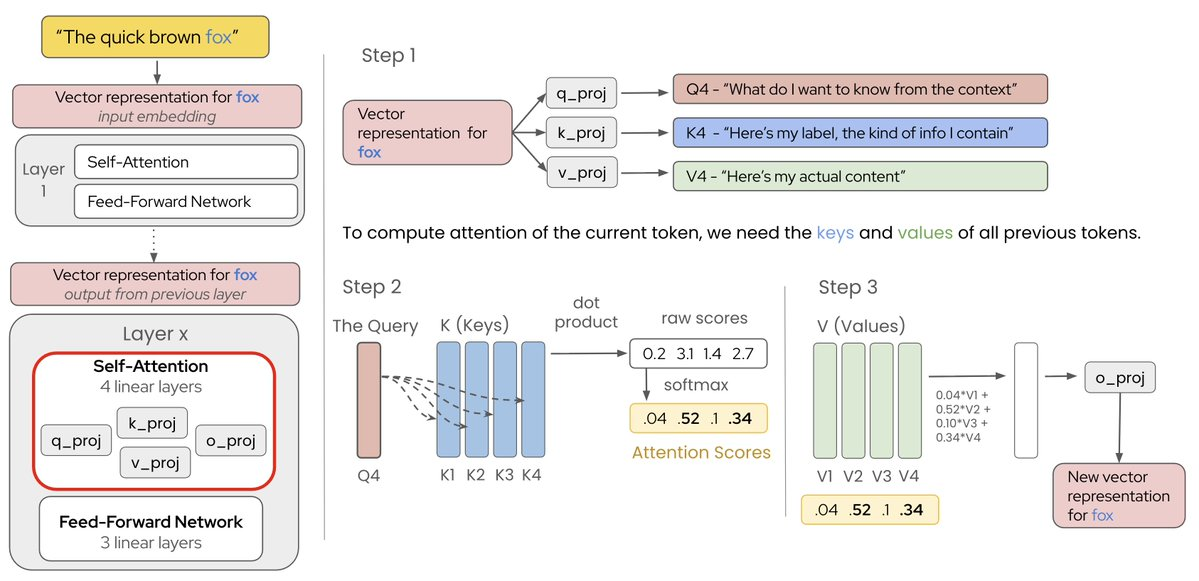
Figura 3: Ogni token passa attraverso il blocco di attenzione di ciascun livello, confrontando la propria query con le chiavi e i valori di tutti gli elementi precedenti.
All'interno di ciascuno di questi passaggi, i token diventano embedding (una rappresentazione numerica) per poi fluire attraverso una serie di livelli di trasformatori. Ogni livello include un blocco di auto-attenzione in cui i token interagiscono tra loro. È qui che ha inizio il problema della memoria.
L'attenzione calcola tre vettori per token:
- Q, la query: ciò che questo token vuole sapere dal contesto
- K, la chiave: il tipo di informazioni che contiene
- V, il valore: il suo contenuto effettivo
Per generare il token successivo, confrontiamo la sua query con la chiave di ogni token elaborato finora e calcoliamo una somma ponderata dei valori.
Ma dobbiamo fare un’osservazione. Ecco cosa è davvero importante: la query è necessaria solo per il token corrente. Le chiavi e i valori sono necessari per l'intera cronologia, ma non cambiano. La chiave e il valore del token 4 al passaggio 5 sono identici a quelli del passaggio 4.
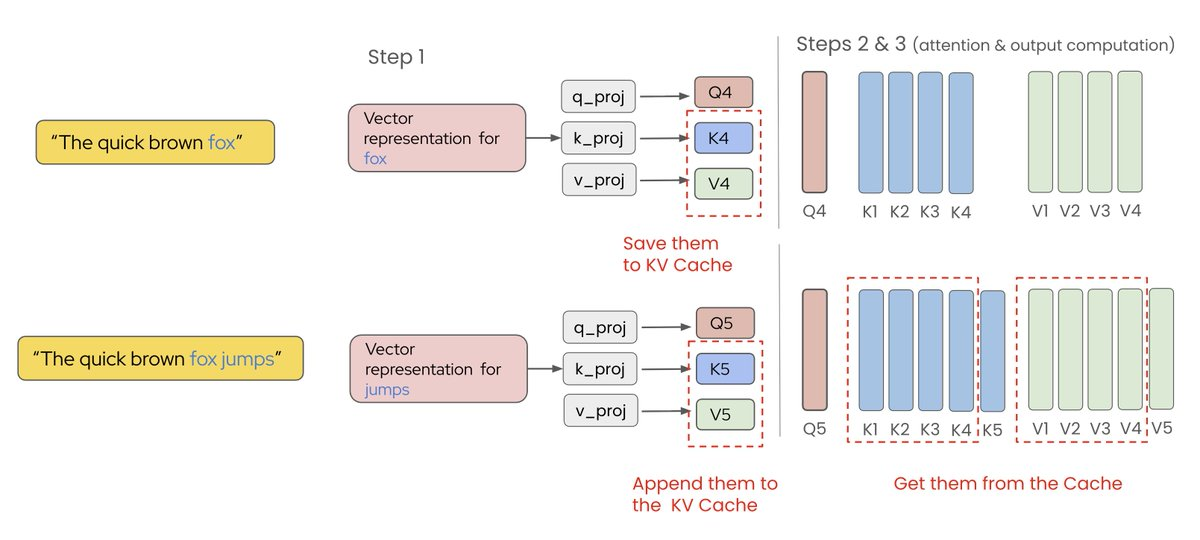
Figura 4: Poiché le chiavi e i valori dei token precedenti non cambiano mai, vengono salvati una sola volta e riutilizzati anziché ricalcolati a ogni passaggio.
Quindi, invece di ricalcolarli a ogni passaggio, li salviamo nella memoria della GPU e calcoliamo solo K e V per il nuovo token. Questa è la cache KV e interviene in ciascuno degli N livelli del modello, moltiplicando i risparmi per N.
Quanto può crescere la cache KV?
Ogni token richiede la memorizzazione delle proprie chiavi e dei propri valori a ogni livello, con diversi set paralleli per livello (le teste KV). La formula è:
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
Prendiamo ad esempio gpt-oss-120b: 36 livelli, 8 teste KV, una dimensione della testa pari a 64 e 2 byte per valore. Si tratta di circa 72 KB per token, ma gpt-oss conserva la cronologia completa solo su metà dei suoi livelli, quindi l'incremento effettivo è più vicino a 36 KB per token.
- 2k (una tipica interazione di chat): ~75 MB
- 8k (livello di produzione standard): ~300 MB
- 32k (documento lungo o codebase): ~1,2 GB
- 128k (valore massimo per gpt-oss): ~4,8 GB
Questo è un modello progettato per l’efficienza del deployment. Un modello denso da 70B con 80 livelli e una dimensione delle teste pari a 128 (come Llama 3.3 70B) richiede circa 320 KB per token, ovvero nove volte di più per la stessa conversazione. Ecco perché le scelte sull'architettura del modello sono fondamentali per controllare i costi dell'IA.
Ecco dove va a finire il budget per la GPU
Un modello come gpt-oss-120b può essere eseguito su una singola GPU NVIDIA H100 da 80 GB. Si è trattato di un traguardo significativo al momento del rilascio del modello, ma dopo aver caricato i pesi sulla scheda rimangono solo circa 15-20 GB di margine per la cache KV e l'overhead di inferenza. Gestire utenti reali ora diventa complesso, ad esempio:
- se il server riserva memoria per ciascuna richiesta in base al contesto massimo raggiungibile (come avveniva con gli approcci precedenti), ogni richiesta richiede 4,8 GB, indipendentemente dall'uso effettivo. Ciò consente di gestire solo tre utenti simultanei su una H100. Un bel problema.
- Allocando, invece, ciò che ciascuna richiesta utilizza realmente, una tipica richiesta da 8k utilizza 300 MB. Stessa scheda, stesso modello, 50 o 60 utenti. Tutto questo sullo stesso hardware: la differenza risiede interamente nella modalità di gestione della memoria della GPU, ed è per questo che l'argomento è così importante.
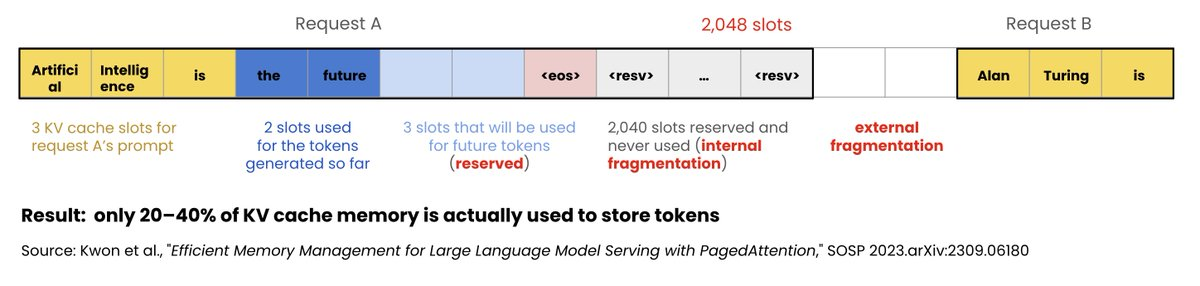
Figura 5: riservare memoria per la lunghezza di contesto, nel caso peggiore, lascia vuota la maggior parte della cache KV.
Cosa fanno a questo proposito i server di inferenza per la produzione come vLLM?
Adottano principalmente tre strategie.
1. PagedAttention
PagedAttention suddivide la cache KV in piccoli blocchi di dimensioni fisse che possono risiedere ovunque in memoria, utilizzando una tabella per tenere traccia della posizione dei blocchi di ciascuna richiesta. Non viene riservato alcuno spazio per contesti che potresti non utilizzare mai. Se hai già familiarità con la memoria virtuale in un sistema operativo, questo approccio ti risulterà noto, poiché è proprio da lì che nasce l'idea.
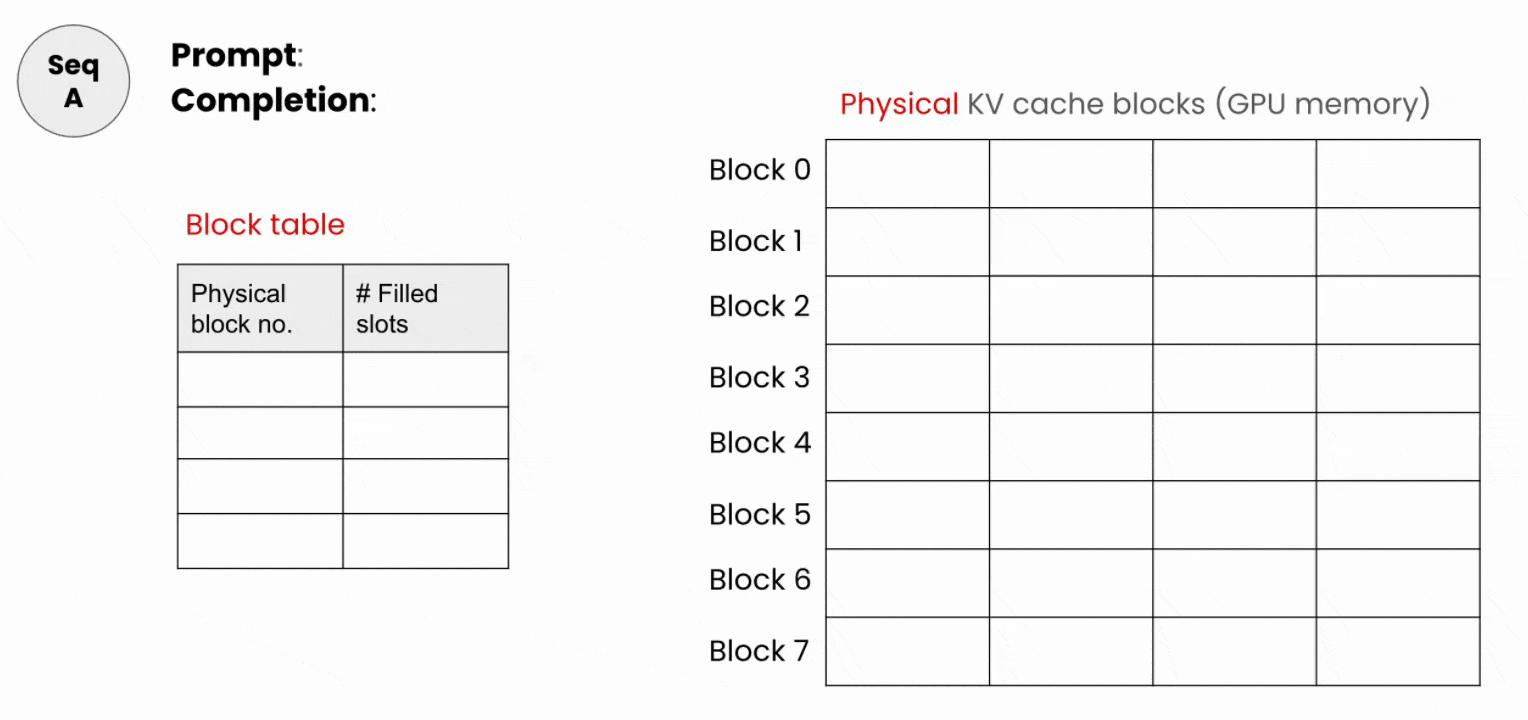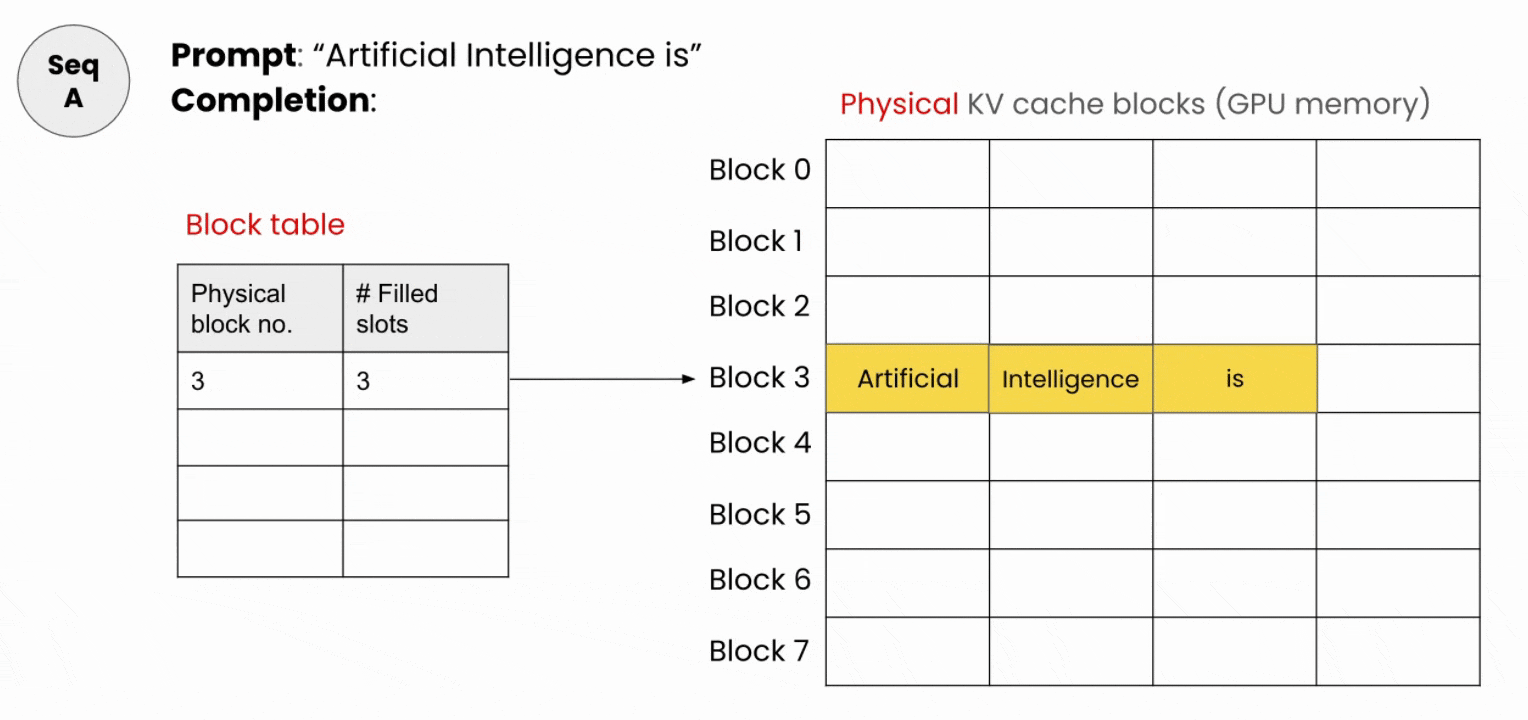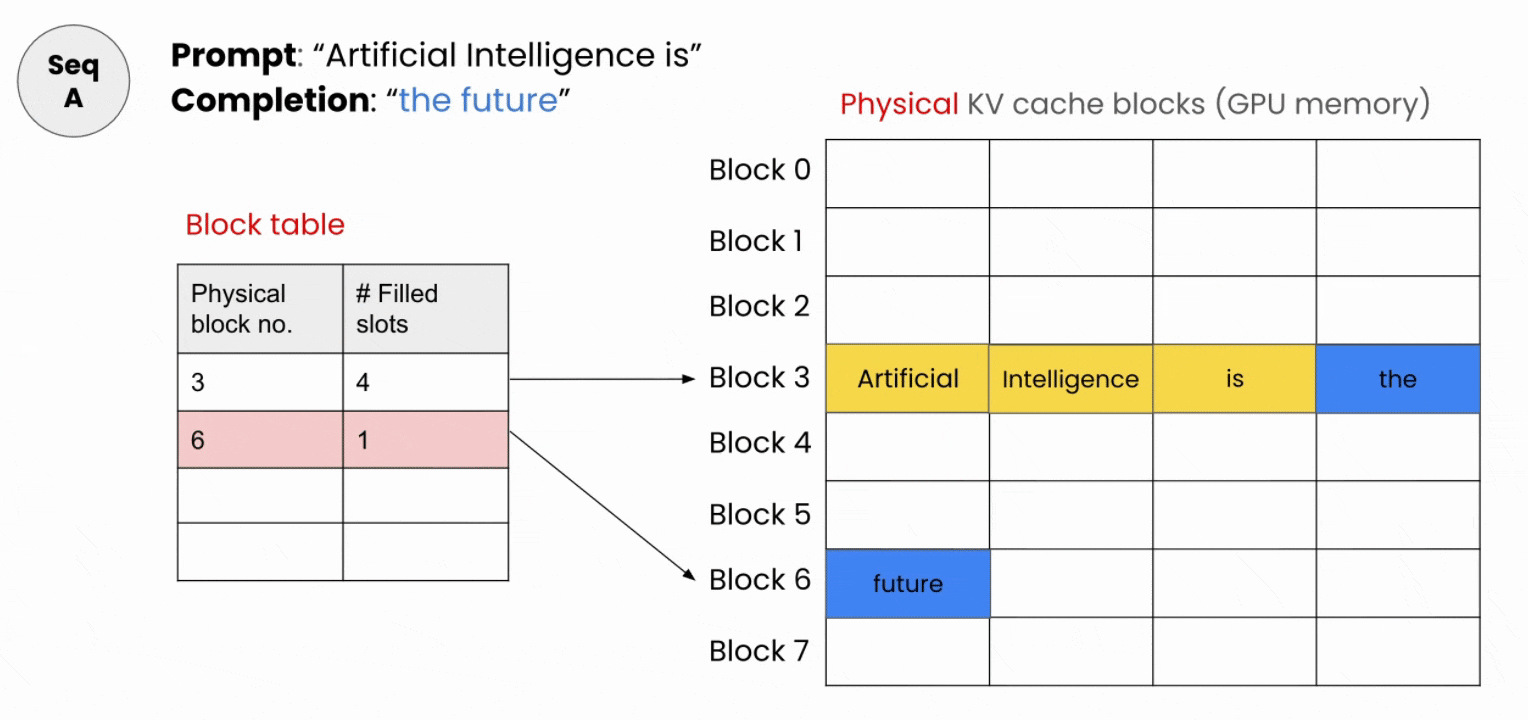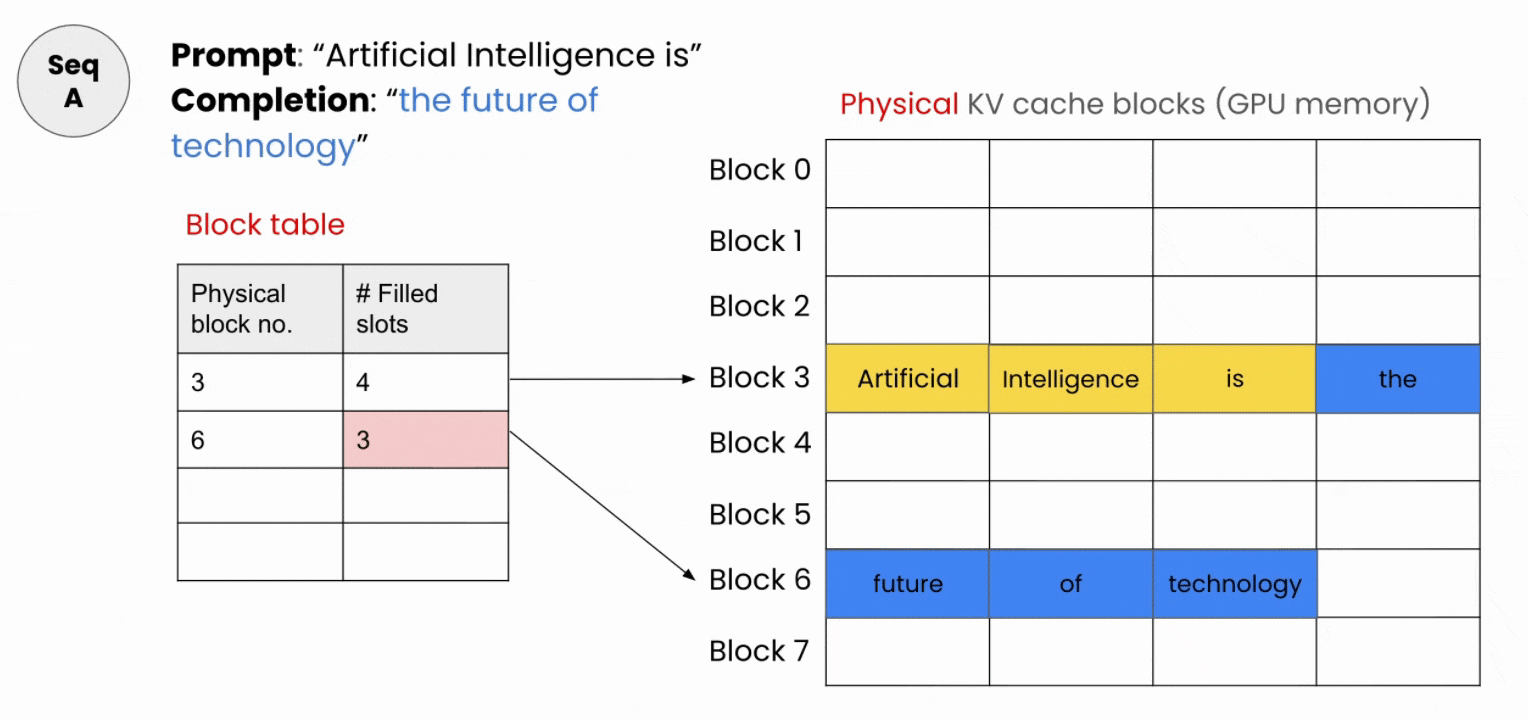
Figura 6: PagedAttention distribuisce la cache su piccoli blocchi di dimensioni fisse e ne tiene traccia con una tabella di ricerca, evitando allocazioni fatte in anticipo.
2. Batching continuo
Con il batching continuo, invece di attendere il completamento di un intero batch, le richieste terminate vengono rilasciate e quelle nuove subentrano man mano che si liberano slot. La GPU resta costantemente alimentata.
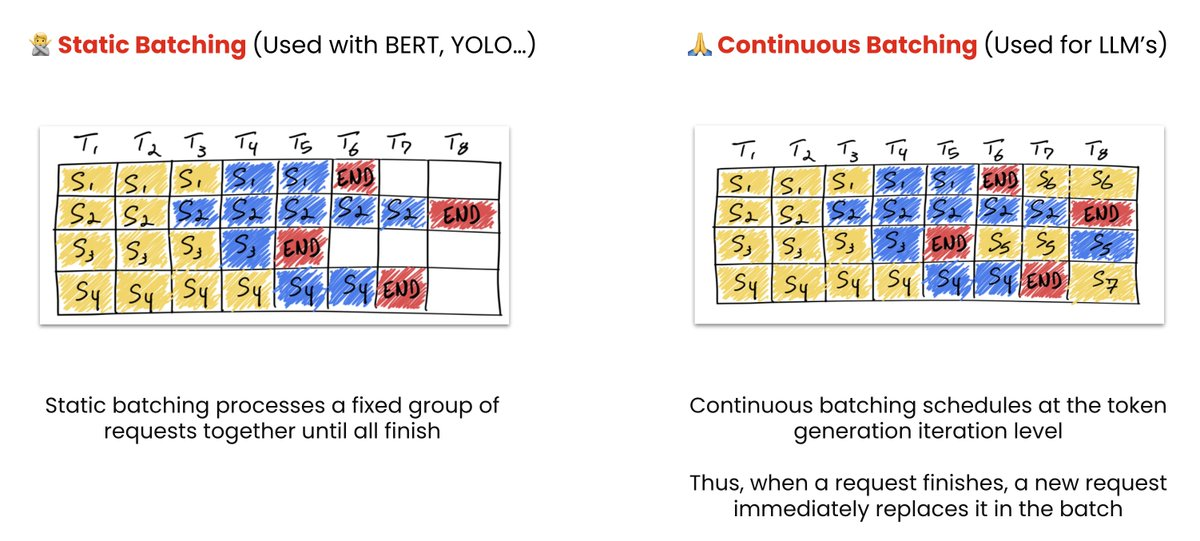
Figura 7: Il batching statico costringe ogni richiesta ad attendere la più lenta, mentre il batching continuo riempie immediatamente ogni slot liberato.
3. Caching dei prefissi
Quando le richieste condividono un prefisso (un prompt di sistema, un documento recuperato o lo stesso file di repository nel contesto di un agente di programmazione), questa tecnica riutilizza i valori K e V memorizzati nella cache anziché ricalcolarli.
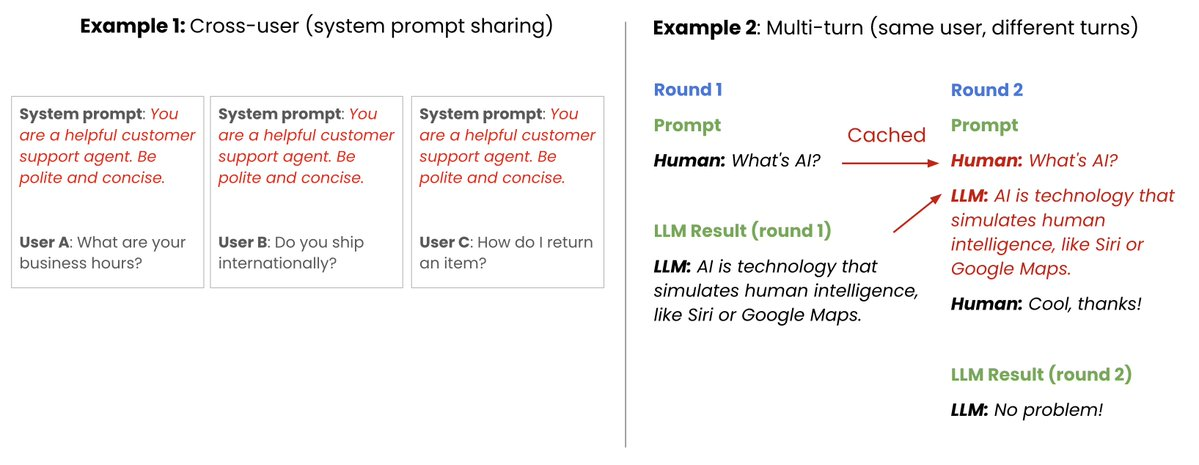
Figura 8: Quando le richieste condividono lo stesso testo iniziale, il lavoro già completato per quel prefisso viene riutilizzato invece di essere ricalcolato.
Nessuna di queste tecniche modifica il modello, ma ne ottimizza l'efficienza di esecuzione.
La riduzione delle dimensioni del modello
La quantizzazione è un metodo per archiviare i pesi (o le attivazioni) con una precisione inferiore, in modo da occupare meno spazio e velocizzare i calcoli. La maggior parte dei modelli viene distribuita in formato BF16, ovvero a 16 bit per parametro. Passando a FP8 (virgola mobile a 8 bit) o INT8 (intero a 8 bit), dimezzi la quantità di memoria utilizzata senza compromettere l'accuratezza di base. Passando a 4 bit, si riduce a un quarto. Ad esempio, tutti i modelli quantizzati nel repository Red Hat AI Hugging Face recuperano oltre il 99% dell'accuratezza di base.
Il modello gpt-oss-120b rappresenta un caso di studio utile perché il lavoro è già stato completato. Con 117 miliardi di parametri in BF16, i pesi occuperebbero circa 234 GB e sarebbero necessarie tre GPU da 80 GB per caricarli. OpenAI ha eseguito il post-addestramento del modello con quantizzazione MXFP4 sui pesi MoE (Mixture of Experts), portandolo al di sotto di 80 GB e consentendone l'esecuzione su una singola scheda.
- BF16 (ipotesi): ~234 GB → 3 GPU
- MXFP4, versione distribuita: supportata da una GPU da 80 GB
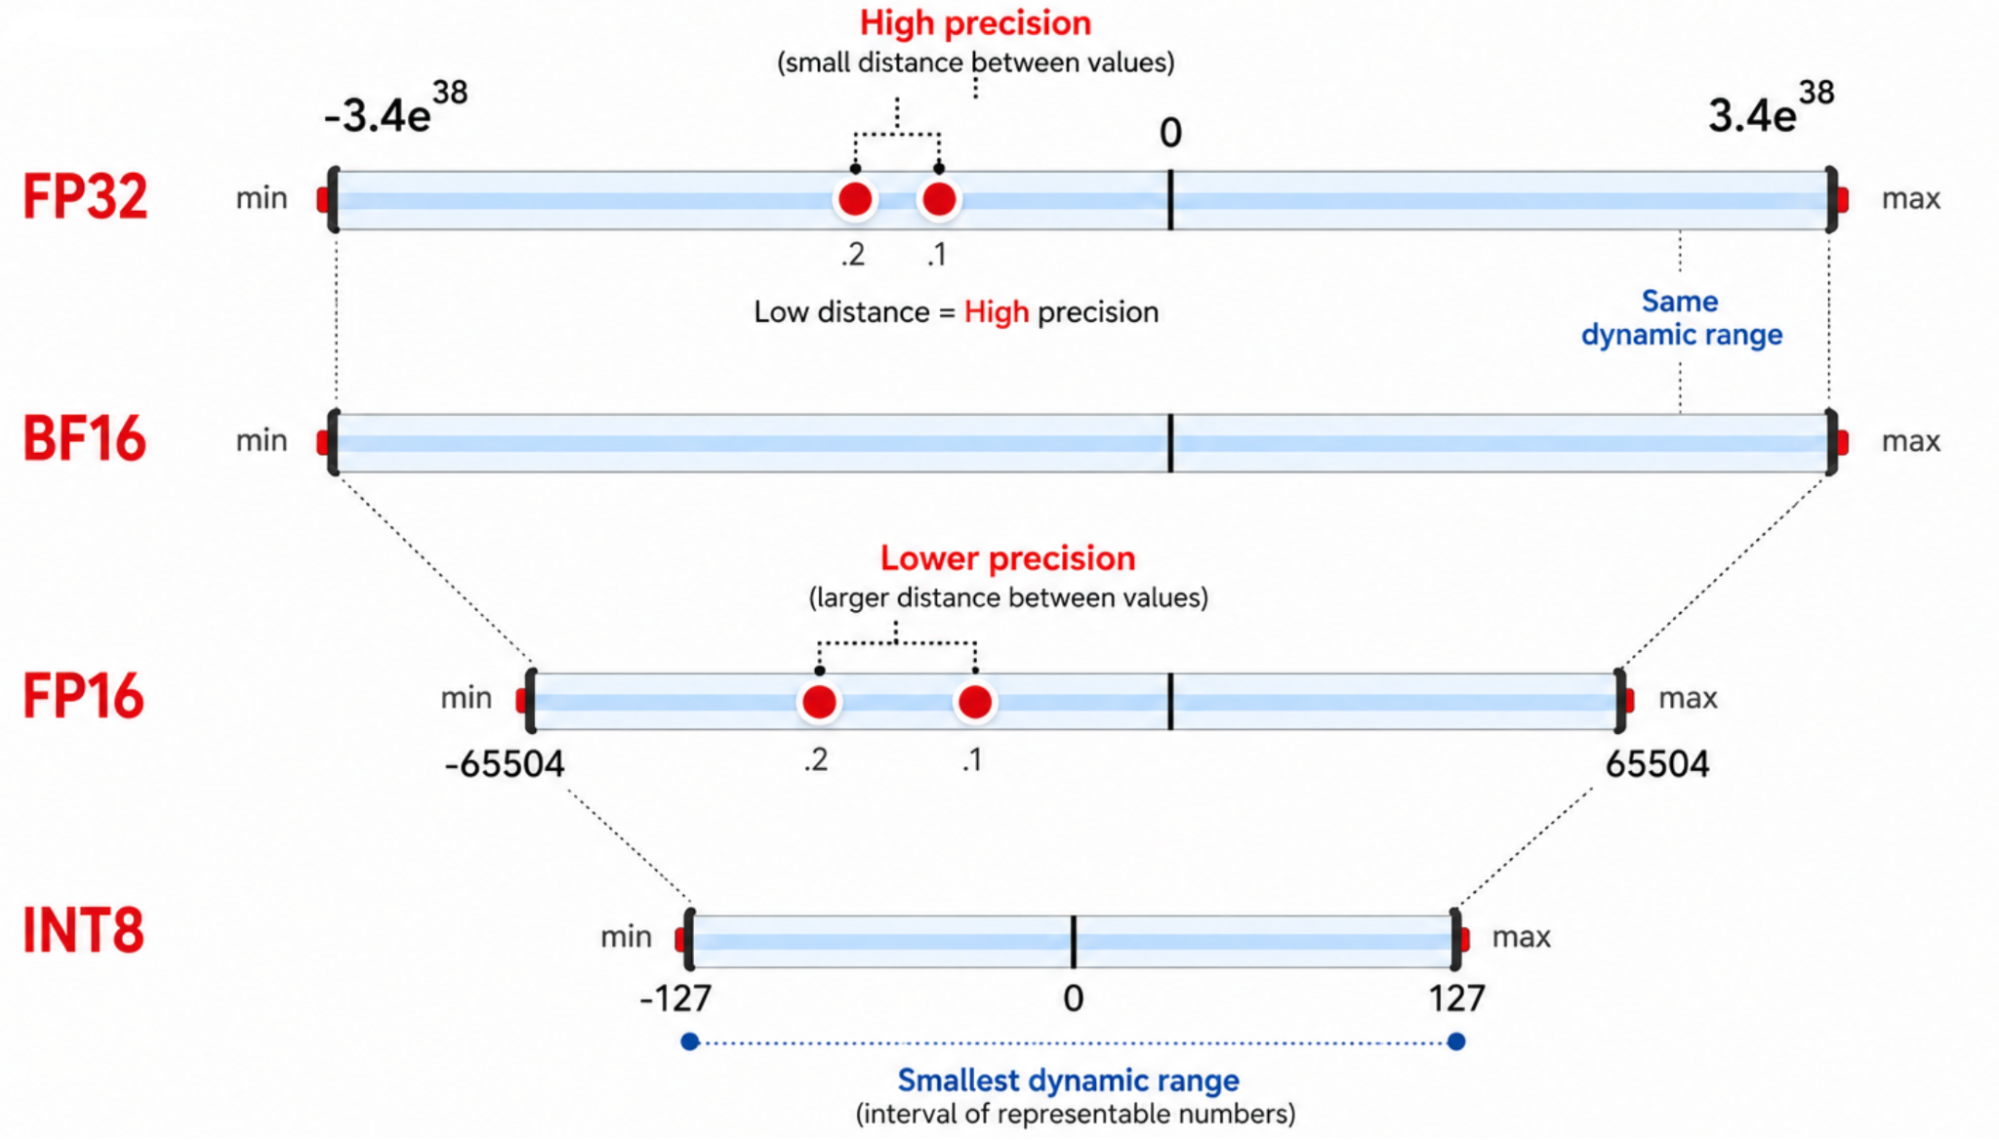
Figura 9: I formati numerici a precisione inferiore sacrificano intervallo e dettagli in cambio di un utilizzo della memoria notevolmente ridotto.
La maggior parte dei modelli non viene fornita in questo formato: in questi casi puoi procedere autonomamente oppure fare riferimento ai nostri modelli compressi su Hugging Face. In definitiva, la quantizzazione offre due vantaggi sostanziali. I pesi quantizzati comportano un minor trasferimento di dati dalla memoria a larghezza di banda elevata (HBM) alla memoria ad accesso casuale statica (SRAM) a ogni propagazione in avanti, a tutto vantaggio della latenza. Le attivazioni quantizzate consentono ai Tensor core di eseguire i calcoli con minore precisione e di completare più operazioni al secondo, migliorando il throughput. Gli schemi basati sui soli pesi come W8A16 (pesi a 8 bit, attivazioni a 16 bit) offrono il primo vantaggio, mentre formati come W8A8 (pesi Int8, attivazioni Int8) li garantiscono entrambi.
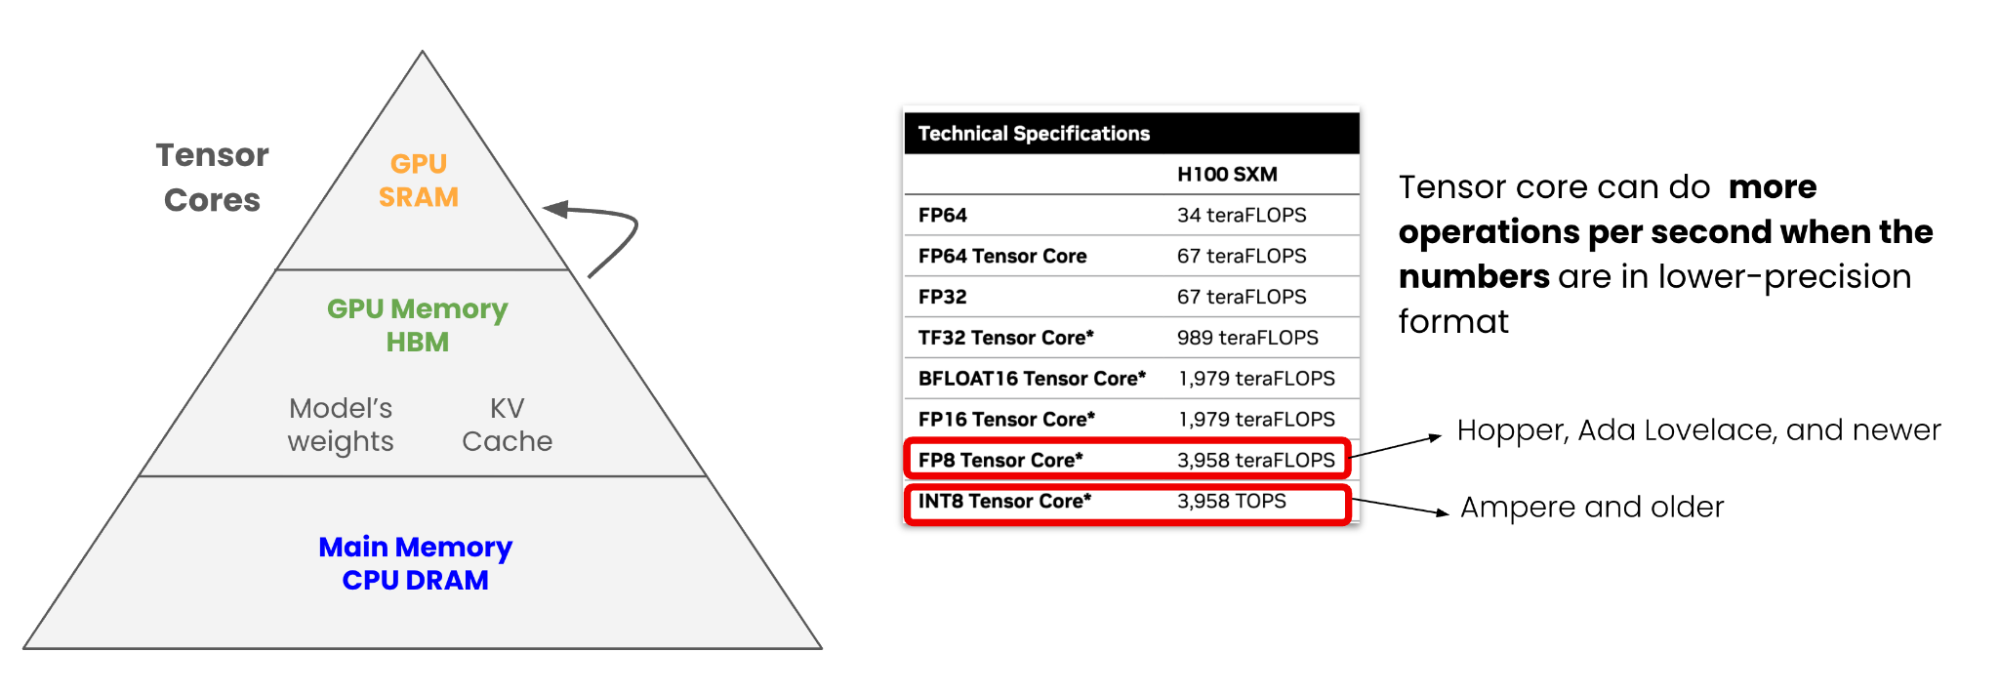
Figura 10: i pesi di dimensioni inferiori si trasferiscono più rapidamente nella memoria più veloce della GPU e i calcoli a bassa precisione vengono eseguiti con un throughput nettamente superiore sui tensor core.
In pratica, FP8 dimezza i requisiti di memoria e incrementa il throughput fino a 1,6 volte con un impatto minimo sull'accuratezza. E questo non rende il modello meno efficace. Tecniche calibrate come la quantizzazione post-addestramento generalizzata (GPTQ), la quantizzazione dei pesi con sensibilità all'attivazione (AWQ) e SmoothQuant utilizzano un set di dati ridotto e rappresentativo per identificare i pesi più critici e proteggerli, mantenendo la perdita di qualità in genere al di sotto di un punto percentuale.
Guida rapida all'ottimizzazione dei modelli di IA
Tecnica | Ambito di applicazione | Vantaggi |
PagedAttention | Runtime | Più richieste simultanee nella stessa memoria |
Batching continuo | Runtime | La GPU resta attiva tra una richiesta e l'altra |
Caching dei prefissi | Runtime | Evita il ricalcolo per i contesti condivisi |
Quantizzazione | Modello, pre-deployment | Meno GPU, caricamento più rapido, calcoli più veloci |
Sparsificazione | Modello, pre-deployment | Ignora i pesi meno importanti |
La formazione rappresenta un costo una tantum; l'inferenza è invece ricorrente e costituisce la quota maggiore della spesa. Ogni token richiede una propagazione in avanti completa. La cache KV cresce con la lunghezza del contesto e con gli utenti simultanei, e la sua gestione è il compito principale del server di inferenza. Nel nostro esempio, la differenza tra un deployment di base e uno ottimizzato sulla stessa GPU è di circa tre utenti simultanei rispetto a 50. Gestisci correttamente l'inferenza e otterrai molto di più dall'hardware di cui già disponi.
Ti è piaciuto questo contenuto?
Se desideri provarlo in prima persona, abbiamo creato un corso gratuito con DeepLearning.AI e Red Hat, e l’approccio è pratico. Quantizza un modello Qwen con LLM Compressor e valuta il compromesso di accuratezza, distribuiscilo con vLLM, esegui il benchmark con GuideLLM e procedi alla valutazione con lm-eval: Fast & Efficient LLM Inference with vLLM.
Risorsa
Muovi i primi passi con l'inferenza IA
Sull'autore
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
Altri risultati simili a questo
Inferenza IA distribuita: cosa devono sapere i leader dei fornitori di servizi di telecomunicazione
Perché l'IA agentica ha bisogno di un’insieme di tecnologie open source
Ricerca per canale

Automazione
Novità sull'automazione IT di tecnologie, team e ambienti

Intelligenza artificiale
Aggiornamenti sulle piattaforme che consentono alle aziende di eseguire carichi di lavoro IA ovunque

Hybrid cloud open source
Scopri come affrontare il futuro in modo più agile grazie al cloud ibrido

Sicurezza
Le ultime novità sulle nostre soluzioni per ridurre i rischi nelle tecnologie e negli ambienti

Edge computing
Aggiornamenti sulle piattaforme che semplificano l'operatività edge

Infrastruttura
Le ultime novità sulla piattaforma Linux aziendale leader a livello mondiale

Applicazioni
Approfondimenti sulle nostre soluzioni alle sfide applicative più difficili

Virtualizzazione
Il futuro della virtualizzazione negli ambienti aziendali per i carichi di lavoro on premise o nel cloud
