Le organizzazioni dei settori dell'istruzione superiore e delle imprese affrontano costi di virtualizzazione crescenti, strutture di licenza modificate e decisioni sull'architettura che non possono più essere rimandate. In questo panorama, i leader IT necessitano di un percorso di migrazione a basso impatto che protegga i carichi di lavoro critici attuali, definendo al contempo una base hybrid cloud moderna per il futuro.
Al Red Hat Summit 2026, Joseph Seegmiller, Infrastructure Engineer presso la Brigham Young University, ha collaborato con i Red Hat Solution Architect John Quigley e John Call per affrontare proprio queste sfide. Utilizzando Red Hat OpenShift per eseguire macchine virtuali (VM) e container in parallelo, la Brigham Young University ha consolidato la propria infrastruttura e semplificato le operazioni.
Alla fine abbiamo deciso di trasferire tutta la nostra virtualizzazione in Red Hat OpenShift Virtualization. Abbiamo eseguito la migrazione di 1.500 macchine virtuali in sole 6 settimane.
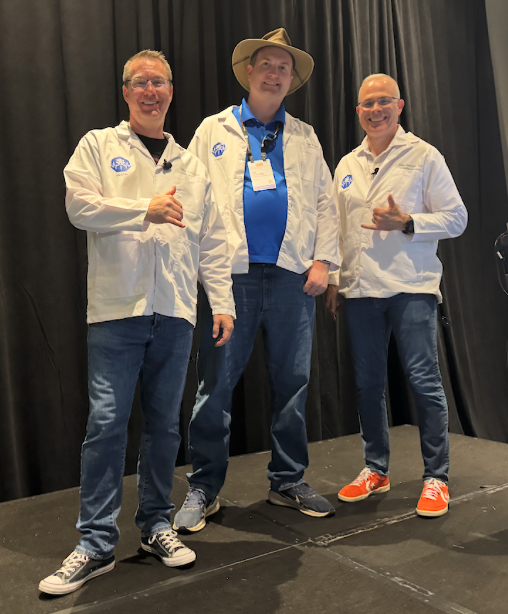
Figura 1. Joseph Seegmiller, Infrastructure Engineer presso la Brigham Young University, sul palco insieme ai Red Hat Solution Architect John Quigley e John Call.
Sebbene la migrazione rapida sia un traguardo importante, mantenere l'alta disponibilità e proteggere i carichi di lavoro stateful del database dopo il passaggio alla nuova piattaforma è la massima priorità per i team responsabili dell'infrastruttura.
Il rischio intrinseco di danneggiamento dei dati negli ambienti di storage condiviso
Per creare una piattaforma resiliente, i responsabili IT devono comprendere in che modo Red Hat OpenShift gestisce i guasti dei nodi, rispetto agli hypervisor tradizionali. Per impostazione predefinita, quando un nodo che esegue VM o carichi di lavoro containerizzati smette di rispondere, non riprogramma immediatamente i carichi di lavoro interessati. Questo ritardo è una funzione di sicurezza progettata proprio per proteggere l'integrità dei dati.
In un ambiente di storage condiviso, un errore “split brain” rappresenta una grave minaccia. Se un nodo perde la comunicazione con il piano di controllo del cluster ma rimane acceso, può comunque scrivere dati sul disco.
Se un nodo perde la connettività di rete, ma la sua connessione Fibre Channel rimane attiva, le macchine virtuali continuano a funzionare e a scrivere sul disco. Riprogrammare automaticamente la macchina virtuale su un nuovo nodo comporta il montaggio doppio del disco, causando una grave corruzione dei dati. Per questo motivo sono necessari il riavvio automatico e il fencing dei nodi.
Senza una correzione automatica, la risoluzione di questi guasti richiede un intervento manuale. Un operatore deve verificare che il nodo guasto sia del tutto offline prima di arrestare in sicurezza la precedente istanza della VM e avviarne una nuova. In un ambiente di grandi dimensioni, questa procedura manuale introduce notevoli ritardi nel ripristino.
L'interruzione ha trasformato le dashboard del nostro team operativo in un albero di Natale pieno di luci intermittenti. Ci sono volute 2 ore per risolverla. Se avessimo implementato queste strategie di correzione dei nodi, il sistema avrebbe risolto il problema in pochi minuti anziché dopo ore.
Ripristino automatico in pochi minuti con Medik8s
Per eliminare le correzioni manuali e ridurre i tempi di inattività da ore a minuti, Red Hat OpenShift integra il framework operatore Medik8s. Questo framework offre la correzione automatica dei nodi e l'alta disponibilità per i carichi di lavoro, incluse le VM.
Il processo di ripristino automatico si basa su tre componenti distinti.
- Node Health Check Operator: questo componente funge da “rilevatore di fumo” per il cluster. Monitora costantemente lo stato dei nodi di lavoro. Se un nodo segnala una condizione NotReady o Unknown per tutta la durata configurata (in genere 60 secondi), l'operatore emette un allarme e attiva un modello di correzione.
- Fence Agents Remediation (FAR): è il metodo di fencing basato sull'alimentazione più rapido. Interagisce direttamente con le interfacce Baseboard Management Controller (BMC) dell'hardware fisico, come Dell iDRAC o HPE iLO, tramite l'API standard Redfish. L'agente ordina al BMC di riavviare l'hardware. Non appena il BMC conferma il ciclo di alimentazione, il cluster elimina in modo sicuro le VM e i carichi di lavoro dei container bloccati e li ripianifica sui nodi integri, completando l'operazione in circa 155 secondi.
- Self Node Remediation (SNR): fungendo da affidabile soluzione di fallback basata su software, questo agente usa un dispositivo per il monitoraggio a livello di kernel (“watchdog”). L'agente deve interagire con il timer di questo dispositivo ogni 30 secondi. Se rileva che il nodo è isolato dai peer e dal server API, l'agente smette di azzerare il timer (pratica nota nel gergo degli amministratori di sistema come "petting the watchdog"). A questo punto il monitoraggio scade e forza il riavvio del sistema operativo locale, rilasciando in sicurezza i blocchi dello storage.
Distribuendo queste strategie, i team responsabili dell'infrastruttura proteggono le VM dalla corruzione dei dati ed eseguono il ripristino in automatico senza interventi manuali.
Ribilancia i carichi di lavoro attivi in base alla reale domande di risorse
Per ottenere un'alta disponibilità non basta superare i crash dei nodi. Occorre anche distribuire proattivamente i carichi di lavoro per evitare che i nodi esauriscano le risorse.
Lo scheduler predefinito di Kubernetes valuta le decisioni relative al posizionamento delle risorse solo durante l'avvio iniziale di una VM. Nel tempo, man mano che gli utenti accedono o eseguono attività impegnative, determinate VM possono impiegare più risorse di quelle richieste inizialmente, provocando l'esaurimento delle risorse su nodi specifici.
Per risolvere questo squilibrio, l'operatore Descheduler valuta periodicamente il cluster. Invece di affidarsi solo a richieste di risorse statiche e precedentemente allocate, il Descheduler può sfruttare i dati sui consumi effettivi in tempo reale forniti dall'interfaccia Pressure Stall Information (PSI) del kernel.
Le metriche PSI monitorano il tempo che le VM o i container trascorrono in attesa di risorse di CPU, memoria o disco (I/O). Se rileva che un nodo è soggetto a richieste di risorse elevate, il Descheduler individua le VM idonee e avvia una migrazione in tempo reale per trasferirle sui nodi meno utilizzati. Questo ribilanciamento proattivo garantisce prestazioni costanti delle applicazioni nell'intero parco macchine.
Modernizza la tua strategia di infrastruttura
La migrazione a una piattaforma applicativa di cloud ibrido unificata aiuta le organizzazioni a contenere i costi operativi, a connettere gli elementi dell'infrastruttura e creare un ambiente sicuro per lo sviluppo di applicazioni moderne. Combinando Red Hat OpenShift Virtualization con la correzione automatica e il ribilanciamento proattivo dei carichi di lavoro, i leader IT possono garantire un'alta disponibilità prevedibile per i carichi di lavoro di importanza critica.
Compi il passaggio successivo nel tuo percorso di modernizzazione della virtualizzazione.
Genera un report automatizzato sulla preparazione alla migrazionePagina disponibile in Inglese (Italiano non disponibile) : valuta all'istante l'idoneità alla migrazione dei carichi di lavoro VMware con l'OpenShift Migration Advisor gratuito.- Scarica la Guida all'architettura: accedi a istruzioni dettagliate, schemi architetturali e procedure consigliate per passare a Red Hat OpenShift Virtualization.
- Esplora con le demo interattive: guarda Red Hat OpenShift Virtualization in azione e scopri come gestire VM e container da una singola console unificata.
Risorsa
15 motivi per adottare Red Hat OpenShift Virtualization
Sull'autore
Debbie Margulies is a principal product marketing manager for Red Hat OpenShift and has been at Red Hat since 2019 through the acquisition of StackRox.
Altri risultati simili a questo
Perché le aziende rimandano le decisioni sulla virtualizzazione
Gestisci le macchine virtuali su Red Hat OpenShift con Service Mesh
Virtualization Is (Still) King | Compiler
Scopri di più
- Sintesi: Portfolio dei servizi cloud di Red Hat OpenShift
- Il Total Economic Impact™ dei servizi cloud Red Hat OpenShift
- Ebook: Rinnova il tuo ambiente IT con i servizi cloud gestiti
Ricerca per canale

Automazione
Novità sull'automazione IT di tecnologie, team e ambienti

Intelligenza artificiale
Aggiornamenti sulle piattaforme che consentono alle aziende di eseguire carichi di lavoro IA ovunque

Hybrid cloud open source
Scopri come affrontare il futuro in modo più agile grazie al cloud ibrido

Sicurezza
Le ultime novità sulle nostre soluzioni per ridurre i rischi nelle tecnologie e negli ambienti

Edge computing
Aggiornamenti sulle piattaforme che semplificano l'operatività edge

Infrastruttura
Le ultime novità sulla piattaforma Linux aziendale leader a livello mondiale

Applicazioni
Approfondimenti sulle nostre soluzioni alle sfide applicative più difficili

Virtualizzazione
Il futuro della virtualizzazione negli ambienti aziendali per i carichi di lavoro on premise o nel cloud
