
Es ist Freitagabend. Priya, ML-Engineer (Machine Learning) bei einem Finanzdienstleistungsunternehmen, reiht einen Fine Tuning-Job zur Betrugserkennung in die Warteschlange auf einem GPU-Cluster ein, der 55 USD pro Stunde kostet. Die Ausführung sollte etwa 40 Stunden dauern – das entspricht etwa 2.200 USD an Computing-Kosten. Sie prüft die Hyperparameter nochmals, sendet den Job ab und verabschiedet sich ins Wochenende.
Am Montagmorgen öffnet sie ihren Laptop. Das Modell hat den Lernprozess irgendwann am Freitagabend beendet, aber der Job lief weiter. So wurden bei einem ergebnislosen Trainingslauf 2 volle Tage GPU-Zeit verbraucht. Das sind über 1.500 USD an verschwendeter Computing-Leistung, und sie muss von vorn beginnen.
Wenn Ihnen das bekannt vorkommt, sind Sie nicht allein. Fast alle Fachkräfte, die schon einen mehrtägigen Trainingsjob durchgeführt haben, kennen diese unbequemen Fragen:
- Lernt das Modell tatsächlich etwas?
- Sollte ich frühzeitig abbrechen und andere Hyperparameter ausprobieren?
- Wird der Prozess vor der Stakeholder-Bewertung am Dienstag abgeschlossen?
Die Kosten des Nichtwissens sind real. On-Demand-GPU-Cluster können mehr als 50 USD pro Stunde kosten. Ein einzelner mehrtägiger Trainingslauf kann leicht Tausende von USD kosten. Eine falsch konfigurierte Ausführung kann ein ganzes Wochenende an Rechenleistung verschwenden, bevor dies bemerkt wird. In gemeinsam genutzten Clustern vervielfacht sich die Auswirkung: Ein ins Stocken geratener Job verschwendet nicht nur das Budget eines Teams, sondern hindert andere Teams daran, auf die benötigten GPUs zuzugreifen. Der Blind Run eines Teams führt zur Verzögerung bei einem anderen Team. Das Problem ist nicht, dass die Teams nachlässig sind. Es liegt daran, dass sie im Blindflug agieren. Jede GPU-Stunde zählt. Ohne Echtzeittransparenz beim Trainingsfortschritt wird zu viel davon verschwendet.
Die Observability-Lücke
Hier ist die unbequeme Wahrheit: Aus Sicht der Plattform sehen ein erfolgreich konvergierender Trainingsjob und ein komplett ins Stocken geratener Job identisch aus. Beides sind Pods im Status running, die dieselben Ressourcen verbrauchen und denselben grünen Statusindikator anzeigen. Kubernetes hat keine Vorstellung davon, ob Ihr Modell lernt.
Heutzutage ist es möglich, den Trainingsfortschritt zu überwachen, aber es ist schwieriger, als es sein sollte.
- Logs sind verstreut und schwer nutzbar: In einem verteilten Trainingsjob werden die Logs auf mehrere Pods verteilt. Um die relevante Ausgabe zu finden, müssen Sie wissen, welcher Pod relevant ist, wie Sie darauf zugreifen und wie Sie Framework-spezifische Logformate interpretieren. Dies erfordert Kubernetes-Expertise. Das sind zusätzliche Fähigkeiten, die die meisten Data Scientists und AI Engineers nicht erwerben müssen sollten, nur um ihre Trainingsläufe zu überwachen. Fehlerhafte und unstrukturierte Logs sind nicht leicht maschinenlesbar und können daher keine Automatisierung steuern.
- Externe Tools ermöglichen Observability, erhöhen jedoch den Verwaltungsaufwand: Plattformen zum Experiment-Tracking wie MLflow und Weights & Biases sind für ihre Zwecke hervorragend geeignet. Sie erfordern jedoch zusätzliche Infrastruktur für Deployment und Wartung sowie API-Schlüssel und Zugriffskontrollen. Zudem agieren sie oberhalb der Plattformebene. Sie sind außerdem von der Kubernetes-API getrennt, sodass es schwieriger ist, sie in benutzerdefinierte Kubernetes-native Workflows und Operatoren zu integrieren. Sie zeigen an, was innerhalb der Trainingsschleife passiert ist, können der Plattform aber nicht mitteilen, was gerade geschieht.
- Jedes Framework geht anders vor: PyTorch DDP, FSDP, DeepSpeed, JAX – jedes Framework hat eigene Logging-Konventionen, Metrikformate und Methoden zur Fortschrittsmeldung. Es gibt keine Konsistenz zwischen den Frameworks, was bedeutet, dass es keine einheitliche Ansicht für Plattform-Teams gibt, die eine heterogene Trainingsumgebung verwalten.
- Es gibt keine Standard-API: Bislang gab es bei Trainingsjobs keine standardisierte Möglichkeit, den Fortschritt an die Plattform zu melden. Infolgedessen müssen Plattform-Teams, die gemeinsam genutzte GPU-Cluster verwalten, schätzen, welche Jobs voranschreiten, welche stocken und welche kurz vor dem Abschluss stehen. Ohne diese Transparenz basieren Kapazitätsplanung und Fehlerbehebung auf Vermutungen.
Die Lücke schließen: Fortschrittsverfolgung in Red Hat OpenShift AI
Red Hat OpenShift AI umfasst jetzt eine produktionsbereite Fortschrittsverfolgung für verteilte Trainingsjobs. Diese ist in Kubeflow Trainer v2 integriert und ab Red Hat OpenShift AI 3.4 allgemein verfügbar. Sie sehen in Echtzeit, was passiert, und können handeln, bevor es zu spät ist. Diese Funktion schließt die Observability-Lücke direkt. Sie bietet Data Scientists, ML-Engineers und Plattform-Teams Echtzeittransparenz bei der Performance von Trainingsjobs.
Diese Transparenz basiert auf den folgenden 3 Säulen:
- Dashboard-Visualisierung: Fortschrittsmetriken in Echtzeit sind direkt im Dashboard von Red Hat OpenShift AI sichtbar. Auf einen Blick sehen Sie den prozentualen Fortschritt, den aktuellen Schritt sowie die Gesamtzahl der Schritte, die aktuelle Epoche, die geschätzte Restzeit, den Trainingsverlust und die Evaluierungsmetriken für Ihre TrainJobs. Kein separates Tool, kein zusätzliches Setup.
- SDK-Integration: Dieselben Fortschrittsdaten sind programmgesteuert über das Kubeflow-SDK verfügbar. Dies ermöglicht Teams den Aufbau automatisierter Pipelines, die auf den Trainingsfortschritt reagieren. Sie können das Training vorzeitig beenden, Benachrichtigungen senden oder Ressourcen basierend auf Echtzeitmetriken neu zuweisen.
- Multi-Framework-Konsistenz: Die Fortschrittsverfolgung funktioniert konsistent, unabhängig davon, ob Sie PyTorch DDP, FSDP, DeepSpeed oder JAX nutzen. Über die CustomTrainer-API wird auch benutzerdefinierter Trainingscode unterstützt. Dies bietet eine einheitliche Erfahrung über verschiedene Frameworks hinweg.
Ihr Training im Blick
Am besten lässt sich die Fortschrittsverfolgung verstehen, wenn man die tatsächliche Nutzung betrachtet. Diese 3 Schritte sind wichtig.
- Starten Sie Ihren Trainingsjob: Sie übermitteln einen Trainingsjob wie gewohnt über ein Notebook mit dem Kubeflow-SDK. Bei der Nutzung von HuggingFace Transformers erfolgt die Fortschrittsverfolgung automatisch – Codeänderungen sind nicht erforderlich. Die Integration erkennt die Kubeflow-Umgebung und meldet Metriken aus Ihrer Trainingsschleife.
- Verfolgen Sie den Fortschritt: Während des Trainings werden Echtzeitmetriken im Dashboard von Red Hat OpenShift AI angezeigt: Fortschritt in Prozent, geschätzte verbleibende Zeit, abgeschlossene Schritte, Epochen, Gradientennormal, Trainingsverlust, Lernrate. Kein Log-Tailing, kein SSH-Zugriff auf Pods, keine externen Tools, die eingerichtet werden müssen.
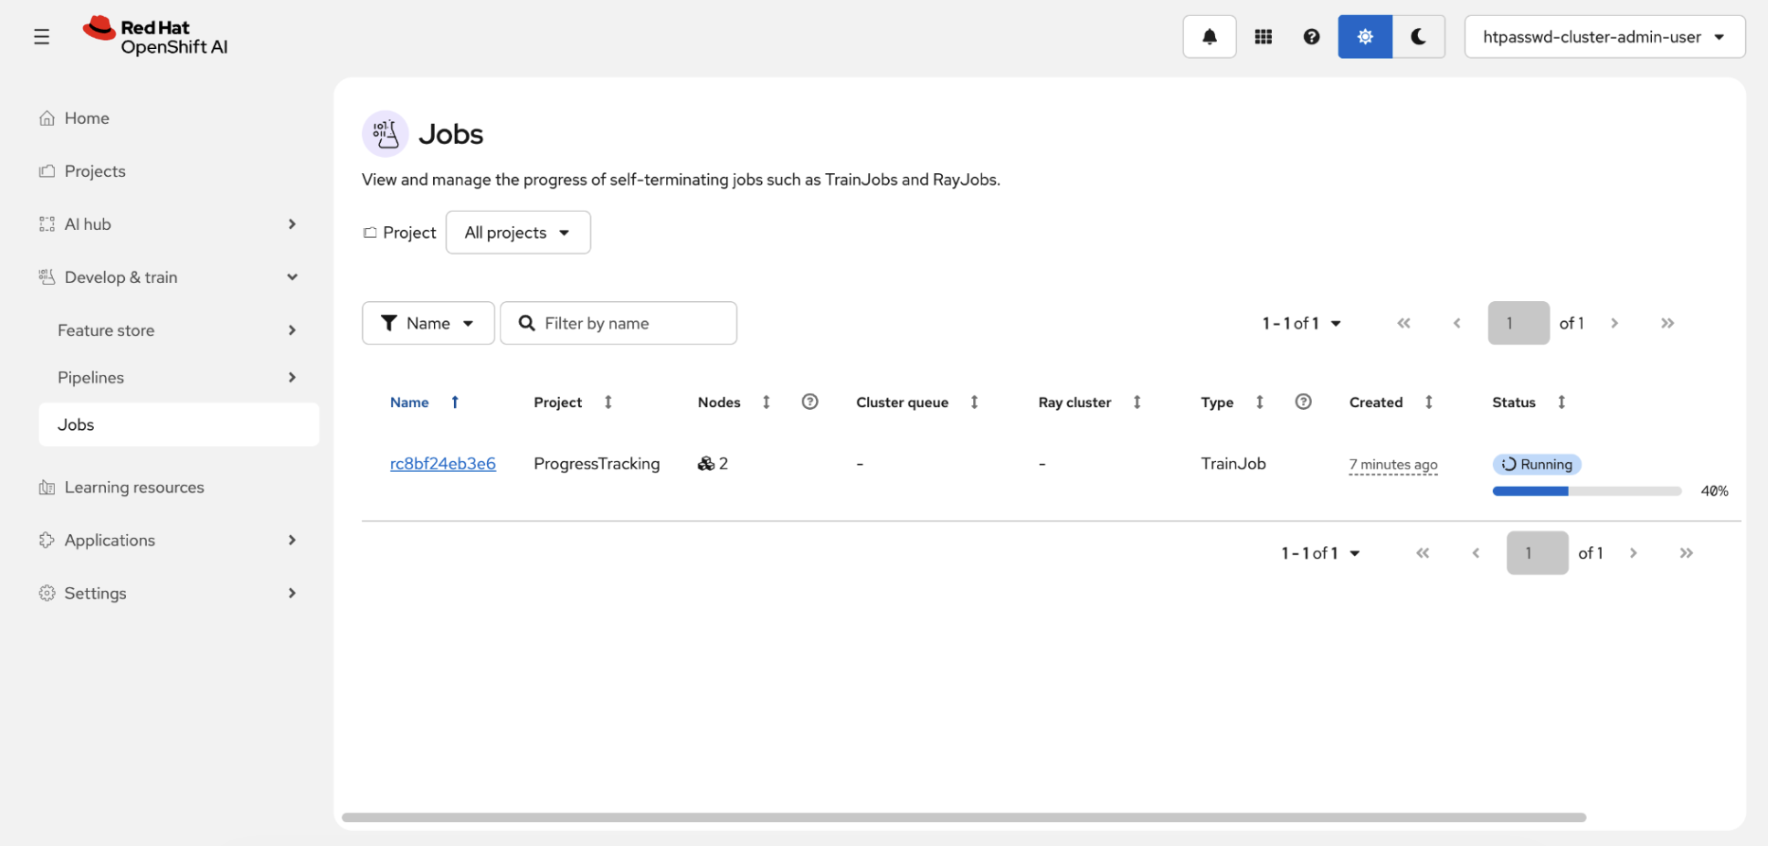
Abbildung 1: Das Dashboard von Red Hat OpenShift AI zeigt eine Liste von Jobs mit einem Fortschrittsbalken an, der eine Fertigstellung von 40 % für einen ausgeführten TrainJob angibt.
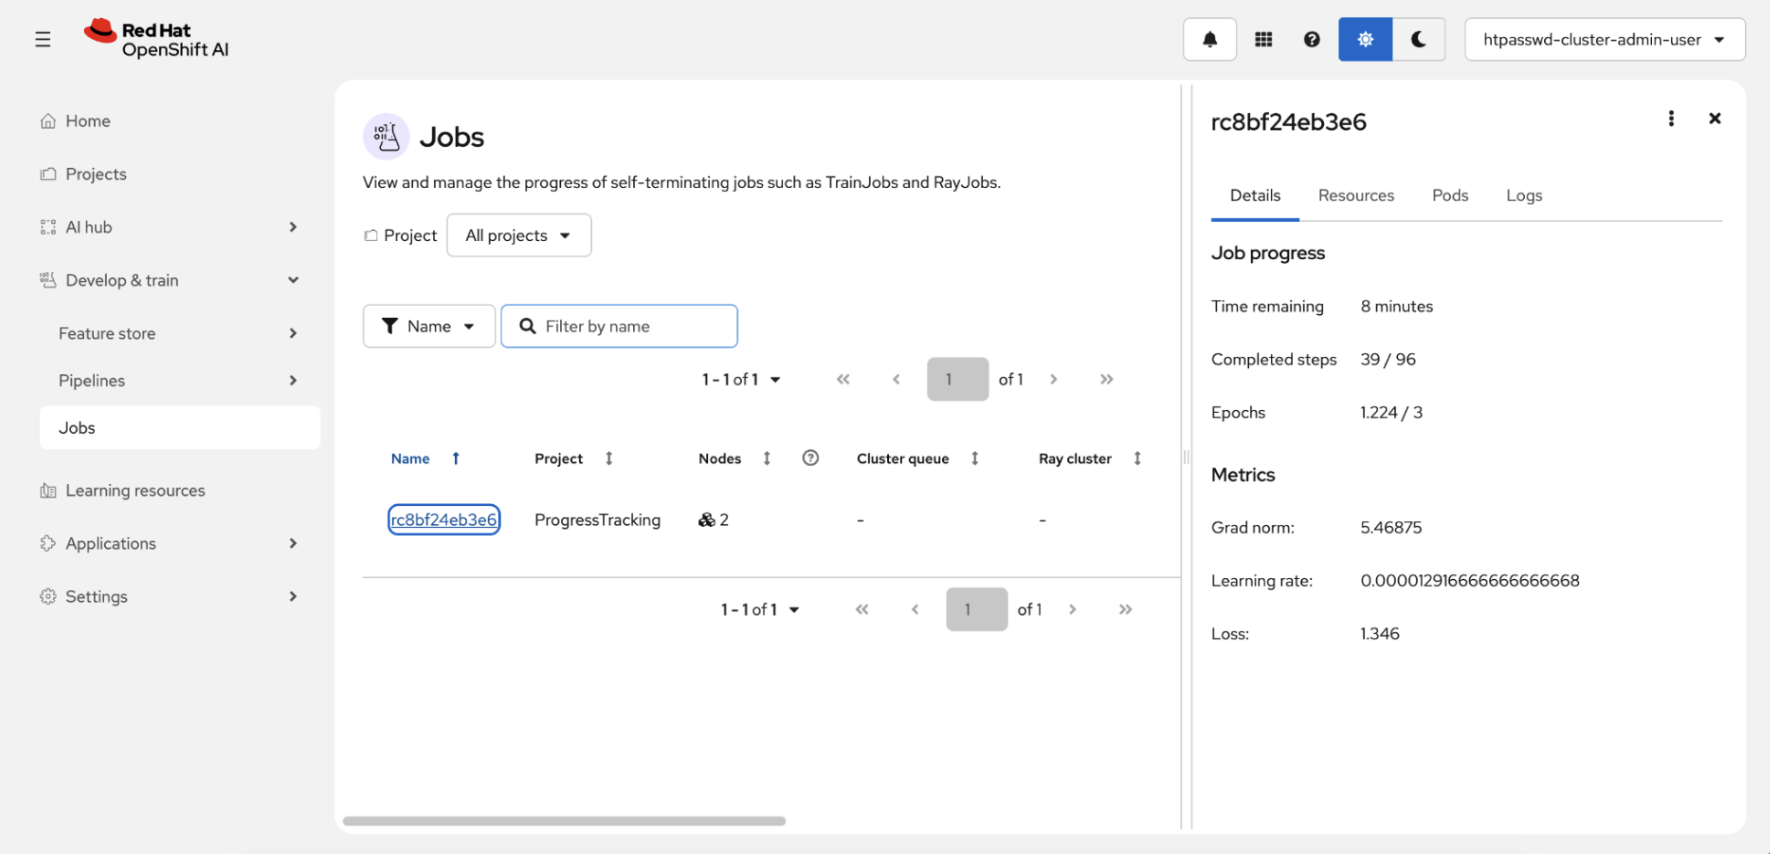
Abbildung 2: Ein detailliertes Seitenpanel zeigt den Jobfortschritt und Echtzeitmetriken an.
- Handeln Sie basierend auf Ihren Erkenntnissen: Hier spart die Fortschrittsverfolgung tatsächlich Zeit und Rechenleistung. Sie bemerken, dass sich der Verlust nicht bessert? Stoppen Sie den Job frühzeitig und sparen Sie Stunden an GPU-Zeit. Sehen Sie, dass die Ausführung schneller als erwartet konvergiert? Geben Sie Ressourcen für Ihre Teammitglieder frei. Wissen Sie genau, wann ein Job endet, um besser planen zu können. So müssen Sie nicht mehr spekulieren, ob die Ergebnisse für die Stakeholder-Bewertung am Dienstag bereit sind.
Die wichtigsten Merkmale, die eine praktische Anwendung ermöglichen:
- Zero-Setup: Keine zusätzliche Infrastruktur, keine externen Abhängigkeiten, keine zusätzlichen Konfigurationen. Die Fortschrittsverfolgung funktioniert sofort.
- Minimaler Overhead: Metriken werden an natürlichen Trainings-Checkpoints gemeldet, ohne die Trainingsleistung zu beeinträchtigen.
- Framework-übergreifend: Ob Sie PyTorch DDP, FSDP, DeepSpeed, JAX oder benutzerdefinierten Trainingscode nutzen – die Erfahrung bleibt gleich.
Wer profitiert
Data Scientists sowie ML- und AI Engineers sehen Trainingsverlust, Fortschritt in Prozent und die ETA in Echtzeit, ohne SSH-Zugriff auf Pods oder Log-Tailing. Erkennen Sie Abweichungen oder stagnierendes Training frühzeitig. Wenn Sie einen Job am Samstagvormittag statt am Montag stoppen, sparen Sie viele Stunden an GPU-Zeit. Vergleichen Sie Trainingsläufe auf einen Blick im Dashboard, um schnell zu ermitteln, welche Konfigurationen von Hyperparametern am besten funktionieren.
Plattform-Teams erhalten eine zentrale Dashboard-Ansicht für alle Trainingsjobs im Cluster. Sie sehen konsistente Metriken, unabhängig davon, ob ein Job DDP, FSDP oder DeepSpeed nutzt. Dies ermöglicht bessere Entscheidungen bei der Kapazitätsplanung, da sie nachvollziehen können, welche Jobs Fortschritte machen, welche stocken und welche kurz vor dem Abschluss stehen.
In mandantenfähigen GPU-Umgebungen, in denen mehrere Teams denselben Cluster nutzen, verbessert diese Transparenz die Ressourcennutzung und den ROI direkt. Für Unternehmen, die ein GPU as a Service model entwickeln, schließt die Fortschrittsverfolgung eine entscheidende Lücke. Sie verwandelt die „Blackbox“ der GPU-Auslastung in ein beobachtbares, verwaltbares System. Letztendlich können Plattform-Teams Infrastrukturengpässe beseitigen und Data Scientists die Ressourcen zur Verfügung stellen, die sie zur Beschleunigung von KI-Innovationen benötigen.
Über das Monitoring hinaus: eine Basis für intelligentes Training
Die Fortschrittsverfolgung ist mehr als nur eine Monitoring-Funktion – sie bildet eine Basis. Sobald die Plattform Zugriff auf Echtzeit-Daten zum Trainingsfortschritt hat, ist eine Reihe intelligenterer Verhaltensweisen möglich. Obwohl diese erweiterten Funktionen noch keine Produktzusagen von Red Hat sind, ist die Grundlage geschaffen. Die Upstream-Community von Kubeflow Trainer erkundet aktiv verschiedene Richtungen:
- Intelligenteres Hyperparameter-Tuning: Heutzutage verlassen sich Engines zur Hyperparameter-Optimierung wie Katib auf das Parsen von Logs mit fehleranfälligen Regex-Mustern, um die Performance von Versuchen zu bewerten. Da die Trainingsmetriken direkt in der Kubernetes-API verfügbar sind, kann Katib den Trainingsstatus nativ abrufen. Dies ermöglicht eine engere Integration und eine effizientere Orchestrierung der Versuche. Dies ist das KEP, das in der Upstream-Community diskutiert wird.
- Elastische Skalierung: Daten zu Konvergenzgeschwindigkeit und ETA könnten in die Entscheidungsfindung für das vertikale und horizontale Skalieren einfließen. Ein schnell konvergierendes Modell könnte GPUs für andere Teams freigeben, während ein stagnierendes Modell zusätzliche Worker anfordern könnte. Die Upstream-Community untersucht derzeit den elastischen PyTorch-Support in TrainJob, um dies zu ermöglichen.
- CLI-Fortschrittsanzeige:
kubectl get trainjobmit einer integrierten SpaltePROGRESS %würde den Trainingsfortschritt direkt in die Befehlszeile bringen. Dies bietet Teams sofortige Transparenz ohne Dashboard oder SDK. - Intelligenteres Checkpointing: OpenShift AI unterstützt bereits regelmäßiges und bedarfsgerechtes Modell-Checkpointing. Mit verfügbaren Fortschrittsdaten könnte die Plattform intelligentere Entscheidungen über Checkpoint-Zeitpunkte treffen, etwa durch automatisches Speichern basierend auf der Job-ETA. Die Upstream Community erkundet transparentes GPU-Checkpointing mit CRIU, um die Fehlertoleranz und Resilienz von TrainJob zu verbessern.
Diese Bereiche werden im Kubeflow-Projekt aktiv erkundet. Es handelt sich nicht um Produktzusagen, aber sie verdeutlichen die Relevanz der Fortschrittsverfolgung: Sie schafft die Datenschicht, auf die der gesamte Trainings-Stack aufbauen kann.
Die Fortschrittsverfolgung für verteiltes Training ist in Red Hat OpenShift AI 3.4 allgemein verfügbar. Weitere Informationen finden Sie in der Dokumentation zu Red Hat OpenShift AI. Oder testen Sie Red Hat OpenShift AI selbst mit einer 60-tägigen Testversion.
Ressource
E-Book: KI-Bereitschaft heißt Disruptionsbereitschaft
Über den Autor
I am a Software Quality Engineer at Red Hat specializing in Kubeflow and distributed AI training. I am focused on making large-scale infrastructure efficient and resilient, and I share insights on distributed model training and fine-tuning on Kubernetes.
Ähnliche Einträge
Warum Ihr Framework für KI-Agenten nicht ausreicht
Open Source KI-Sicherheit und Governance mit asago
How Red Hat cleared IT debt for scalable AI
Standardizing the AI stack with PyTorch
Nach Thema durchsuchen

Automatisierung
Das Neueste zum Thema IT-Automatisierung für Technologien, Teams und Umgebungen

Künstliche Intelligenz
Erfahren Sie das Neueste von den Plattformen, die es Kunden ermöglichen, KI-Workloads beliebig auszuführen

Open Hybrid Cloud
Erfahren Sie, wie wir eine flexiblere Zukunft mit Hybrid Clouds schaffen.

Sicherheit
Erfahren Sie, wie wir Risiken in verschiedenen Umgebungen und Technologien reduzieren

Edge Computing
Erfahren Sie das Neueste von den Plattformen, die die Operations am Edge vereinfachen

Infrastruktur
Erfahren Sie das Neueste von der weltweit führenden Linux-Plattform für Unternehmen

Anwendungen
Entdecken Sie unsere Lösungen für komplexe Herausforderungen bei Anwendungen

Virtualisierung
Erfahren Sie das Neueste über die Virtualisierung von Workloads in Cloud- oder On-Premise-Umgebungen
