-
Produkte und Dokumentation Red Hat AI
Eine Plattform mit Produkten und Services für die Entwicklung und Bereitstellung von KI in der Hybrid Cloud.
Red Hat AI Enterprise
Erstellen, entwickeln und stellen Sie KI-gestützte Anwendungen in der Hybrid Cloud bereit.
Red Hat AI Inference
Optimieren Sie die Modellperformance mit einem integrierten Stack für schnelle, konsistente und kosteneffiziente Inferenz in großem Umfang.
Red Hat Enterprise Linux AI
Entwickeln, testen und nutzen Sie generative KI-Modelle zur Unterstützung von Unternehmensanwendungen.
Red Hat OpenShift AI
Entwickeln und implementieren Sie KI-gestützte Anwendungen und Modelle in großem Umfang in Hybrid-Umgebungen.
-
Lernen Grundlagen
Warum Red Hat AI?
-
KI-Partner
Warum Sie sich mit KI-Inferenz befassen sollten
Einfach ausgedrückt: Ohne Inferenz gibt es keine KI. Sie ist das Kernstück generativer KI.
Die gute Nachricht ist, dass wir wissen, wie erfolgreich sie sein kann. Die Herausforderung besteht darin, sie zu skalieren.
Im Folgenden wird die Skalierung der KI-Inferenz mit Open Source-Tools wie vLLM und llm-d erläutert.
Die Bedeutung von Inferenz
Inferenz ist der letzte Schritt, in dem ein Modell die gewünschte Ausgabe liefert. Das ist eine notwendige Funktion für den Erfolg von KI.
Deshalb können Hardware und Software, die die Inferenz unterstützen, über Erfolg oder Misserfolg Ihrer KI-Strategie entscheiden.
Die Architektur mit den meisten Skalierungsoptionen basiert auf Open Source-Technologie.
Hindernisse bei der Skalierung
Wir wissen, dass KI funktioniert – die Herausforderung besteht darin, sie im gesamten Unternehmen zu skalieren.
Beim Skalieren von Modellen sind mehr Daten und Arbeitsspeicher erforderlich. In diesem Fall haben Hardware und Beschleuniger Schwierigkeiten, mitzuhalten.
Ein Drittanbieter scheint die einfachste Lösung zu sein. Die Token-Kosten summieren sich aber schnell und übersteigen manchmal die KI-Anwendung selbst.
40 %
Bis 2030 wird Inferenz die vorrangige Workload in KI-Rechenzentren sein und voraussichtlich bis zu 40 % des Gesamtbedarfs von Rechenzentren ausmachen.1
Verbesserte Inferenz
Durch Optimieren der Inferenz auf einer Open Source-Architektur können KI-Modelle schneller und intelligenter ausgeführt werden.
Zu den Optimierungsstrategien gehören:
- Komprimierung von Modellen mit Quantisierung
- Effizientere Verarbeitung von GPUs
- Spekulative Dekodierung
- Verteilte Inferenz
- Auslagerung von Arbeitsspeicher- und Orchestrierungsaufgaben auf CPUs
Dank solcher Optimierungen bleibt die KI-Inferenz kosteneffizient und kann so mit Ihren Teams nach und nach skaliert werden.
19 %
Kosteneinsparungen in großem Umfang bei Verwendung spekulativer Dekodierungstechniken2

2-mal
mehr Rechenleistung durch komprimierte Modelle, ohne Verlust an Genauigkeit3
90 %
Gesamte End-to-End-Latenz, die auf CPUs entfallen4
Inferenzoptimierung durch vLLM
Das Optimieren von Modellen allein reicht nicht aus. Sie benötigen außerdem eine leistungsstarke Inferenz-Engine. Hier kann vLLM weiterhelfen.
Traditionelle LLM-Speicherverwaltungssysteme organisieren den Speicher nicht besonders effizient. Das führt zur Verlangsamung von LLMs. vLLM nutzt PagedAttention, eine Speicherverwaltungstechnik, die sich wiederholende Schlüsselwerte identifiziert, um den LLMs zusätzliche Arbeit zu ersparen.
So kann vLLM den GPU-Speicher besser nutzen und die generative KI-Inferenz beschleunigen. Dadurch lässt sich der Durchsatz (die Anzahl der pro Sekunde verarbeiteten Tokens) maximieren, um viele Nutzende gleichzeitig zu unterstützen.
Durch den effizienteren Einsatz von Beschleunigern können Modelle mehr Berechnungen in kürzerer Zeit durchführen, sodass Teams mehr Nutzende und Agenten schneller unterstützen können.
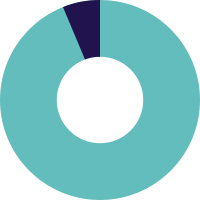
75 %
geringere Speicheranforderungen, wodurch weniger GPUs erforderlich sind5
4-mal
so viele verarbeitete Token pro Sekunde im Vergleich zu den meisten Inferenzanbietern6
24-fach
höhere Durchsatz-Performance mit vLLM im Vergleich zu Mitbewerbern7
Gründe für die zunehmende Verbreitung von vLLM
vLLM hat dazu beigetragen, die Kernprobleme im Zusammenhang mit einer effizienten GPU-Nutzung zu lösen und niedrigere Kosten pro Token sowie eine stabile Latenz in großem Umfang zu erzielen, und zwar mit einem offenen, portierbaren Deployment-Ansatz.
Mit Day 0-Support für sämtliche wichtigen Modelle und Beschleuniger ist diese Art der Zugänglichkeit sowohl für die Branche als auch für die Wissenschaft attraktiv. Deshalb ist die vLLM-Community so aktiv und lebendig.
Die Beiträge stammen von Hugging Face, UC Berkeley, NVIDIA, Red Hat und vielen mehr. Die Community testet und verbessert die Software im Open Source-Projekt kontinuierlich.
über 10.000
vLLM GitHub Commits* – ein Anstieg von über 200 % – im Jahr 2026.
Aktueller Stand der vLLM Community
über 500.000
GPUs rund um die Uhr im Einsatz8
über 200.000
verschiedene Beschleunigertypen9
über 500.000
unterstützte Modellarchitekturen9
über 3.100
Einsatzbereiche verteilter Inferenz
Verteilte Inferenz sorgt dafür, dass KI-Modelle die Inferenzarbeit auf eine Gruppe miteinander verbundener Geräte aufteilen können.
Wenn ein Modell verschiedene Anforderungen gleichzeitig erfüllen kann, reduziert dies den Hardwarebedarf erheblich und erhöht die Inferenzeffizienz.
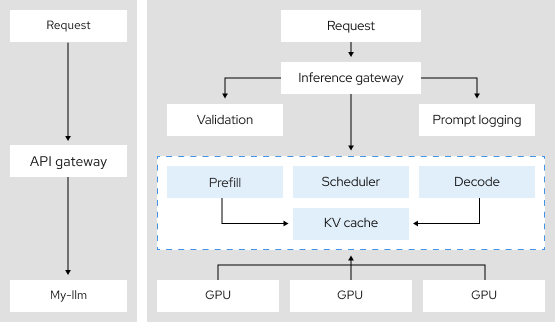
Verteilte Inferenz nutzt Techniken wie Tensorparallelität, intelligente Inferenzplanung und Disaggregation. Durch die Kombination mit vLLM verwandelt sich Inferenz in eine äußerst effiziente Multitasking-Maschine.
So bleibt Inferenz beobachtbar, skalierbar und konsistent.
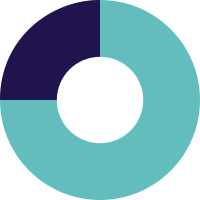
99 %
geringere Zeit bis zum ersten Token (TTFT) bei äquivalenter Last 10

Gibt es dafür eine Open Source Community?
Ja, sie heißt llm-d.
llm-d ist ein Open Source Framework, das Entwicklungsteams einen Blueprint für das Entwickeln verteilter Inferenz in großem Umfang bietet.
Die modulare Architektur unterstützt die komplexen Ressourcenanforderungen anspruchsvoller LLMs und ersetzt manuelle, fragmentierte Prozesse durch integrierte Well-lit Paths, wodurch die Zeit vom Pilotprojekt bis zur Produktion verkürzt wird.
llm-d integriert Inferenz in Kubernetes und bietet ein standardisiertes Toolkit, mit dem Sie verteilte Inferenz auf Ihre individuellen Unternehmensanwendungen anwenden können.
2-fache
Steigerung der Anzahl der Nutzenden, die mithilfe von llm-d-optimierten Clustern auf derselben Hardware arbeiten können 11
Weitere KI-Ressourcen
Red Hat AI Inference
Beschleunigen Sie die Umsetzung Ihrer LLMs vom Code zur Produktion.
Unsere auf vLLM basierende Inferenz-Engine für Unternehmen ermöglicht schnellere Inferenz ohne Einbußen bei der Performance.
Skalieren Sie Ihre Hybrid Cloud mit Ihrem bevorzugten und optimierten gen KI-Modell, auf beliebigen KI-Beschleunigern und in beliebigen Cloud-Umgebungen.

Verwendete Quellen
[1] „Die Zukunft von KI-Workloads“. McKinsey & Company, 24. Feb. 2026.
[2] Umesh, Harshith. „Performance-Verbesserungen durch spekulative Dekodierung in vLLM für gpt-oss“. Red Hat Developer Blog, 16. April 2026.
[3] Kurtić, Eldar, et al. „2:4 Sparse Llama: Kleinere Modelle für effiziente GPU-Inferenz.“ Red Hat Developer Blog, 28. Feb. 2025.
[4] Bowerman, Sawyer. Ableidinger, Grace. „Die CPU ist zurück: Überdenken der CPU-GPU-Aufteilung für LLM-Inferenzen“ Red Hat Blog, 6. Aug. 2026.
[5] „Was ist LLM Compressor?“ vLLM-Dokumente.
[6] „vLLM führt die Liste bei künstlicher Analyse an“. vLLM Blog, 11. Mai, 2026.
[7] Kwon, Woosuk, et al. „vLLM: Einfacher, schneller und günstiger LLM-Service mit PagedAttention.“ vLLM Blog, 20. Juni 2023.
[8] Goin, Michael. „[vLLM Office Hours Nr. 38] vLLM 2025 Retrospective & 2026 Roadmap – 18. Dezember 2025.“ YouTube, 8. Dez. 2025.
[9] Kwon, Woosuk. „Today, vLLM supports 500+ model architectures, runs on 200+ accelerator types, and powers inference at global scale.“ X, 26. Jan. 2026.
[10] Singh, Naina. „Die gleichen 16 GPUs, doppelt so viele Nutzende: Inferenzkonformes Routing für LLM-Cluster“ Red Hat Blog, 27. Mai 2026.
[11] Singh, Naina. „Die gleichen 16 GPUs, doppelt so viele Nutzende: Inferenzkonformes Routing für LLM-Cluster“ Red Hat Blog, 27. Mai 2026.
