Die Geschwindigkeit, mit der neue Funktionen hinzugefügt und Anwendungen weiterentwickelt werden, führt unmittelbar zu mehr Komplexität in der Architektur. Dieses unaufhörliche Tempo wird nicht nur durch den Wunsch nach neuen Funktionen getrieben. Es wird zunehmend durch die ständige Entdeckung neuer Schwachstellen forciert. Das Patchen einer einzelnen kritischen Abhängigkeit kann eine ganze Reihe erforderlicher Updates und unerwarteter Architekturänderungen auslösen, da die einzelnen Produkte und Lösungen eine Vielzahl von Implementierungsoptionen und verschiedene zu aktivierende oder zu deaktivierende Funktionen umfassen. Wenn Sie diese Komplexität an Ihre spezifische Umgebung anpassen, ist es schwierig zu gewährleisten, dass die einzelnen Komponenten gemäß den branchenüblichen Best Practices bereitgestellt werden. Validated Patterns schließen diese Lücke mit einsatzbereiten, intensiv getesteten Deployment-Patterns für verschiedene Use Cases. Dadurch entfällt die Notwendigkeit, komplexe, sicherheitsorientierte Architekturen von Grund auf neu zu entwickeln.
Die unbequeme Wahrheit über das Schwachstellenmanagement
2025 wurden über 40.000 neue CVEs veröffentlicht. Das sind mehr als 100 pro Tag. Heute beschleunigt die KI-gestützte Generierung von Exploits die Zeit von der Offenlegung von Schwachstellen bis zur aktiven Ausnutzung in der Praxis drastisch. „Auf der Suche nach dem heiligen Gral“ zeigt, wie das Streben nach einem perfekten Score von null CVEs manchmal kontraproduktiv sein kann, wenn es von tiefergehenden Defense in Depth-Strategien ablenkt. Eine Komponente, die um 9.00 Uhr „bereinigt“ ist, weist möglicherweise bis 17.00 Uhr eine neu entdeckte Schwachstelle auf. Selbst wenn Sie null bekannte CVEs erreichen, bleiben unbekannte Schwachstellen erhalten.
Die Patching-Logik (die fälschliche Annahme, dass Sicherheit nur ein Zahlenspiel ist, bei dem weniger CVEs ein geringeres Risiko bedeuten) geht für Unternehmensumgebungen mit Hunderten von containerisierten Workloads einfach nicht auf. Im Gegensatz zu traditionellen monolithischen Architekturen, die auf einem einzigen Betriebssystem ausgeführt werden, bringen verteilte Container-Umgebungen eine deutlich höhere Komplexität mit sich. Unzählige Microservices und Netzwerk-Touchpoints bieten weitaus mehr Konfigurationsoptionen, bei denen etwas schiefgehen und unbeabsichtigt eine Sicherheitslücke entstehen kann. Der Versuch, absolut alles sofort zu beheben, ist eine Sisyphusarbeit. Sie steht im Konflikt mit einer modernen, risikobasierten Sicherheitsstrategie. Dabei wird eine grundlegende Wahrheit ignoriert: Egal wie aggressiv Sie versuchen, Updates anzuwenden, es wird immer eine Verzögerung geben.
Was tun Sie also in der Zeit zwischen der Offenlegung von Schwachstellen und der Patch-Bereitstellung? Die Antwort liegt in einem Sicherheitsprinzip, das es seit Jahren gibt, das aber heute wichtiger ist als je zuvor: Zero Trust-Architektur.
Was Zero Trust für Ihren Red Hat OpenShift Cluster bedeutet
Zero Trust ist kein Produkt, das Sie installieren. Es handelt sich um eine Architekturphilosophie, die davon ausgeht, dass eine Sicherheitsverletzung bereits stattgefunden hat. Sie schreibt vor, dass jede Interaktion explizit verifiziert und autorisiert werden muss. Laut NIST SP 800-207 bedeutet Zero Trust, das implizite Vertrauen in Ressourcen – wie Assets, Anwendungen oder Nutzerkonten – zu entfernen, das ausschließlich auf deren physischem Standort oder Netzwerkstandort basiert. Authentifizierung und Autorisierung sind getrennte Funktionen, die ausgeführt werden, bevor eine Sitzung zu einer Unternehmensressource aufgebaut wird.
Die Implementierung von Zero Trust in Kubernetes und Red Hat OpenShift erfordert einen mehrschichtigen Ansatz, der Workload-Identität, Secret-Management und Runtime-Zugriffskontrolle umfasst. Speziell im Netzwerkbereich besteht eine der wichtigsten Auswirkungen dieser Philosophie darin, über die standardmäßige flache Netzwerkkonfiguration hinauszugehen, in der alle Pods ungehindert kommunizieren können. Standardmäßig wendet Kubernetes keine internen Netzwerkbeschränkungen an. Dies entspricht einem Gebäude, in dem alle Innentüren unverschlossen bleiben, nur weil das Gebäude über ein Haupttor verfügt (wie einen Cluster Ingress Controller, ein API Gateway oder eine Perimeter Firewall). Sich allein auf diesen Perimeterschutz zu verlassen, reicht für moderne cloudnative Umgebungen jedoch grundsätzlich nicht aus.
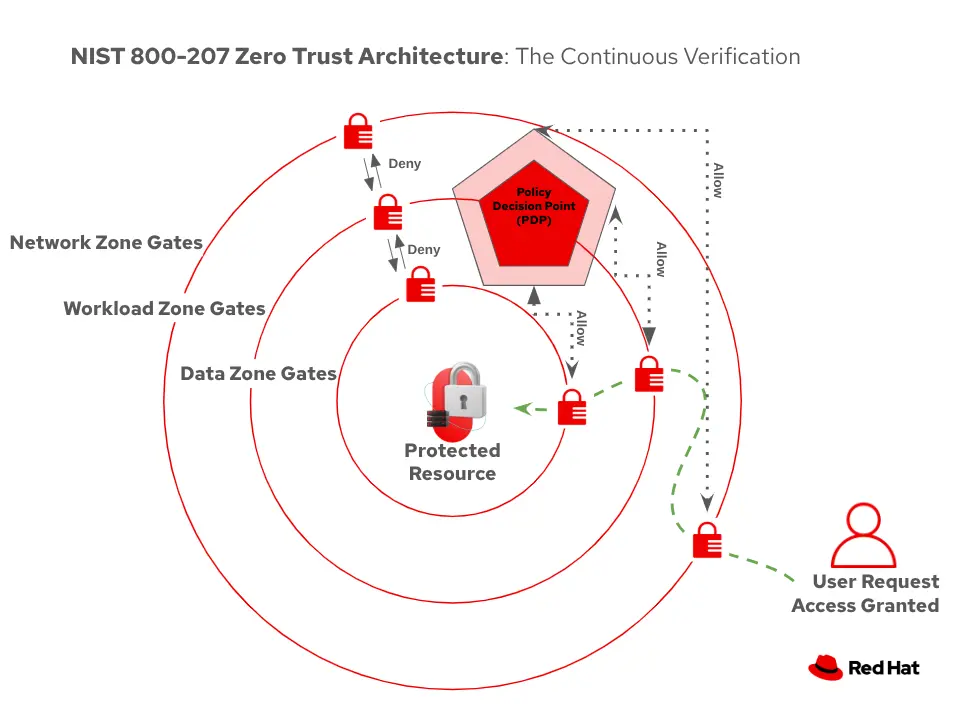
Gemäß dem Zero Trust-Modell gehen wir davon aus, dass bereits eine Sicherheitsverletzung stattgefunden hat und sich böswillige Akteure bereits in Ihrer Umgebung befinden. Dabei kann es sich um externe Angreifer handeln, die den Perimeter umgangen haben, um eine kompromittierte Komponente der Lieferkette oder um böswillige interne Bedrohungen. Durch die Implementierung von Netzwerkressourcenbeschränkungen für Kubernetes erstellen wir eine standardmäßige Ablehnung von Netzwerkverbindungen mit expliziter Authentifizierung und Autorisierung für die Nutzung des Netzwerks und den Zugriff auf andere verbundene Ressourcen (Abbildung 1).
Von der Theorie zur Praxis: Das Layered Zero Trust Validated Pattern (ZTVP)
Um diese Best Practices in die Realität umzusetzen, nutzen wir Layered Zero Trust Validated Pattern (ZTVP). Ein Validated Pattern verkörpert Best Practices für Infrastructure as Code und GitOps-Automatisierung. Dadurch wird die Einrichtungszeit für komplexe Red Hat OpenShift-Deployments, die auf Sicherheit und Skalierbarkeit ausgelegt sind, drastisch reduziert. In den letzten 3 Monaten hat das ZTVP-Projekt bedeutende Fortschritte gemacht und die Akkreditierung Tested Tier erreicht.
Das Pattern vereint mehrere Komponenten in einer zusammenhängenden, mit GitOps bereitgestellten Zero Trust-Architektur:
- Zero Trust Workload Identity Manager: Stellt Workloads kurzlebige, kryptografische Identitäten bereit, die auf dem Projekt SPIFFE/SPIRE basieren.
- HashiCorp Vault: Speichert sensible Assets und Cluster-Secrets sicherheitsorientiert und ist für die JWT-Authentifizierung in ZTWIM integriert.
- Red Hat build of Keycloak: Verwaltet die Benutzerauthentifizierung und die föderierte Identität.
- Red Hat Advanced Cluster Security for Kubernetes: Fungiert als intelligentes Sicherheitszentrum und bietet einheitliches Multi Cluster-Monitoring, proaktive Admission Control, Echtzeit-Erkennung von Verhaltensanomalien und – in unserem Beispiel entscheidend – einen Network Policy Analyzer.
Netzwerkrichtlinien: Die letzte Verteidigungslinie
Obwohl Netzwerkrichtlinien oft als Grundlage für Zero Trust diskutiert werden, sind sie an sich kein Prinzip. Stattdessen sind sie ein proaktiver Architekturmechanismus, um die gewünschten Ergebnisse eines Zero Trust-Modells durchzusetzen. Red Hat beschreibt 4 Kernprinzipien von Zero Trust, und gut konzipierte Netzwerkrichtlinien unterstützen jedes einzelne davon aktiv:
- Mikrosegmentierung: Durch die Steuerung des Datenverkehrs auf der Ebene einzelner Pods unterteilen Netzwerkrichtlinien den Cluster von Natur aus in granulare, sicherheitsoptimierte Segmente.
- Zugriff nach dem Least Privilege-Prinzip: Ein Default-Deny-Ansatz stellt sicher, dass Workloads nur genau die Netzwerkberechtigungen erhalten, die sie für ihre Funktion unbedingt benötigen.
- Deperimeterisierung: Sicherheitskontrollen werden weg vom „Haupttor“ des Clusters direkt auf die Workloads selbst verlagert.
- Annahme einer Sicherheitsverletzung: Durch die proaktive Eliminierung lateraler Angriffspfade sind bereits strikte Ingress- und Egress-Regeln vorhanden, um den Schadensradius im Falle einer Kompromittierung zu begrenzen.
Ein äußerst wichtiger Aspekt von Netzwerkrichtlinien für Kubernetes ist zudem, dass sie auf einer separaten Control Plane existieren als die Anwendungs-Pods, die sie schützen. Das bedeutet: Selbst wenn ein Angreifer erfolgreich in einen Container eindringt und erweiterte Berechtigungen erhält, kann er die einschränkenden Netzwerkgrenzen nicht einfach neu definieren oder umgehen. Um die allgemeine Sicherheitslage der internen Umgebung zu verbessern und diese Prinzipien in die Praxis umzusetzen, müssen wir feingranulare Netzwerkrichtlinien definieren, die sowohl den Ingress- als auch den Egress-Datenverkehr auf Pod-Ebene regeln:
- Ingress-Richtlinien: Diese steuern den eingehenden Datenverkehr zu einem Pod und setzen die Regel durch, dass ein Dienst nur Verbindungen von explizit autorisierten Quellen akzeptiert. Wenn ein benachbarter Pod im Cluster kompromittiert wird, verhindert eine strikte Ingress-Richtlinie, dass der Angreifer lateral auf Ihre sensiblen Workloads zugreift.
- Egress-Richtlinien: Diese steuern den ausgehenden Datenverkehr von einem Pod. Ihr Ziel ist es, den Zugriff eines Pods auf externe oder interne Ressourcen strikt zu begrenzen. Wird ein Pod kompromittiert, neutralisieren Egress-Richtlinien die Fähigkeit eines Angreifers, Daten zu exfiltrieren, das Netzwerk auszukundschaften oder bösartige Payloads von externen Command-and-Control-Servern herunterzuladen.
Die Default-Deny-Basis
Spezifische Ingress- und Egress-Regeln zu definieren ist zwar entscheidend, aber sich allein darauf zu verlassen, lässt eine gefährliche Lücke für menschliche Fehler und Täuschungsangriffe. Standardmäßig arbeitet Kubernetes nach einem Allow-All-Modell. Das bedeutet, dass jeder Datenverkehr zulässig ist, der nicht explizit eingeschränkt wurde. Wenn eine entwickelnde Person vergisst, eine Richtlinie anzuwenden, bleibt dieser Pod weit offen. Das Risiko geht jedoch über bloßes Versehen hinaus. Bei einem Angriff auf die Lieferkette könnte jemand im Entwicklungsteam unwissentlich dazu verleitet werden, eine kompromittierte Drittanbieterkomponente bereitzustellen, ohne die versteckte bösartige Payload oder deren Folgen zu bemerken.
Eine Default-Deny-Richtlinie kehrt dieses Paradigma von einer Blocklist zu einer Allowlist um. Der Kern von Zero Trust verlangt, dass jede einzelne Interaktion explizit autorisiert werden muss. Folglich darf absolut kein Zugriff implizit erfolgen. Indem der gesamte Datenverkehr von vornherein blockiert wird, schafft ein Default-Deny-Ansatz eine Umgebung, in der ein versehentliches Versäumnis (oder ein getarnter bösartiger Container) dazu führt, dass die Verbindung sicher blockiert wird. Dies zwingt Sie dazu, den Zugriff explizit zu gewähren. So wird aus einer potenziell unbemerkten, katastrophalen Sicherheitsverletzung ein auffälliger, leicht zu behebender Deployment-Fehler.
Der Ansatz beginnt mit einer einfachen, aber wirkungsvollen Regel: Den gesamten Datenverkehr standardmäßig ablehnen. Jeder Namespace erhält eine Default-Deny-NetworkPolicy, die den gesamten Ingress- und Egress-Datenverkehr für jeden Pod blockiert, sofern keine explizite Erlaubnis vorliegt.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-in-namespace
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
Sobald eine NetworkPolicy einen Pod in einem Namespace adressiert, hat dieser keinen uneingeschränkten Zugriff mehr. Die Definition einer Richtlinie, die den Zugriff standardmäßig blockiert, entspricht dem Zero Trust-Prinzip der standardmäßigen Ablehnung.
Warum dies wichtig ist, wenn Sie nicht patchen können
Stellen Sie sich ein Unternehmensszenario vor, das an die Log4j-Krise oder neuere Framework-Schwachstellen wie React2Shell (CVE-2025-55182) erinnert:
- Eine kritische Schwachstelle für Remote Code Execution (RCE) wird plötzlich in einer weit verbreiteten Library offengelegt, die Ihre Anwendung nutzt.
- Die Schwachstelle ermöglicht die vollständige Übernahme des Servers, wenn ein Angreifer eine speziell präparierte Anfrage an den betroffenen Dienst sendet.
- Da die Library tief in ihren Abhängigkeiten verwurzelt ist, kann ein validierter Patch erst nach mehreren Tagen getestet und produktiv eingesetzt werden.
Die Auswirkungen auf eine Organisation mit Zero Trust-Netzwerkrichtlinien sind minimal:
- Ein Angreifer, der einen Pod kompromittiert, kann den anfälligen Dienst über alle Namespaces hinweg problemlos erreichen (keine laterale Isolation).
- Mit ZTVP-Netzwerkrichtlinien: Der Angreifer kann den Dienst nicht aus einem anderen Namespace erreichen (Namespace-Isolierung).
- Ein Angreifer kann eine Verbindung zu jedem exponierten Port des Dienstes herstellen, einschließlich kritischer Ports oder Management-Ports (keine Filterung auf Portebene).
- Mit ZTVP-Netzwerkrichtlinien: Der Angreifer kann keine Verbindung zu Ports herstellen, die nicht explizit erlaubt sind (Filterung auf Portebene).
- Ein Angreifer kann ungehindert ausgehende Verbindungen herstellen, um Daten zu exfiltrieren oder Command-and-Control-Kanäle (C2) aufzubauen (keine Egress-Beschränkungen).
- Mit ZTVP-Netzwerkrichtlinien: Der Angreifer kann keine Daten an externe Endpunkte exfiltrieren (Egress-Beschränkungen).
Demonstration: Eliminierung des Angriffspfads
Wir haben ein Demonstrationsvideo erstellt, in dem wir zeigen, wie korrekt implementierte Netzwerkrichtlinien Angriffspfade aktiv eliminieren. Zuerst sehen wir eine Umgebung ohne Default-Deny-Ansatz. Hier kann ein Angreifer eine Schwachstelle in der Lieferkette nutzen, um das Netzwerk umfassend auszukundschaften und nach weiteren ungepatchten Komponenten zu suchen. Dann sehen wir, dass sich die Situation komplett ändert, sobald strikte Netzwerkrichtlinien angewendet werden.
Selbst wenn ein Angreifer erfolgreich in einen Pod eindringt, wird seine Fähigkeit, das Netzwerk zu scannen oder sich lateral zu bewegen, vollständig neutralisiert. Die Richtlinien beschränken den Zugriff auf den kompromittierten Container. Dies grenzt die Bedrohung effektiv ein und verschafft Ihnen die nötige Zeit für Korrekturmaßnahmen. Auch wenn sie nicht die einzige Sicherheitsmaßnahme in einer umfassenden Strategie sind, ist die Festlegung strikter Netzwerkgrenzen der wohl beste Ausgangspunkt für Ihre letzte Verteidigungslinie.
Diese Demonstration zeigt, wie Netzwerkrichtlinien einen Angriff auf den kompromittierten Container beschränken, die Bedrohung effektiv eingrenzen und Ihnen Zeit für Korrekturmaßnahmen verschaffen.
Das Gesamtbild: Defense in Depth
Netzwerkrichtlinien sind nur eine Ebene einer umfassenden Strategie. Layered Zero Trust Validated Pattern kombiniert diese Richtlinien mit SPIFFE/SPIRE-Workload-Identitäten (unter Verwendung von Zero Trust Workload Identity Manager), von Vault verwalteten Secrets, zentraler Authentifizierung über einen Identity Provider (IdP) wie Red Hat build of Keycloak und Runtime-Monitoring mit Red Hat Advanced Cluster Security for Kubernetes. Netzwerkrichtlinien vervollständigen das Bild, indem sie sicherstellen, dass die Netzwerkschicht für eine Eingrenzung sorgt, selbst wenn Identitätsprüfung, Secrets oder Anwendungssicherheit versagen.
Aber woher wissen Sie, ob Ihre Netzwerkrichtlinien tatsächlich funktionieren oder ob ein kompromittierter Container wiederholt versucht, Ihre internen Grenzen zu überwinden? Was passiert, wenn ein Zero-Day-Exploit eine blockierte Verbindung auslöst?
In dieser Blog-Serie beantworten wir diese kritischen Fragen und untersuchen, wie Layered Zero Trust Validated Pattern Zero-Trust-Sicherheitspraktiken implementiert. Das erwartet Sie im weiteren Verlauf:
- Aktive Abwehr mit Red Hat Advanced Cluster Security for Kubernetes: Implementierung von tiefgreifendem Runtime-Monitoring, automatisiertem Scannen von Netzwerkrichtlinien und Echtzeit-Alarmierung als Ihr zentrales Sicherheitszentrum.
- Identität und Secrets: Sichere Verwaltung von Workload-Identitäten mit Zero Trust Workload Identity Manager und Vault-Integration.
- Lieferkette: Vollständige Absicherung Ihrer Softwarelieferkette durch Erzwingen von Inhaltssignaturen und Verifizieren von Pipeline-Aufgaben, um sicherzustellen, dass nur vertrauenswürdiger Code Ihren Cluster erreicht.
Möchten Sie es in Aktion sehen? Sie müssen nicht auf den nächsten Artikel warten, um loszulegen. Sehen Sie sich Layered Zero Trust Validated Pattern an, um die Architektur zu erkunden, und testen Sie die Demo zu den Netzwerkrichtlinien selbst.
Referenzen
- NIST SP 800-207: Zero Trust-Architektur
- NIST SP 800-207A: Zero Trust für cloudnative Anwendungen
- CISA: Leitfaden zur Zero Trust-Mikrosegmentierung
- Layered Zero Trust Validated Pattern
- Validated Patterns
- Auf der Suche nach dem heiligen Gral: Warum das Hummingbird-Projekt von Red Hat auf nahezu null CVEs hinarbeitet
- CVE-Metriken
Produkttest
Red Hat OpenShift Container Platform | Testversion
Über den Autor
Przemysław “Rogue” Roguski is a Security Architect at Red Hat who specializes in shift-left security initiatives focusing on embedding security best practices and attestation into the earliest stages of the SDLC. He contributes security analysis work on Red Hat OpenShift and other OpenShift-related products. He also designs security solutions and processes across Red Hat.
He contributes to the security ecosystem as a member of the CISA SBOM/VEX working groups, an OASIS OpenEoX Technical Committee member and a key contributor to the CWE program.
Ähnliche Einträge
Die neue Währung für geschäftliche Agilität im KI-Zeitalter
Präzise Sicherheit mit agentischer KI, Red Hat OpenShift und NVIDIA
Can Compliance Be A Piece Of Cake? | Compiler
Scaling with Orchestrators | Compiler
Nach Thema durchsuchen

Automatisierung
Das Neueste zum Thema IT-Automatisierung für Technologien, Teams und Umgebungen

Künstliche Intelligenz
Erfahren Sie das Neueste von den Plattformen, die es Kunden ermöglichen, KI-Workloads beliebig auszuführen

Open Hybrid Cloud
Erfahren Sie, wie wir eine flexiblere Zukunft mit Hybrid Clouds schaffen.

Sicherheit
Erfahren Sie, wie wir Risiken in verschiedenen Umgebungen und Technologien reduzieren

Edge Computing
Erfahren Sie das Neueste von den Plattformen, die die Operations am Edge vereinfachen

Infrastruktur
Erfahren Sie das Neueste von der weltweit führenden Linux-Plattform für Unternehmen

Anwendungen
Entdecken Sie unsere Lösungen für komplexe Herausforderungen bei Anwendungen

Virtualisierung
Erfahren Sie das Neueste über die Virtualisierung von Workloads in Cloud- oder On-Premise-Umgebungen
