Wenn Sie Large Language Models (LLMs) verwenden oder darauf aufbauen, ist es wichtig zu verstehen, wie Inferenz und Key-Value-(KV-)Cache funktionieren. Denn ganz gleich, ob Sie mit Coding-Agenten, Retrieval-Augmented Generation (RAG) oder Fine Tuning arbeiten: Inferenz geschieht jedes Mal, wenn Sie eine Anfrage an ein Modell senden und eine Antwort erhalten (und hier fließt das meiste Geld hin).
Während das Training nur einmal stattfindet, erfolgt die Inferenz jedes Mal, wenn Nutzende einen Prompt senden. Sehen wir uns also an, wie sie funktioniert, was der KV-Cache ist und welche Optimierungen die meisten Teams nutzen, um Infrastrukturkosten zu senken und die Latenz zu verringern.
Inferenz ist ein Stack, keine Modelldatei
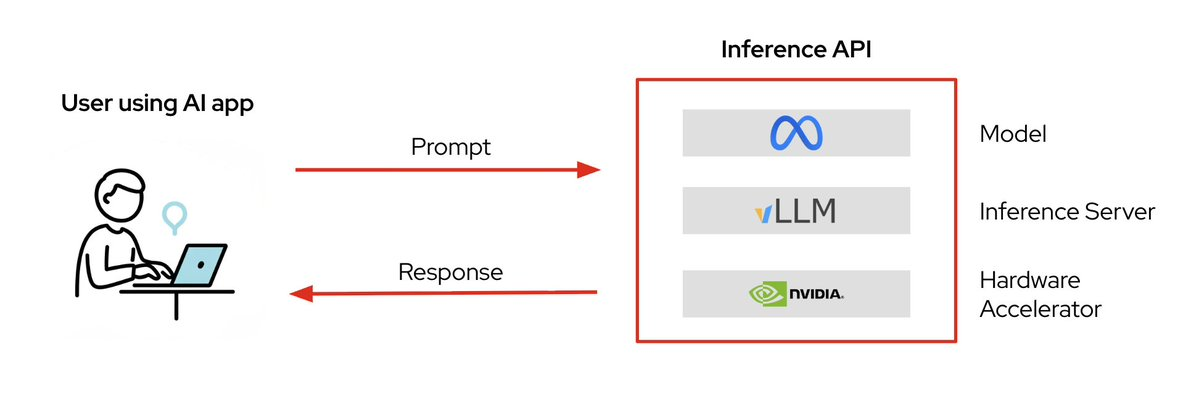
Abbildung 1: Für die Bereitstellung eines Modells müssen 3 Komponenten zusammenarbeiten: die Gewichtungen, ein Inferenzserver und die zugrunde liegende Hardware.
Ein Modell auf Ihrem Rechner (oder bei HuggingFace) nutzt bisher noch niemandem. Damit Inferenz möglich ist, müssen 3 Komponenten zusammenarbeiten:
- Modellgewichtungen: Die Datei(en) mit den Milliarden erlernten Parametern: Kimi, GLM, Qwen oder was auch immer Sie ausgewählt haben.
- Inferenzserver: Software wie vLLM, die das Modell lädt, eingehende Anfragen verwaltet und die Optimierungen übernimmt, die wir gleich behandeln.
- Hardwarebeschleuniger: In der Regel eine GPU, die den Großteil der numerischen Berechnungen ausführt.
Sie können die mittlere Ebene überspringen und ein Modell mit PyTorch direkt auf einer GPU ausführen. Das funktioniert problemlos für ein Notebook oder einzelne Nutzende. Sobald Sie jedoch viele Personen gleichzeitig bedienen müssen, sorgt der Inferenzserver dafür, dass die GPU im Produktionsmaßstab nutzbar wird (vergleichbar damit, ob Sie eine HTML-Datei lokal öffnen oder über einen Apache HTTP Server bereitstellen).
Modelle generieren jeweils 1 Token
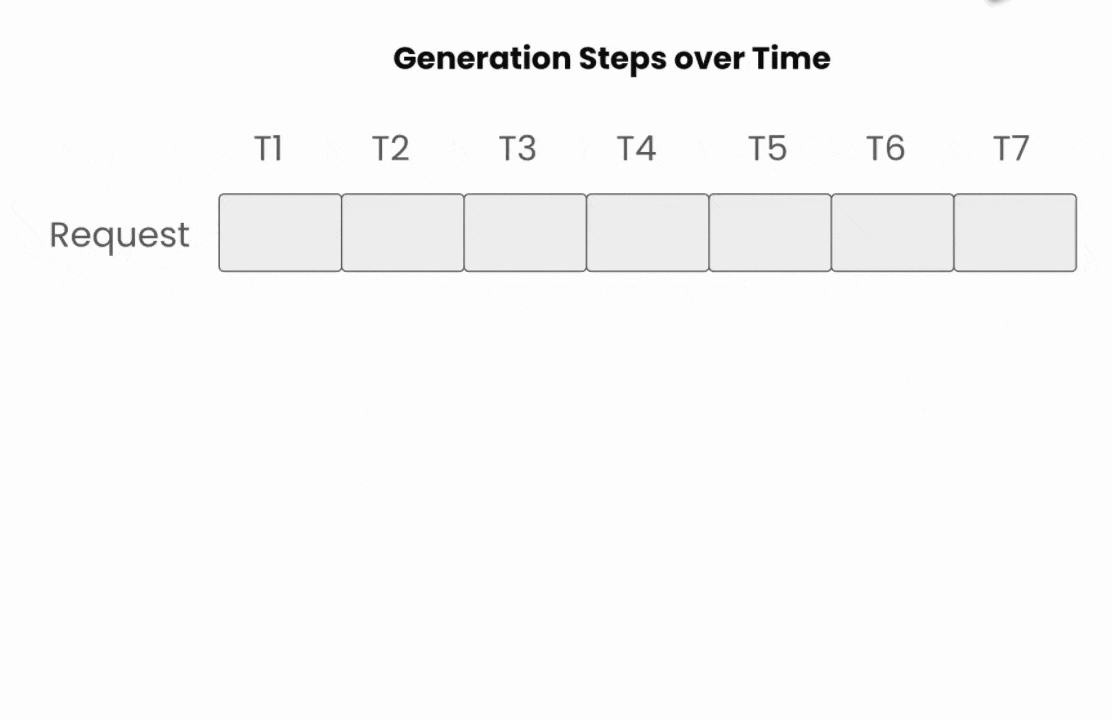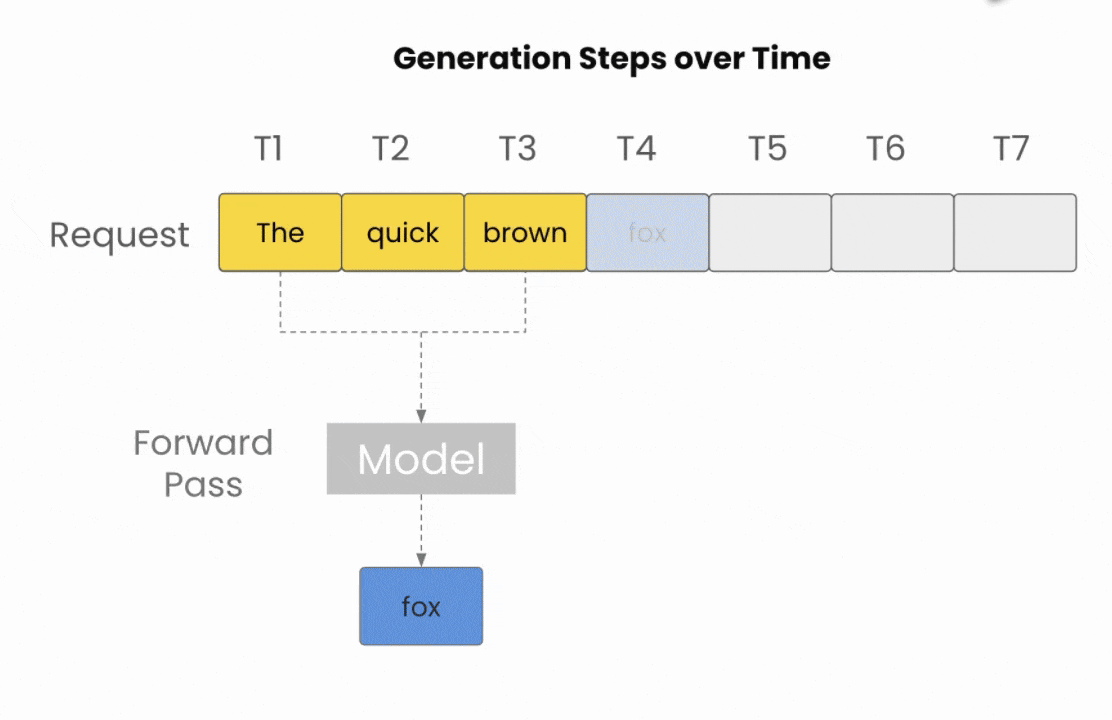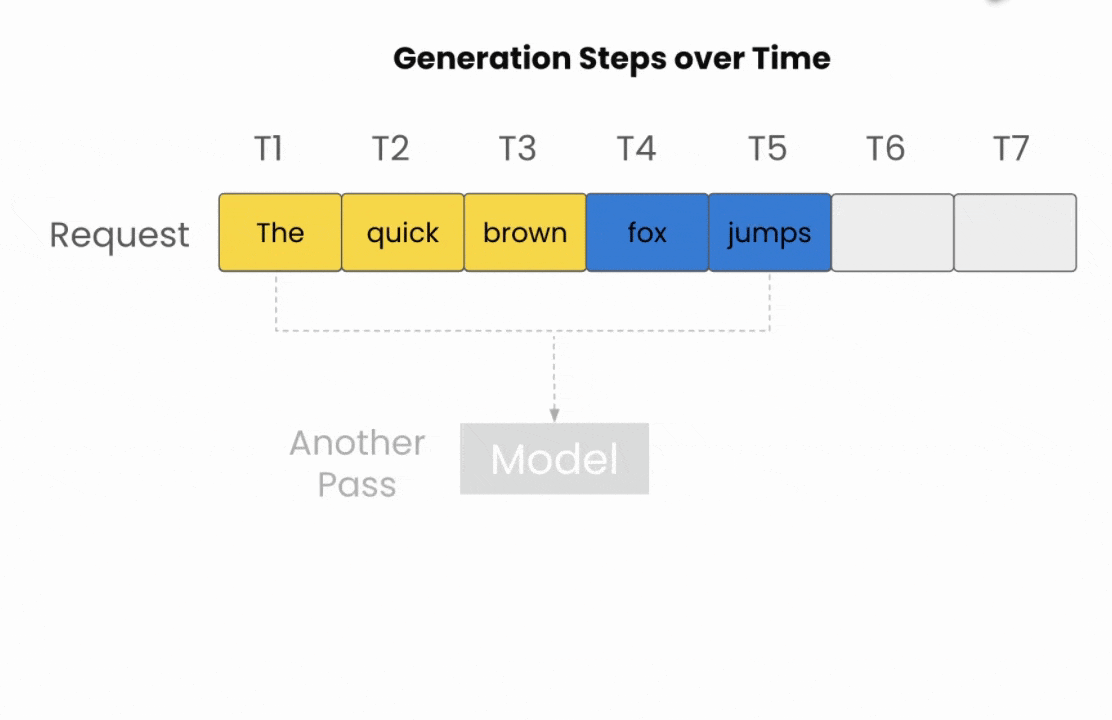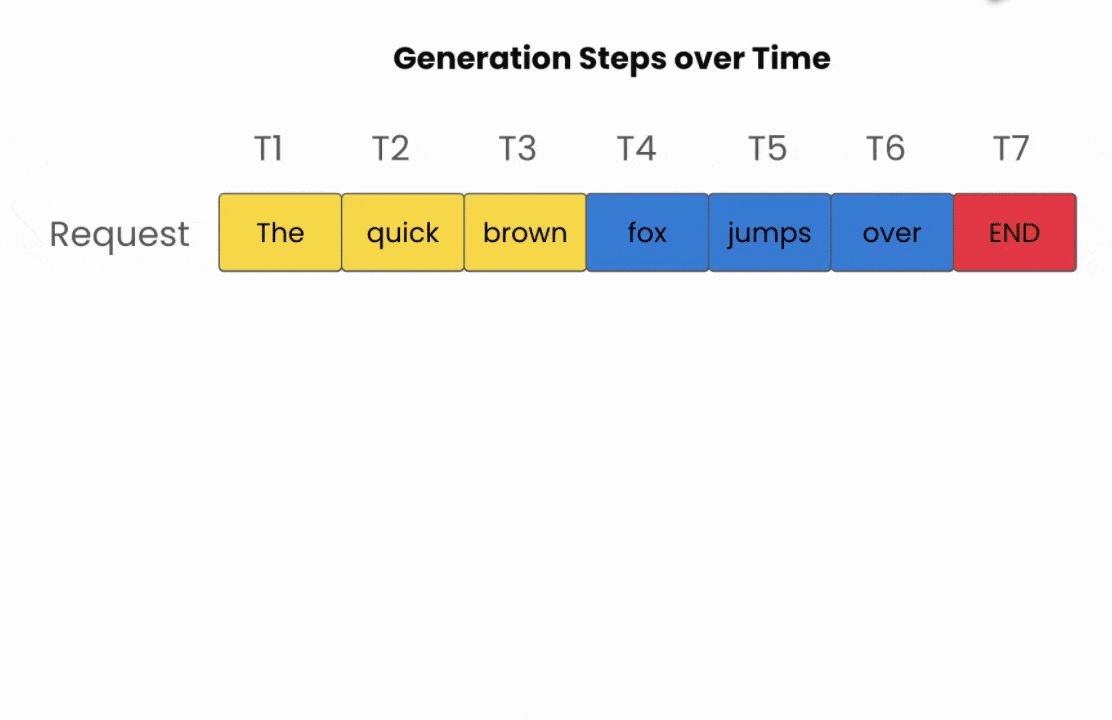
Abbildung 2: Jeder Vorwärtsdurchlauf erzeugt genau 1 neues Token, das dann wieder eingespeist wird, um das nächste zu erzeugen.
LLMs erzeugen keine langen Antworten auf einmal, sondern jeweils 1 Token. Jedes neue Token hängt von allen vorherigen Token ab (einschließlich derer, die das Modell gerade selbst generiert hat).
Beginnen wir also mit einem Beispiel-Prompt: „The quick brown“
- Das Modell prognostiziert „fox“ → dieses wird angehängt
- „The quick brown fox“ → es prognostiziert „jumps“ → angehängt
- Und so weiter, bis das Modell einen speziellen End-of-Sequence-Token ausgibt.
Das ist autoregressive Generierung. Was oft unterschätzt wird: Jedes Token in einer Antwort erfordert einen vollständigen Durchlauf durch das Modell. Eine Antwort mit 500 Token bedeutet, dass das Modell 500-mal ausgeführt wird. Hier sehen Sie, wie der Rechenaufwand steigen kann.
Warum der KV-Cache existiert
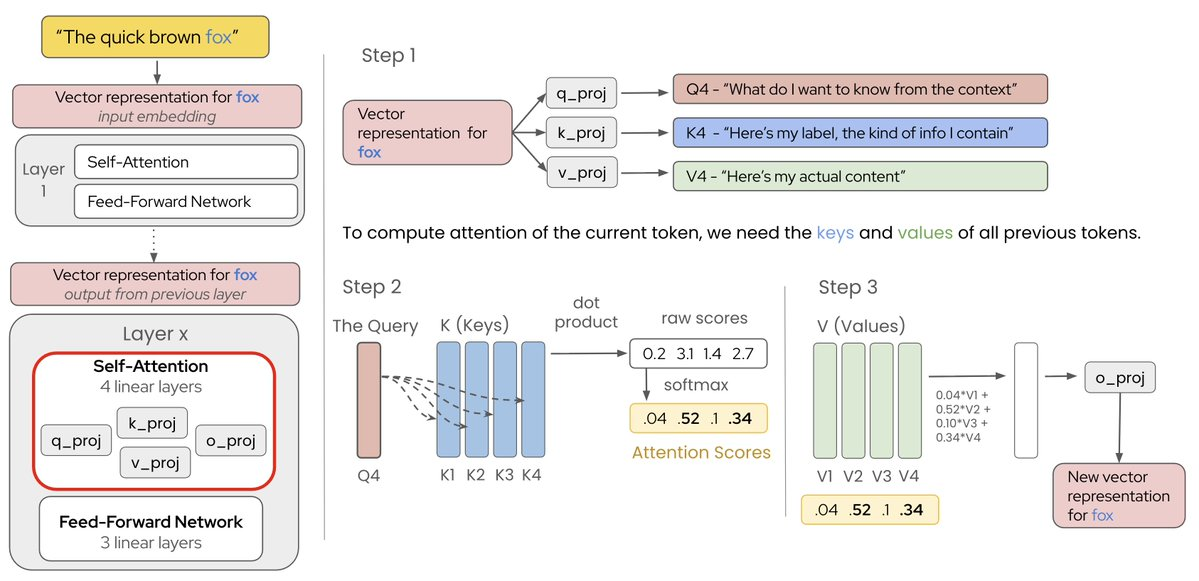
Abbildung 3: Jedes Token durchläuft den Attention-Block jeder Schicht und vergleicht seine Abfrage mit den Schlüsseln und Werten aller vorherigen Token.
Bei jedem dieser Durchläufe werden die Token zu Embeddings (einer numerischen Darstellung), die einen Stack von Transformer-Schichten durchlaufen. Jede Schicht besitzt einen Self-Attention-Block, in dem Token einander betrachten. Hier beginnt das Speicherproblem.
Attention berechnet 3 Vektoren pro Token:
- Q, die Abfrage (Query): Was dieses Token aus dem Kontext wissen möchte
- K, der Schlüssel (Key): die Art der enthaltenen Informationen
- V, der Wert (Value): der eigentliche Inhalt
Um das nächste Token zu generieren, vergleichen Sie dessen Abfrage mit dem Schlüssel jedes bisherigen Tokens und bilden eine gewichtete Summe der Werte.
Aber! Hier ist der entscheidende Punkt: Die Abfrage wird nur für das aktuelle Token benötigt. Die Schlüssel und Werte werden für den gesamten Verlauf benötigt, ändern sich jedoch nicht. Schlüssel und Wert von Token 4 sind in Schritt 5 dieselben wie in Schritt 4.
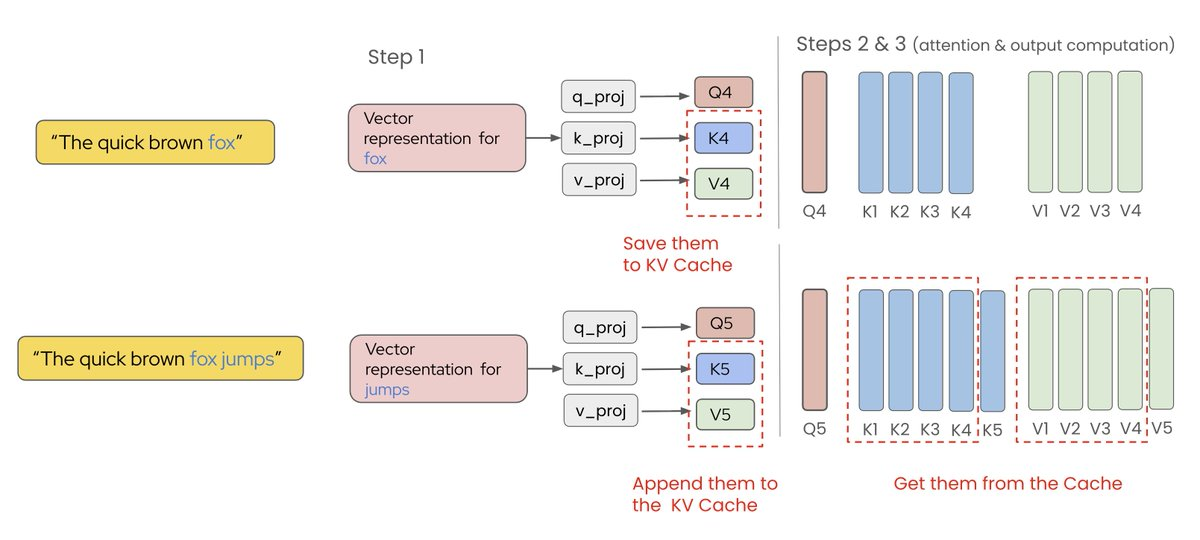
Abbildung 4: Da sich Schlüssel und Werte früherer Token nie ändern, werden sie einmal gespeichert und wiederverwendet, anstatt bei jedem Schritt neu berechnet zu werden.
Anstatt sie bei jedem Schritt neu zu berechnen, speichern wir sie im GPU-Speicher und berechnen K und V nur für das neue Token. Das ist der KV-Cache. Dies geschieht auf jeder der N Schichten des Modells, sodass sich die Einsparungen mit N multiplizieren.
Wie groß wird der KV-Cache eigentlich?
Für jedes Token müssen Schlüssel und Werte auf jeder Schicht gespeichert werden – mit mehreren parallelen Sets pro Schicht (den KV-Heads). Die Formel lautet:
2 × num_layers × num_kv_heads × head_dim × dtype_bytes
Nehmen wir als Beispiel gpt-oss-120b: 36 Schichten, 8 KV-Heads, eine Head-Dimension von 64, 2 Byte pro Wert. Das entspricht etwa 72 KB pro Token. Da gpt-oss den vollständigen Verlauf jedoch nur auf der Hälfte seiner Schichten vorhält, liegt der tatsächliche Zuwachs eher bei 36 KB pro Token.
- 2k (ein typischer Chat-Turn): ~75 MB
- 8k (Standard-Produktionsstufe): ~300 MB
- 32k (ein langes Dokument oder eine Codebasis): ~1,2 GB
- 128k (Maximum von gpt-oss): ~4,8 GB
Und dieses Modell ist bereits darauf ausgelegt, effizient bereitgestellt zu werden. Ein dichtes 70B-Modell mit 80 Schichten und einer 128-Head-Dimension (wie Llama 3.3 70B) benötigt etwa 320 KB pro Token – das ist 9-mal mehr für dieselbe Konversation. Deshalb sind Architekturentscheidungen beim Modell sehr wichtig, um Ihre KI-Kosten unter Kontrolle zu halten.
Hierfür wird Ihr GPU-Budget aufgebraucht
Ein Modell wie gpt-oss-120b passt auf eine einzelne NVIDIA H100 80 GB GPU. Das war eine beachtliche Leistung bei der Veröffentlichung des Modells. Nach dem Laden der Gewichtungen auf die Karte verbleiben jedoch nur etwa 15 bis 20 GB Spielraum für KV-Cache und Inferenz-Overhead. Die Bereitstellung für reale Nutzende wird nun anspruchsvoll, zum Beispiel:
- Wenn Ihr Server Speicher pro Anfrage reserviert, der für den maximal erreichbaren Kontext dieser Anfrage ausgelegt ist (wie es bei älteren Ansätzen der Fall war), kostet jede Anfrage 4,8 GB – unabhängig davon, ob dieser Speicher genutzt wird oder nicht. Das sind nur 3 gleichzeitige Nutzende auf einer H100. Uff.
- Wenn Sie stattdessen nur den Speicher zuweisen, den jede Anfrage tatsächlich benötigt, kostet eine typische 8k-Anfrage 300 MB. Dieselbe Karte, dasselbe Modell, 50 oder 60 Nutzende. Das geschieht auf derselben Hardware. Der Unterschied liegt jedoch rein darin, wie der GPU-Speicher verwaltet wird – und deshalb ist dieses Thema so wichtig.
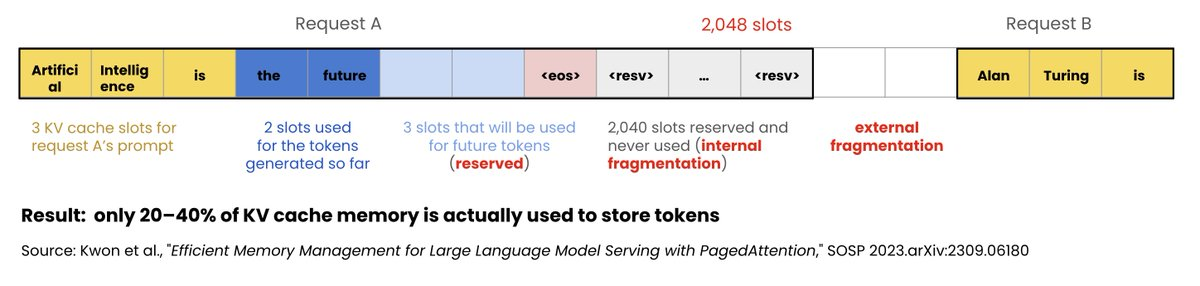
Abbildung 5: Die Speicherreservierung für die maximale Kontextlänge im ungünstigsten Fall führt dazu, dass der Großteil des KV-Cache ungenutzt bleibt.
Was unternehmen produktive Inferenzserver wie vLLM dagegen?
Hauptsächlich 3 Dinge:
1. PagedAttention
PagedAttention unterteilt den KV-Cache in kleine Blöcke fester Größe, die an beliebiger Stelle im Arbeitsspeicher liegen können. Eine Tabelle erfasst dabei, wo sich die Blöcke der einzelnen Anfragen befinden. Es wird kein Speicher für Kontext reserviert, den Sie womöglich nie nutzen. Wenn Sie bereits mit virtuellem Speicher in einem Betriebssystem gearbeitet haben, kommt Ihnen das sicher vertraut vor – genau daher stammt die Idee.
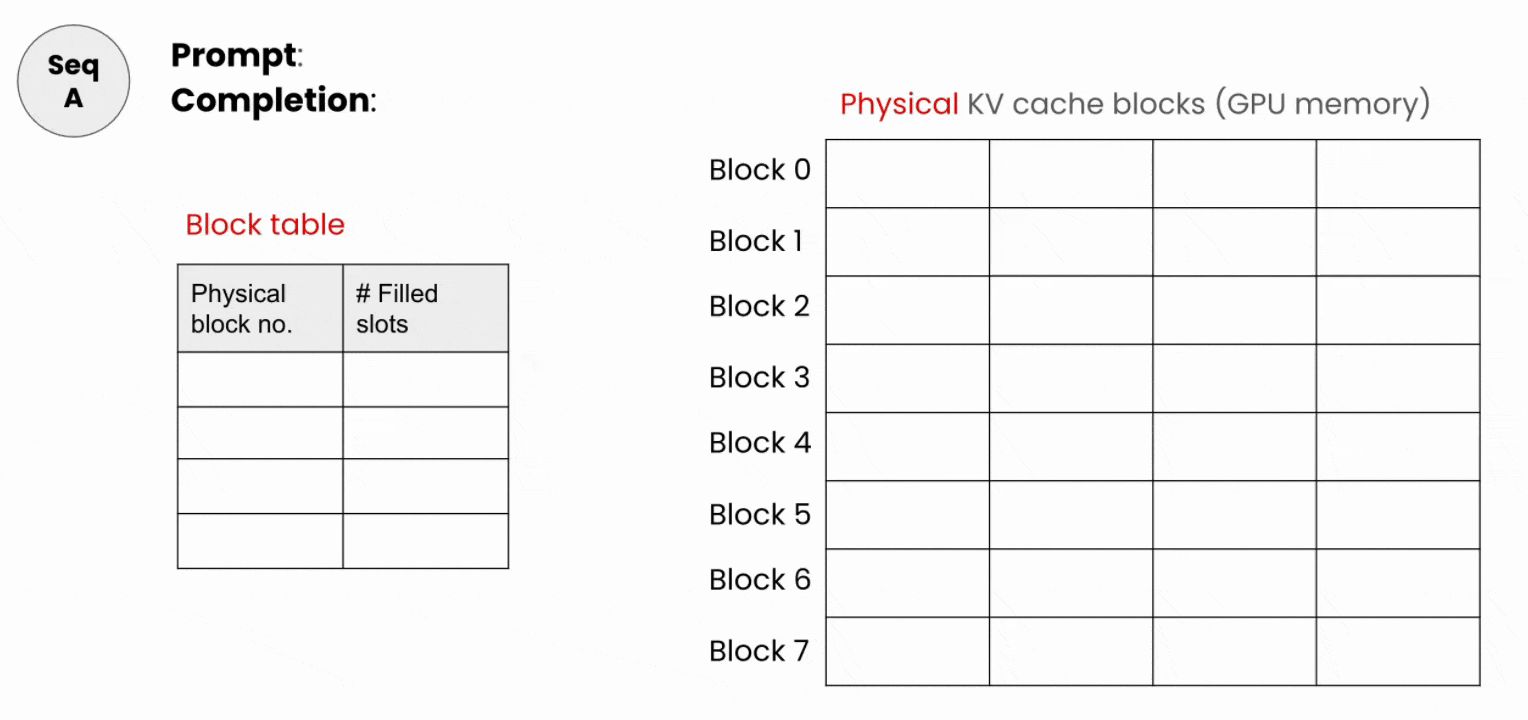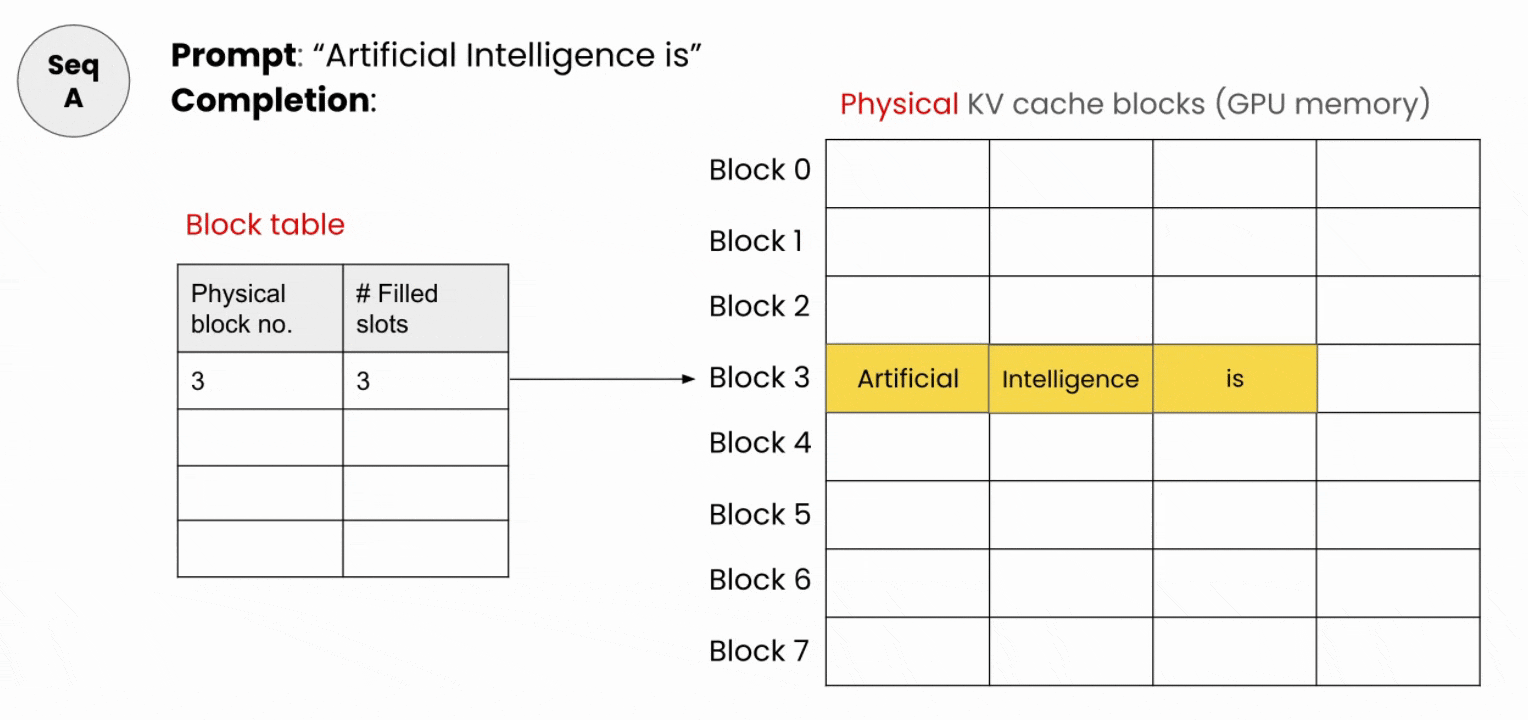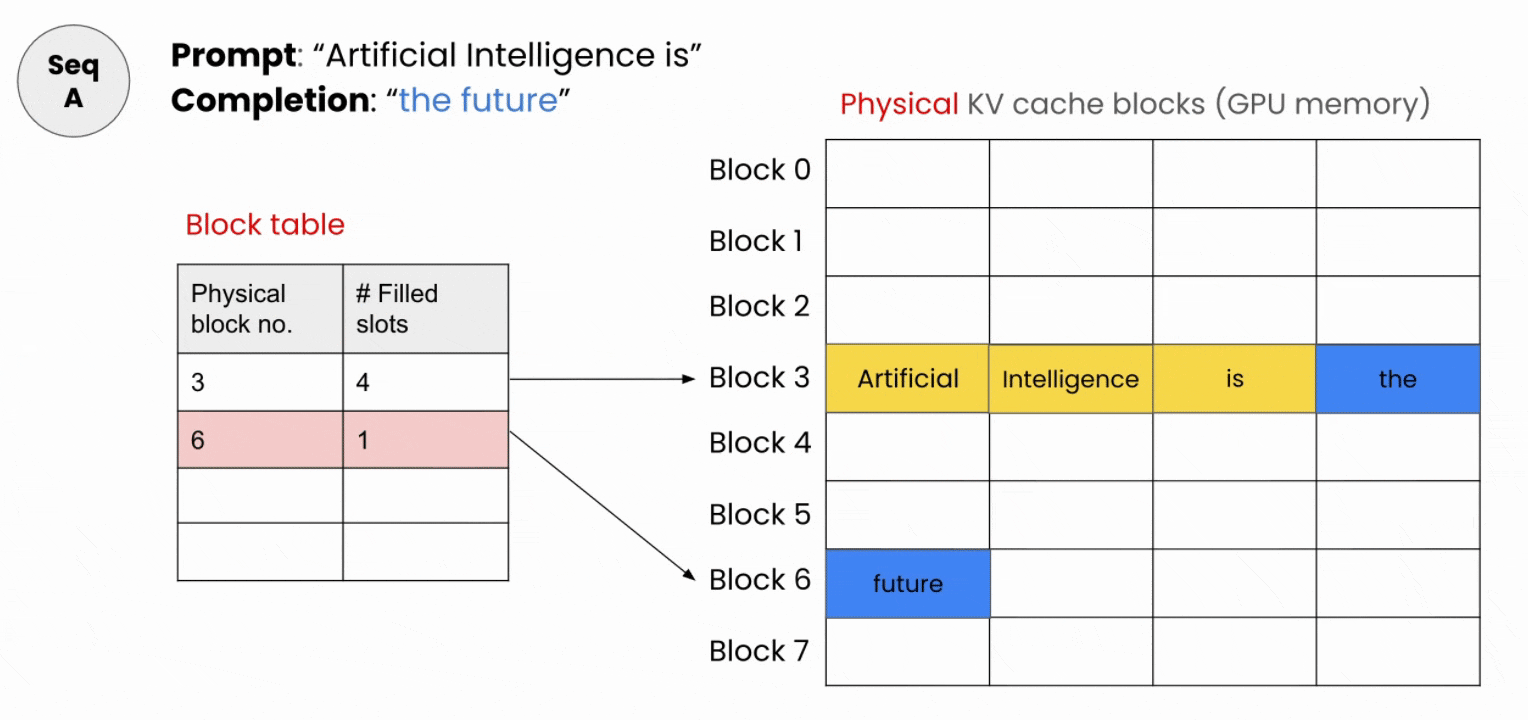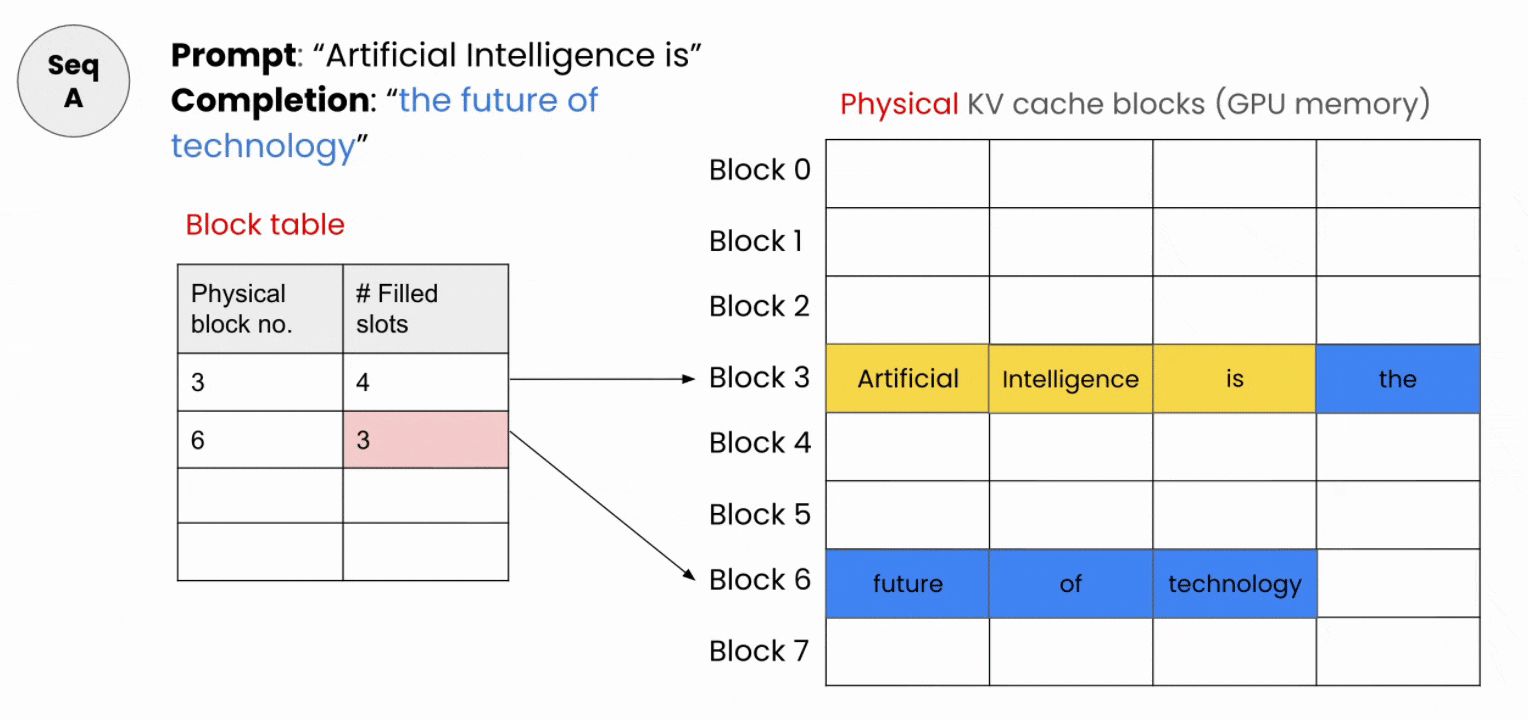
Abbildung 6: PagedAttention verteilt den Cache auf kleine Blöcke fester Größe und erfasst sie über eine Lookup-Tabelle, sodass im Voraus nichts reserviert wird.
2. Kontinuierliches Batching
Beim kontinuierlichen Batching müssen Sie nicht warten, bis ein ganzer Batch gemeinsam abgeschlossen ist. Fertige Anfragen werden sofort freigegeben und neue rücken nach, sobald Plätze frei werden. Die GPU bleibt kontinuierlich ausgelastet.
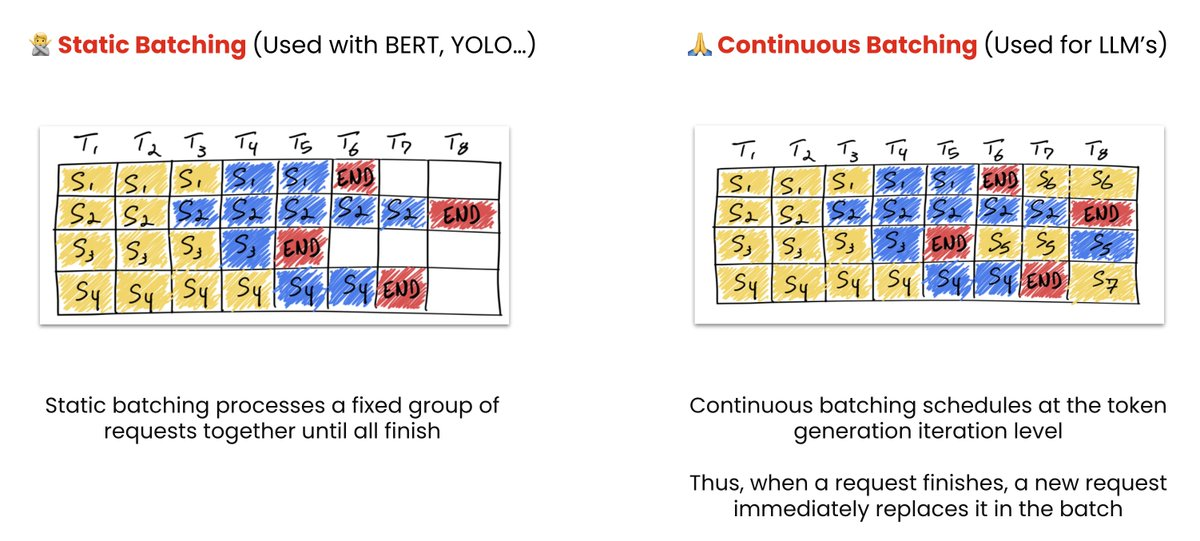
Abbildung 7: Beim statischen Batching muss jede Anfrage auf die langsamste warten, während beim kontinuierlichen Batching jeder frei gewordene Platz sofort neu belegt wird.
3. Prefix Caching
Wenn Anfragen ein Präfix gemeinsam nutzen (einen System-Prompt, ein abgerufenes Dokument oder dieselbe Repository-Datei im Kontext eines Coding-Agenten), werden die zwischengespeicherten K- und V-Werte wiederverwendet, anstatt sie neu zu berechnen.
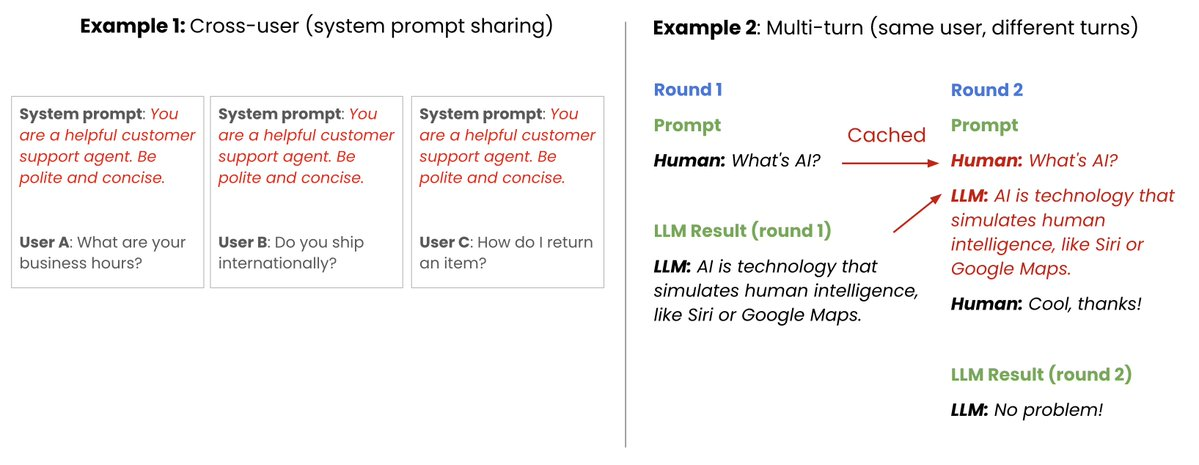
Abbildung 8: Wenn Anfragen denselben Anfangstext teilen, wird die für dieses Präfix bereits geleistete Arbeit wiederverwendet, anstatt sie neu zu berechnen.
Keine dieser Methoden verändert das Modell selbst, aber sie verändern, wie effizient Sie es ausführen.
Dann gibt es noch die Verkleinerung des Modells selbst
Quantisierung ist eine Methode zur Speicherung von Gewichtungen (oder Aktivierungen) mit geringerer Präzision, sodass sie weniger Speicherplatz beanspruchen und schneller berechnet werden können. Die meisten Modelle werden in BF16 ausgeliefert, also mit 16 Bit pro Parameter. Wenn Sie auf FP8 (8-Bit-Gleitkomma) oder INT8 (8-Bit-Ganzzahl) reduzieren, halbieren Sie den benötigten Speicher, ohne die Basisgenauigkeit zu beeinträchtigen. Reduzieren Sie auf 4-Bit, beträgt der Speicherbedarf nur noch ein Viertel. Beispielsweise erreichen alle quantisierten Modelle im Red Hat AI Hugging Face Repo wieder mehr als 99 % ihrer Basisgenauigkeit.
Das Modell gpt-oss-120b ist ein anschauliches Beispiel, da die Arbeit bereits für Sie erledigt wurde. Bei 117B Parametern in BF16 würden die Gewichtungen etwa 234 GB betragen und Sie bräuchten drei 80-GB-GPUs, um sie zu laden. OpenAI hat das Modell mit MXFP4-Quantisierung auf den MoE-Gewichtungen (Mixture of Experts) nachtrainiert. Dadurch sinkt die Größe auf unter 80 GB und passt auf eine einzelne Karte.
- BF16 (hypothetisch): ~234 GB → 3 GPUs
- MXFP4, wie ausgeliefert: Passt auf eine 80-GB-GPU
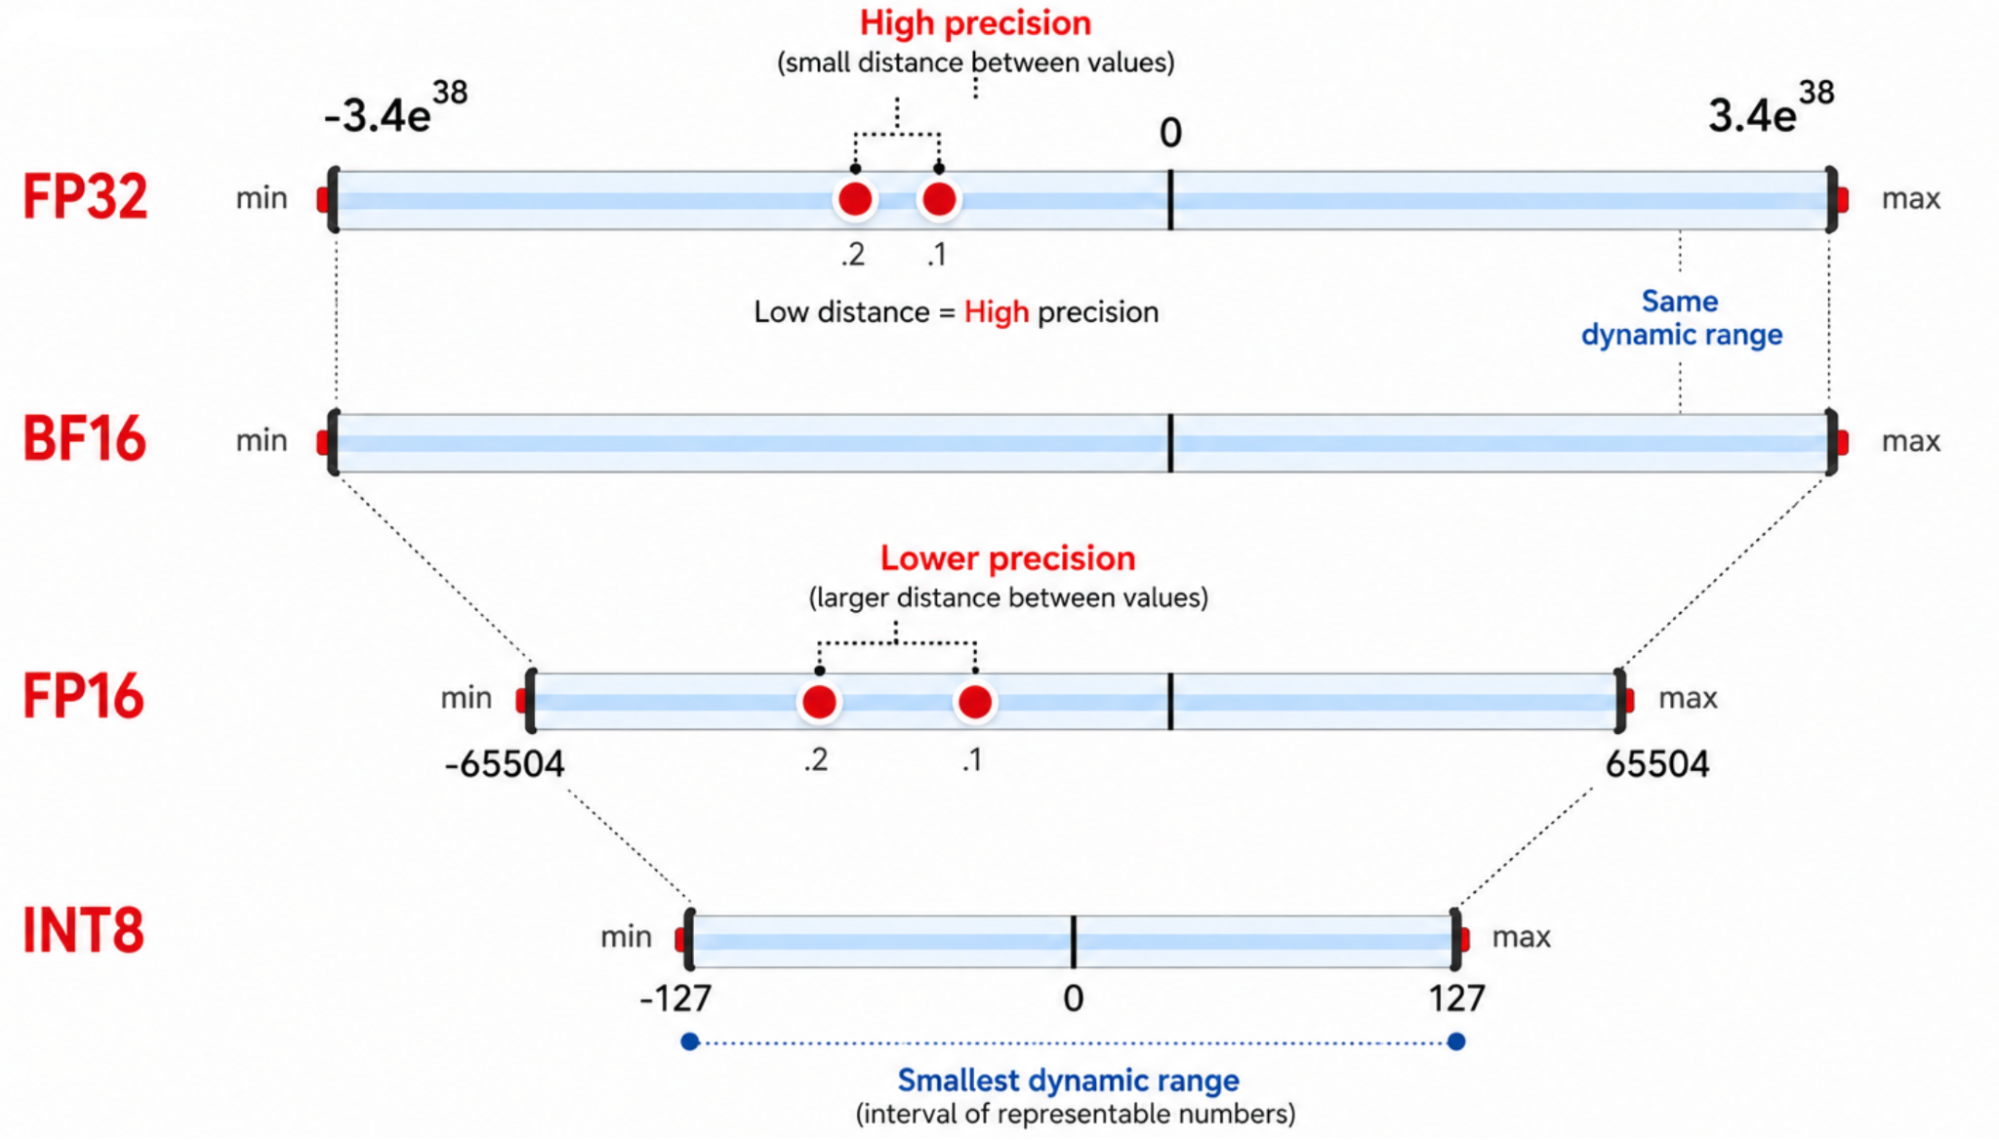
Abbildung 9: Zahlenformate mit geringerer Präzision tauschen Wertebereich und Detailgenauigkeit gegen einen deutlich geringeren Speicher-Footprint ein.
Die meisten Modelle werden nicht so ausgeliefert. In diesem Fall führen Sie die Quantisierung selbst durch oder nutzen unsere komprimierten Modelle auf HuggingFace. Letztendlich bringt die Quantisierung 2 große Vorteile. Quantisierte Gewichtungen bedeuten, dass bei jedem Vorwärtsdurchlauf weniger Daten vom High Bandwidth Memory (HBM) in das Static Random-Access Memory (SRAM) übertragen werden, was die Latenz verringert. Quantisierte Aktivierungen bedeuten, dass die Tensor Cores die Berechnungen mit geringerer Präzision durchführen und mehr Operationen pro Sekunde bewältigen, was den Durchsatz steigert. Reine Gewichtungsschemata wie W8A16 (Weight 8-Bit, Activation 16-Bit) bringen den ersten Vorteil, aber Formate wie W8A8 (Weight Int8, Activation Int8) bieten beides.
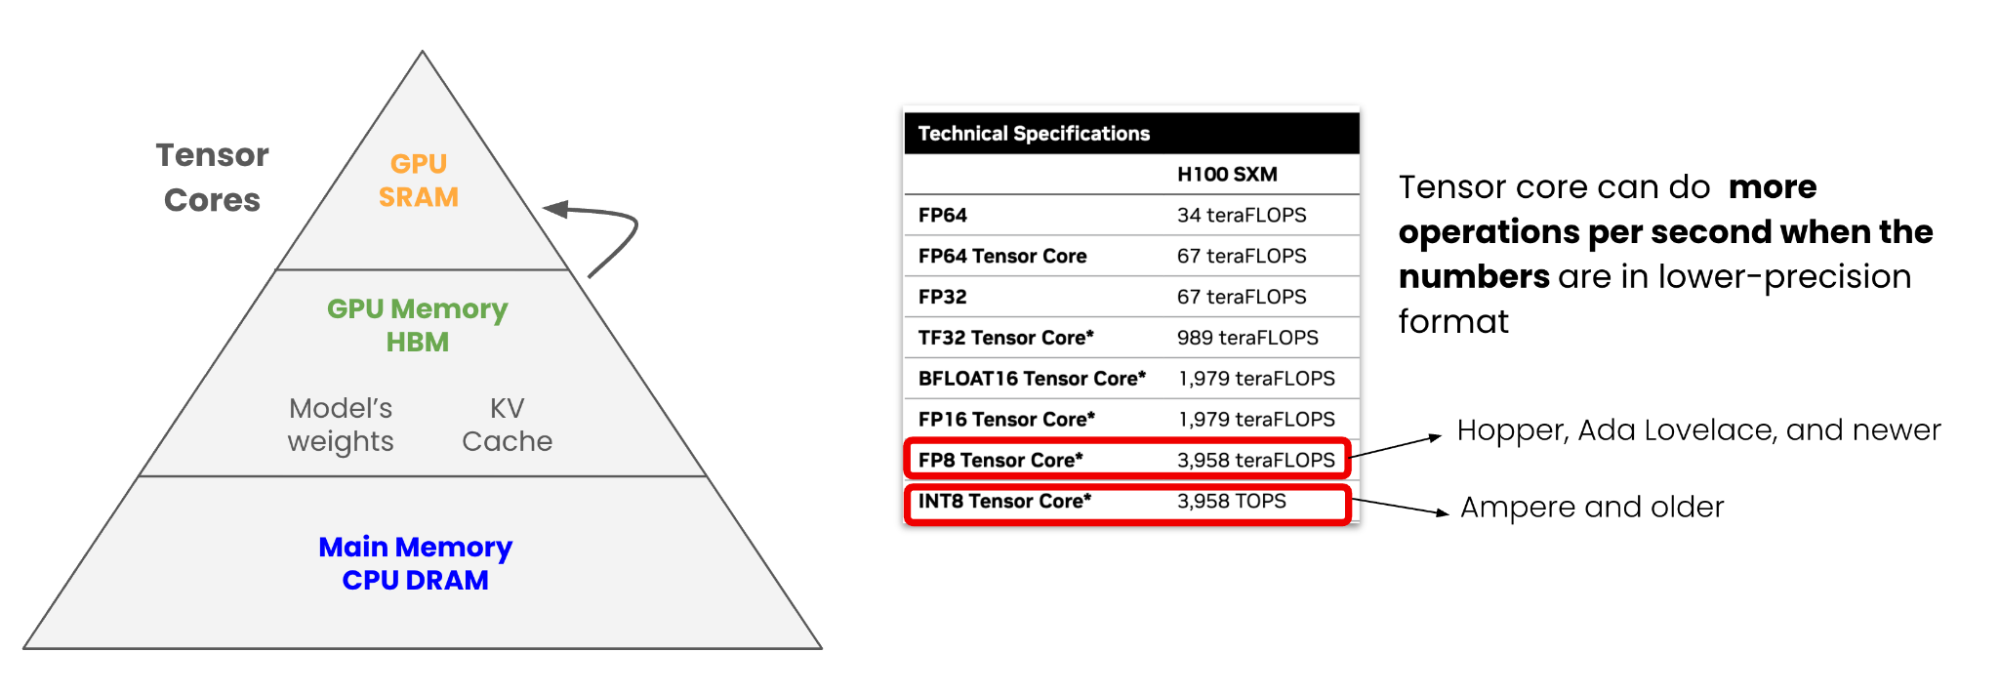
Abbildung 10: Kleinere Gewichtungen werden schneller in den schnellsten Speicher der GPU übertragen, und Berechnungen mit niedriger Präzision laufen auf Tensor Cores mit weitaus höherem Durchsatz.
In der Praxis halbiert FP8 Ihren Speicherbedarf und bringt bis zu 1,6-fachen Durchsatz bei minimalem Einfluss auf die Genauigkeit. Und nein, Sie machen das Modell dadurch nicht dümmer. Kalibrierte Techniken wie Generalized Post-Training Quantization (GPTQ), Activation-Aware Weight Quantization (AWQ) und SmoothQuant ermitteln anhand eines kleinen repräsentativen Datensatzes, welche Gewichtungen am wichtigsten sind, und schützen diese. Dadurch liegt der Qualitätsverlust typischerweise unter einem Prozentpunkt.
Cheatsheet zur KI-Modelloptimierung
Technik | Einsatzbereich | Ihre Vorteile |
PagedAttention | Runtime | Mehr gleichzeitige Anfragen im selben Speicher |
Kontinuierliches Batching | Runtime | GPU bleibt zwischen Anfragen ausgelastet |
Prefix Caching | Runtime | Überspringt die Neuberechnung bei geteiltem Kontext |
Quantisierung | Modell, Pre-Deployment | Weniger GPUs, schnelleres Laden, schnellere Berechnungen |
Sparsifizierung | Modell, Pre-Deployment | Überspringt die am wenigsten relevanten Gewichtungen |
Das Training verursacht einmalige Kosten; die Inferenz ist der wiederkehrende Posten und macht den Großteil der Gesamtkosten aus. Jedes Token erfordert einen vollständigen Vorwärtsdurchlauf. Der KV-Cache wächst mit der Kontextlänge sowie der Anzahl gleichzeitiger Nutzender, und seine Verwaltung ist die Hauptaufgabe Ihres Inferenzservers. In unserem Beispiel liegt der Unterschied zwischen einem einfachen und einem optimierten Deployment auf derselben GPU bei etwa 3 gleichzeitigen Nutzenden gegenüber 50. Wenn Sie die Inferenz optimieren, holen Sie deutlich mehr aus Ihrer vorhandenen Hardware heraus.
P.S.: Wenn Ihnen dieser Beitrag gefallen hat!
Wenn Sie dies selbst ausprobieren möchten, haben wir gemeinsam mit DeepLearning.AI und Red Hat einen kostenlosen praxisorientierten Kurs entwickelt: Quantisieren Sie ein Qwen-Modell mit LLM Compressor und messen Sie den Kompromiss bei der Genauigkeit, stellen Sie es mit vLLM bereit, führen Sie Benchmarks mit GuideLLM durch und testen Sie es mit lm-eval: Fast & Efficient LLM Inference with vLLM.
Ressource
Einstieg in die KI-Inferenz
Über den Autor
Cedric Clyburn (@cedricclyburn), Senior Developer Advocate at Red Hat, is an enthusiastic software technologist with a background in Kubernetes, DevOps, and container tools. He has experience speaking and organizing conferences including DevNexus, WeAreDevelopers, The Linux Foundation, KCD NYC, and more. Cedric loves all things open-source, and works to make developer's lives easier! Based out of New York.
Ähnliche Einträge
Warum die Zukunft der KI-Infrastruktur offen ist
Verteilte KI-Inferenz in der Telekommunikation
Nach Thema durchsuchen

Automatisierung
Das Neueste zum Thema IT-Automatisierung für Technologien, Teams und Umgebungen

Künstliche Intelligenz
Erfahren Sie das Neueste von den Plattformen, die es Kunden ermöglichen, KI-Workloads beliebig auszuführen

Open Hybrid Cloud
Erfahren Sie, wie wir eine flexiblere Zukunft mit Hybrid Clouds schaffen.

Sicherheit
Erfahren Sie, wie wir Risiken in verschiedenen Umgebungen und Technologien reduzieren

Edge Computing
Erfahren Sie das Neueste von den Plattformen, die die Operations am Edge vereinfachen

Infrastruktur
Erfahren Sie das Neueste von der weltweit führenden Linux-Plattform für Unternehmen

Anwendungen
Entdecken Sie unsere Lösungen für komplexe Herausforderungen bei Anwendungen

Virtualisierung
Erfahren Sie das Neueste über die Virtualisierung von Workloads in Cloud- oder On-Premise-Umgebungen
