Teil 2 einer Reihe zur Implementierung von Zero Trust in Red Hat OpenShift mit dem mehrschichtigen Zero Trust Validated Pattern (ZTVP)
In unserem vorherigen Artikel haben wir untersucht, warum Netzwerkrichtlinien, insbesondere eine Default-Deny-Haltung kombiniert mit strengen Ingress- und Egress-Regeln, Ihre entscheidende letzte Verteidigungslinie bilden, wenn Sie nicht schnell genug patchen können oder alle anderen Sicherheitsbarrieren versagen. Indem wir die Netzwerkkommunikation einschränken, eliminieren wir laterale Angriffspfade effektiv und dämmen den Schadensradius einer kompromittierten Workload ein.
Bei einer echten Zero Trust-Architektur im Sinne von NIST SP 800-207 geht es jedoch nicht darum, stärkere Schutzmauern zu errichten, sondern bessere Zugänge (Gates) aufzubauen und kontinuierlich zu überprüfen, was diese passiert. Netzwerkrichtlinien stellen uns diese Gates bereit. Wenn wir jedoch davon ausgehen, dass bereits eine Sicherheitsverletzung vorliegt, müssen wir uns einer harten Realität stellen: Selbst die besten statischen Zugriffskontrollen allein reichen nicht aus. Wenn eine Zero-Day Schwachstelle auftritt, benötigen Sie eine aktive Runtime-Überwachung, um anomales Verhalten innerhalb der Workload zu erkennen. Selbst mit den besten Netzwerkrichtlinien besteht immer die drohende Gefahr einer unbekannten Zero-Day Schwachstelle.
Wenn ein Angreifer durch Ihre Netzwerkrichtlinien in einem Container gefangen ist: Was tut er dort eigentlich? Um diese Frage zu beantworten, benötigen Sie ein zentrales Sicherheits-„Gehirn“. Im Layered Zero Trust Validated Pattern (ZTVP) übernimmt diese Funktion Red Hat Advanced Cluster Security.
Red Hat Advanced Cluster Security: Das Gehirn
Während Netzwerkrichtlinien vorgeben, was passieren soll, überwacht Red Hat Advanced Cluster Security (ACS), was tatsächlich geschieht. Im Kontext einer idealisierten NIST 800-207 Zero Trust-Architektur vervollständigt dieses kontinuierliche Monitoring den entscheidenden Sicherheitsregelkreis. Die Lösung erfasst kontinuierlich Transaktions- und Verhaltenskontexte in Echtzeit und fungiert als Policy Information Point (PIP). Diese Informationen werden an die zentrale Intelligence-Engine, den Policy Decision Point (PDP), weitergeleitet. Auf diese Weise kann Red Hat Advanced Cluster Security am Policy Enforcement Point (PEP) sofort automatisierte Reaktionen auslösen – etwa den Entzug des Zugriffs oder das Beenden einer kompromittierten Workload.
Im Rahmen von ZTVP stellen wir nicht nur die Standardkonfiguration von Red Hat Advanced Cluster Security bereit. Wir stellen die Lösung vorkonfiguriert mit benutzerdefinierten, maßgeschneiderten Sicherheitsrichtlinien bereit, die den Best Practices der Branche entsprechen, um dieses dynamische Zero Trust-Modell zur Runtime durchzusetzen. Unser benutzerdefiniertes Deployment führt 4 wichtige Richtlinien ein, die im Layered Zero Trust Validated Pattern Repository vollständig definiert und verfügbar sind. Sie arbeiten Hand in Hand mit der Netzwerkschicht. Um eine klare Übersicht über diese Kontrollen zu gewährleisten, sind sie in 2 verschiedene operative Kategorien unterteilt: Alerting (überprüft, ob unsere Netzwerk-Gates während des Deployments ordnungsgemäß konfiguriert sind) und Termination (neutralisiert eine laufende Bedrohung aktiv zur Runtime).
Diese 4 Richtlinien sind nachfolgend aufgeführt:
Kategorie | Richtlinienname | Durchsetzungsmaßnahme |
Alerting (Deployment) | Deployments sollten mindestens eine Ingress-Netzwerkrichtlinie enthalten | Benachrichtigt Administrierende, wenn ein Deployment ohne Ingress-Grenze bereitgestellt wird, und hebt Workloads hervor, die unnötig internem Netzwerkverkehr ausgesetzt sind. |
Alerting (Deployment) | Deployments sollten mindestens eine Egress-Netzwerkrichtlinie enthalten | Benachrichtigt Administrierende, wenn einem Deployment eine Egress-Grenze fehlt, und identifiziert Konfigurationen, die Datenexfiltration oder uneingeschränkte laterale Bewegungen ermöglichen könnten. |
Termination (Runtime) | Erweiterung von Privilegien zur Runtime verhindern | Beendet den Pod sofort, wenn ein Container versucht, Berechtigungen zu erweitern (z. B. durch Ausführen von |
Termination (Runtime) | Verdächtige Ausführung stoppen | Beendet den Pod sofort, wenn ein Angreifer versucht, Aufklärungs- oder Netzwerk-Tools (wie |
Vertrauen ist gut, Überprüfung ist besser: Compliance von Netzwerkrichtlinien überwachen
Wie genau stellen Sie sicher, dass Workloads tatsächlich durch diese Gates geschützt sind und dass bei einem Deployment-Update nicht versehentlich eine kritische Netzwerkgrenze ausgelassen oder entfernt wurde? Und wenn eine Richtlinie falsch konfiguriert ist und ein Angreifer sie umgeht: Wie fangen Sie ihn dann ab?
Im ZTVP lösen wir dieses Problem, indem wir unsere Runtime-Durchsetzung mit strengen Deployment-Prüfungen kombinieren. Um sicherzustellen, dass keine Workload aufgrund einer fehlenden oder versehentlich entfernten Netzwerkrichtlinie ungeschützt bleibt, umfasst ZTVP zwei spezifische benutzerdefinierte ACS-Deployment-Richtlinien – standardmäßig im Alerting-Modus aktiviert:
- Deployments müssen mindestens eine Ingress-Netzwerkrichtlinie aufweisen
- Deployments müssen mindestens eine Egress-Netzwerkrichtlinie aufweisen
Um diese Funktion kontrolliert zu demonstrieren und eine Alarmmüdigkeit über den gesamten Cluster hinweg zu verhindern, sind diese benutzerdefinierten Richtlinien derzeit standardmäßig nur für unsere ZTVP-Demoanwendung aktiviert. In diesem Rahmen scannen die Richtlinien kontinuierlich die Umgebung. Wenn ein Entwicklungsteam ein Deployment bereitstellt, ohne die spezifischen Netzwerkgrenzen zu definieren, meldet ACS dies sofort. So stellen Sie sicher, dass das Vorhandensein der grundlegenden „Gates“ stets verifiziert ist, während unsere Richtlinien zur Runtime-Beendigung bereitstehen, um anomales Verhalten abzufangen, sollten diese Gates jemals falsch konfiguriert oder umgangen werden.
Lassen Sie uns die technischen Einschränkungen von Konfigurationsscans jedoch offen ansprechen: Red Hat Advanced Cluster Security kann nicht direkt überwachen, ob eine namespaceweite „Deny by Default“-Richtlinie aktiv durchgesetzt wird. Nicht jede Best Practice der Architektur lässt sich durch statische Prüfungen vollständig validieren. Aufgrund dieser unvermeidlichen blinden Flecken beim Monitoring von Implementierungen hinterlässt das reine Verlassen auf Warnmeldungen eine kritische Sicherheitslücke.
Aktive Verteidigung: Beseitigung von Bedrohungen zur Runtime
Da wir wissen, dass wir nicht jede einzelne Sicherheitskontrolle statisch überprüfen können, müssen wir davon ausgehen, dass einige Fehlkonfigurationen unentdeckt bleiben oder ein Angreifer neue Wege findet, um eine Workload auszunutzen. Wenn ein aktiver Angriff stattfindet, reicht eine Warnung einfach nicht aus; hier zählen Sekunden. Hier wandelt sich die ZTVP-Implementierung von Red Hat Advanced Cluster Security von einem passiven Monitoring-Tool in einen hochwirksamen aktiven Abwehrmechanismus. Um die durch Einschränkungen statischer Überwachungen entstehende Lücke zu schließen, wurden 2 zusätzliche benutzerdefinierte Richtlinien implementiert und im Termination-Modus aktiviert:
- Monitoring von verdächtigem Pod-Verhalten
- Erkennung gefährlicher Befehlsausführungen
Demonstration: Bedrohungserkennung und Pod-Beendigung in Echtzeit
In diesem kurzen Video stellen wir das in unserem ersten Artikel etablierte Zero Trust-Kernprinzip „Assume a Breach“ auf eine entscheidende Probe. Wir simulieren ein Szenario, in dem ein Angreifer anfängliche Grenzen bereits erfolgreich umgangen und Zugriff auf einen laufenden Pod erhalten hat.
- Ohne ZTVP: In einer Standardumgebung ohne striktes Runtime-Monitoring hat ein Angreifer unbegrenzt Zeit, um Discovery-Befehle auszuführen, das interne Netzwerk zu erfassen, lokale Dateien zu untersuchen und völlig unentdeckt mit verschiedenen Exploit-Optionen zu experimentieren.
- Mit ZTVP: In einem ZTVP-gesicherten Cluster erkennt das Runtime-Monitoring von Red Hat Advanced Cluster Security sofort den ersten Aufklärungsbefehl eines Angreifers. Dies löst eine Richtlinie zur sofortigen Beendigung aus, wodurch die Terminal-Session geschlossen und der kompromittierte Pod in Echtzeit beendet wird, um die Bedrohung vor weiteren Aktivitäten zu neutralisieren.
Stellen Sie sich ein Szenario vor, in dem eine Zero-Day Schwachstelle in einer Komponente der Lieferkette einem Angreifer ermöglicht, Code in einem Ihrer Pods auszuführen. Selbst wenn Ihre Netzwerkrichtlinien Angreifende erfolgreich daran hindern, in andere Namespaces zu wechseln oder Daten zu exfiltrieren, befinden sie sich immer noch im Pod. Dort können Versuche stattfinden, Aufklärungsskripte auszuführen, Payloads einzuschleusen oder Shell-Befehle abzusetzen.
Sobald ein Angreifer versucht, einen gefährlichen Befehl auszuführen oder verdächtiges Verhalten zeigt, erkennt ACS die Anomalie. Da diese Richtlinien innerhalb von ZTVP auf den Termination-Modus gesetzt sind, sendet Red Hat Advanced Cluster Security nicht nur eine Warnung, sondern beendet den kompromittierten Pod sofort.
Dies ist das optimale Zusammenspiel im Sinne von Defense in Depth: Netzwerkrichtlinien blockieren die Fluchtwege des Angreifers und aktives Runtime-Monitoring eliminiert die Bedrohung vollständig. Selbst wenn eine Konfiguration übersehen wurde, sinkt das Risiko eines erfolgreichen, anhaltenden Angriffs praktisch auf null.
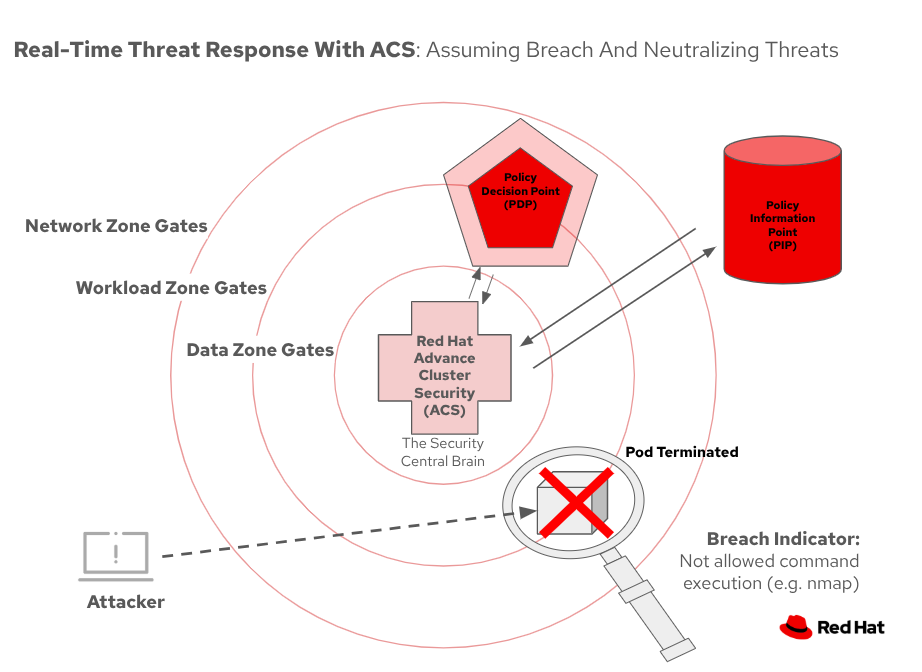
Reaktion auf Bedrohungen in Echtzeit mit Red Hat Advanced Cluster Security: Sicherheitsverletzungen voraussetzen und Bedrohungen neutralisieren
Den Regelkreis schließen: Echtzeittransparenz für Administrierende
Das Beenden eines kompromittierten Pods neutralisiert die unmittelbare Bedrohung. Das Betriebsteam und das Sicherheitsteam müssen jedoch weiterhin wissen, dass ein Angriffsversuch stattgefunden hat. Heute werden alle diese präzisen Warnmeldungen sofort protokolliert. Sie beschreiben das verdächtige Verhalten, die versuchten Befehle sowie die ergriffenen Durchsetzungsmaßnahmen detailliert und sind direkt in der Konsole von Red Hat Advanced Cluster Security sichtbar. So können Teams die Ursache untersuchen – wie etwa eine anfällige Komponente der Lieferkette zu identifizieren –, ohne unter dem Druck eines aktiven, eskalierenden Sicherheitsvorfalls zu stehen. Um diesen Kreislauf zu schließen, arbeiten wir aktiv daran, diese Funktion zu erweitern. Die ZTVP-Roadmap enthält geplante Integrationen mit externen Tracking- und Warnsystemen wie Atlassian Jira. In Kürze können Cluster-Administrierende und Sicherheitsteams diese wichtigen Echtzeit-Benachrichtigungen direkt über ihre bevorzugten operativen Kanäle erhalten. Das sorgt für noch mehr Transparenz und einen schnelleren Workflow bei der Vorfallreaktion.
Die Zero Trust-Realität
Diese Runtime-Verteidigung führt uns zurück zum Kern des Zero Trust-Modells. Kein System ist unüberwindbar. Unser vorheriger Artikel hat gezeigt, dass die Jagd nach dem „Heiligen Gral“ von null bekannten CVEs ein aussichtsloser Kampf ist, wenn Sie nicht schnell genug patchen können. Die entscheidende Erkenntnis des Zero Trust-Modells ist, dass Schwachstellen (sowohl bekannte CVEs als auch noch unentdeckte Zero-Days) unvermeidlich sind.
Strenge Netzwerkrichtlinien bilden zwar das Fundament für die Einrichtung von „Gates“, und erweiterte Kontrollen wie Inhaltssignaturen sowie Pipeline-Verifizierungen sind für die Sicherheit der Lieferkette unerlässlich – umfassend sind sie jedoch nicht. Die Fähigkeit, Workloads in Echtzeit zu überwachen, anomales Verhalten zu erkennen und Bedrohungen zur Runtime automatisch zu beenden, unterscheidet ein anfälliges System von einem wirklich resilienten System gegenüber unbekannten Risiken.
Sie müssen nicht auf den nächsten Teil warten, um eine resiliente Verteidigung zu implementieren.
- Aktives Monitoring implementieren: Deployen Sie die in diesem Artikel beschriebenen benutzerdefinierten Richtlinien von Red Hat Advanced Cluster Security (anhand der Richtlinienübersicht im Validated Pattern Repository), um stille Netzwerkblockaden in präzise Sicherheitsdaten zu verwandeln.
- Erkunden Sie die Architektur: Sehen Sie sich die vollständige Architektur des Layered Zero Trust Validated Pattern an, um zu verstehen, wie sich diese Runtime-Überwachung in das Gesamtbild einfügt.
Im nächsten Teil dieser Reihe untersuchen wir, wie ZTVP Workload-Identitäten mithilfe von SPIFFE/SPIRE mit einem Zero Trust-Workload-Identity-Manager sichert. So wird sichergestellt, dass eine Workload selbst bei einwandfreiem Verhalten ihre Identität kryptografisch exakt nachweisen muss.
Produkttest
Red Hat OpenShift Container Platform | Testversion
Über den Autor
Przemysław “Rogue” Roguski is a Security Architect at Red Hat who specializes in shift-left security initiatives focusing on embedding security best practices and attestation into the earliest stages of the SDLC. He contributes security analysis work on Red Hat OpenShift and other OpenShift-related products. He also designs security solutions and processes across Red Hat.
He contributes to the security ecosystem as a member of the CISA SBOM/VEX working groups, an OASIS OpenEoX Technical Committee member and a key contributor to the CWE program.
Ähnliche Einträge
Stabilen Code behalten: Mit Lightwell schneller zum Ziel
Die neue Währung für geschäftliche Agilität im KI-Zeitalter
Can Compliance Be A Piece Of Cake? | Compiler
Collaboration In Product Security | Compiler
Nach Thema durchsuchen

Automatisierung
Das Neueste zum Thema IT-Automatisierung für Technologien, Teams und Umgebungen

Künstliche Intelligenz
Erfahren Sie das Neueste von den Plattformen, die es Kunden ermöglichen, KI-Workloads beliebig auszuführen

Open Hybrid Cloud
Erfahren Sie, wie wir eine flexiblere Zukunft mit Hybrid Clouds schaffen.

Sicherheit
Erfahren Sie, wie wir Risiken in verschiedenen Umgebungen und Technologien reduzieren

Edge Computing
Erfahren Sie das Neueste von den Plattformen, die die Operations am Edge vereinfachen

Infrastruktur
Erfahren Sie das Neueste von der weltweit führenden Linux-Plattform für Unternehmen

Anwendungen
Entdecken Sie unsere Lösungen für komplexe Herausforderungen bei Anwendungen

Virtualisierung
Erfahren Sie das Neueste über die Virtualisierung von Workloads in Cloud- oder On-Premise-Umgebungen
