
現在是週五晚上。Priya 是金融服務公司的機器學習 (Machine Learning, ML) 工程師,她正在 GPU 叢集上排定一項詐欺偵測微調作業,每小時成本為 US$55。執行約需 40 小時,運算成本約為 US$2,200。她再次檢查超參數、提交工作,然後回家度週末。
週一早上,她打開筆記型電腦。模型在週五晚上的某個時間點就已停止學習,但作業仍持續執行,在一場毫無進展的訓練中浪費了整整兩天的 GPU 時間。這造成了超過 US$1,500 的運算浪費,而且她必須從頭開始。
如果您對此感到熟悉,您並不孤單。每一位執行過多日訓練作業的開發人員都知道這些令人不安的問題:
- 模型真的有學到東西嗎?
- 我是否該及早停止並嘗試不同的超參數?
- 這項作業能在週二的專案關係人審查前完成嗎?
無法掌握進度的代價是真實存在的。隨需 GPU 叢集的成本每小時可能高達 US$50 以上。單次為期多日的訓練執行成本可輕易達到數千美元,而配置錯誤的執行可能會在任何人察覺之前,浪費掉整個週末的運算資源。在共用叢集中,其影響會成倍增加:停滯的作業不僅浪費一個團隊的預算,還會阻礙其他團隊存取所需的 GPU。一個團隊的盲目執行,成了另一個團隊的延誤。問題不在於團隊粗心大意。而是他們像在黑暗中作業,無法掌握實際狀況。每一小時的 GPU 時間都至關重要,若無法即時掌握訓練進度,將會造成大量浪費。
可觀測性落差
這是一個令人不安的事實:從平台的角度來看,收斂良好的訓練作業與完全停滯的作業看起來完全相同。兩者皆為處於 running 狀態的 Pod,消耗相同的資源並顯示相同的綠色狀態指標。Kubernetes 無法判斷您的模型是否正在學習。
現今雖然可以監控訓練進度,但其難度卻超乎想像。
- 記錄分散且難以使用:在分散式訓練作業中,記錄會分散在多個 Pod 中。找到相關輸出意味著知道該查看哪個 pod、如何存取,以及如何解析框架特定的記錄格式。這需要具備 Kubernetes 專業知識,而大多數資料科學家和人工智慧 (Artificial Intelligence, AI) 工程師不應該僅為了監控訓練執行,就必須學習這項額外的技能。品質欠佳且非結構化的記錄難以透過機器讀取,因此無法推動自動化。
- 外部工具雖然解決了可觀測性問題,卻會增加管理負擔:像 MLflow 和 Weights & Biases 這樣的實驗追蹤平台,在各自的功能領域表現優異。但是這些平台需要額外的基礎架構來進行部署與維護,也需要管理 API 金鑰與存取控制,且其運作是在平台層之上。它們也與 Kubernetes API 脫節,這意味著更難以將其與自訂的 Kubernetes 原生工作流程和自訂運算子整合。它們會告訴您訓練迴圈內發生的情況,但無法告知平台目前的進度。
- 每個框架的運作方式都不同:PyTorch DDP、FSDP、DeepSpeed、JAX —— 每一種都有自己的記錄慣例、指標格式以及報告進度的方式。各框架之間缺乏一致性,這意味著對於管理異質訓練環境的平台團隊而言,沒有統一的檢視介面。
- 沒有標準的 API:截至目前為止,訓練工作尚無標準化方式來向平台回報進度。這導致管理共享 GPU 叢集的平台管理員只能靠猜測來判斷哪些工作正在進行、哪些已停滯,以及哪些即將完成。缺乏可視性,容量規劃與疑難排解都只能憑空推測。
縮小差距:Red Hat OpenShift AI 中的進度追蹤
Red Hat OpenShift AI 現在包含適用於分散式訓練工作的生產級進度追蹤功能,該功能內建於 Kubeflow Trainer v2 中,並從 Red Hat OpenShift AI 3.4 版本開始正式推出。您可以在狀況發生時即時掌握進度,並在問題惡化前採取行動。此功能讓資料科學家、ML 工程師和平台管理員能夠即時掌握訓練工作的執行狀況,直接解決了可觀測性不足的問題。
這種可視性建立在三大支柱之上:
- 儀表板視覺化:即時進度指標可直接在 Red Hat OpenShift AI 儀表板中查看。您可以一目了然地查看進度百分比、目前與總步數、目前 epoch (曆元)、預估剩餘時間、訓練損失,以及您的 TrainJobs 評估指標。無需獨立工具,也不必進行額外設定。
- SDK 整合: 相同的進度資料也可以透過 Kubeflow SDK 以程式化方式取得。這讓團隊能夠建立自動化管線來因應訓練進度,例如根據即時指標觸發提前停止 (early stopping)、傳送通知或重新分配資源。
- 多框架一致性:無論您是使用 PyTorch DDP、FSDP、DeepSpeed 還是 JAX,進度追蹤的運作方式都相同。它還支援透過 CustomTrainer API 使用自訂訓練程式碼。這為各框架提供了單一的統一體驗。
即時掌握訓練動態
了解進度追蹤的最佳方式,就是實際體驗其運作情形。其中有三個重要的步驟。
- 開始您的訓練工作: 您一如往常,使用 Kubeflow SDK 從筆記本提交訓練工作。如果您使用的是 HuggingFace Transformers,進度追蹤是自動進行的,無需變更程式碼。此整合功能會偵測 Kubeflow 環境,並開始回報訓練迴圈的指標。
- 觀察其進度: 訓練執行時,Red Hat OpenShift AI 儀表板會顯示即時指標:進度百分比、預估剩餘時間、已完成步驟、週期 (epochs)、梯度範數 (gradient norm)、訓練損失、學習率。無需追蹤記錄、無需透過 SSH 登入 Pod,也不必設定外部工具。
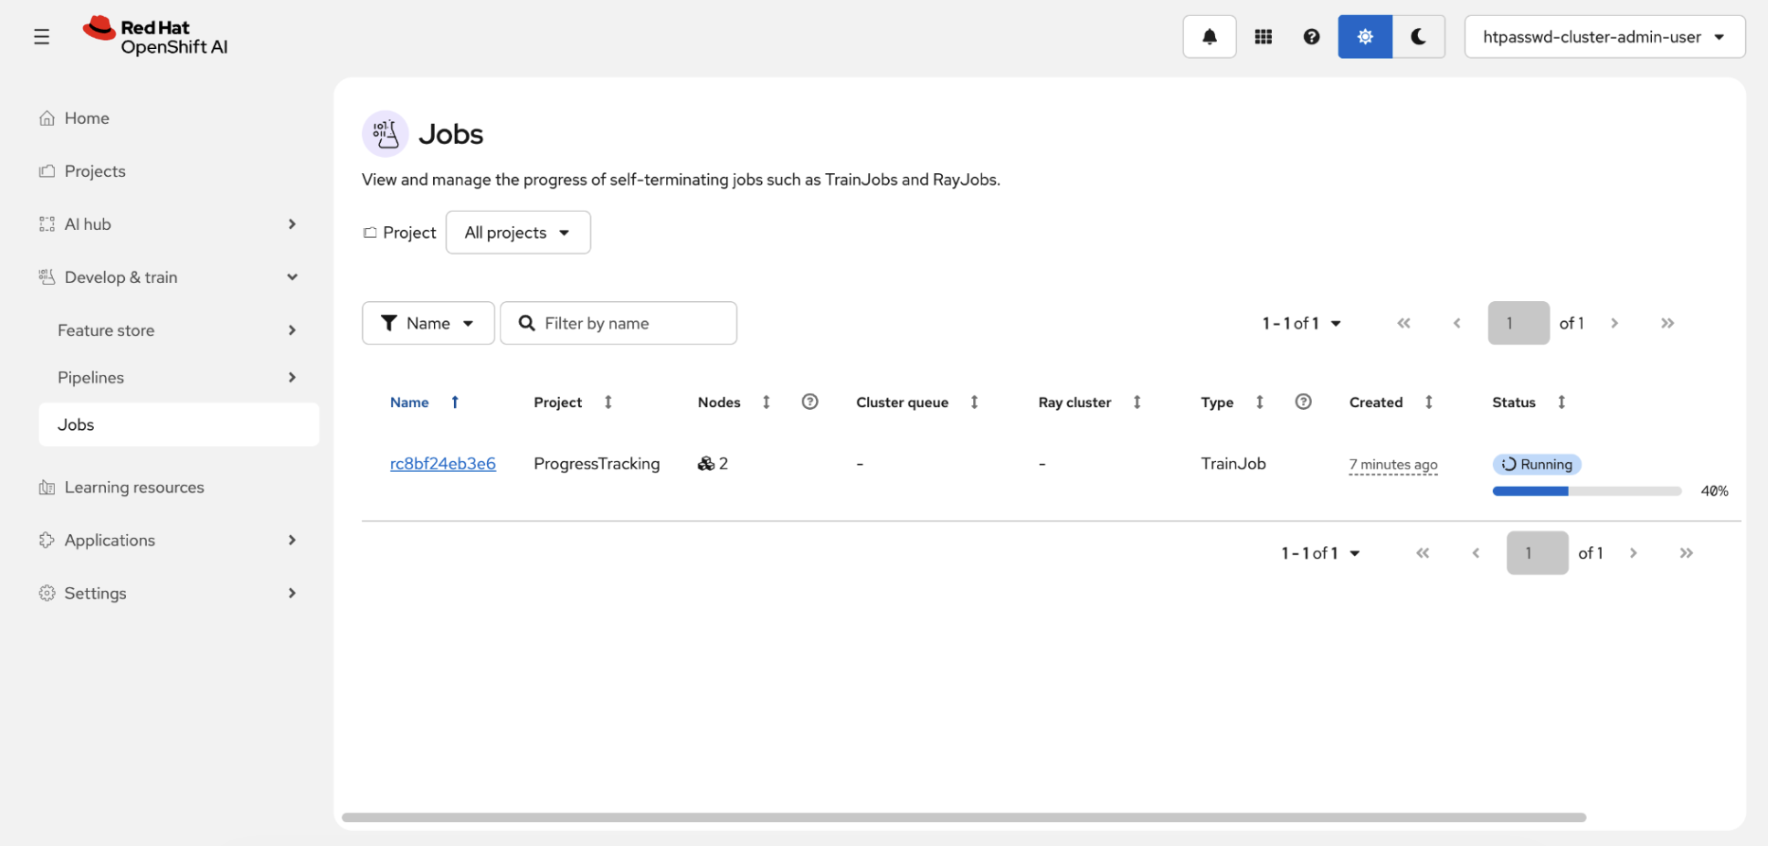
圖 1:Red Hat OpenShift AI 儀表板會顯示工作清單,其中進度條表示執行中的 TrainJob 已完成 40%。
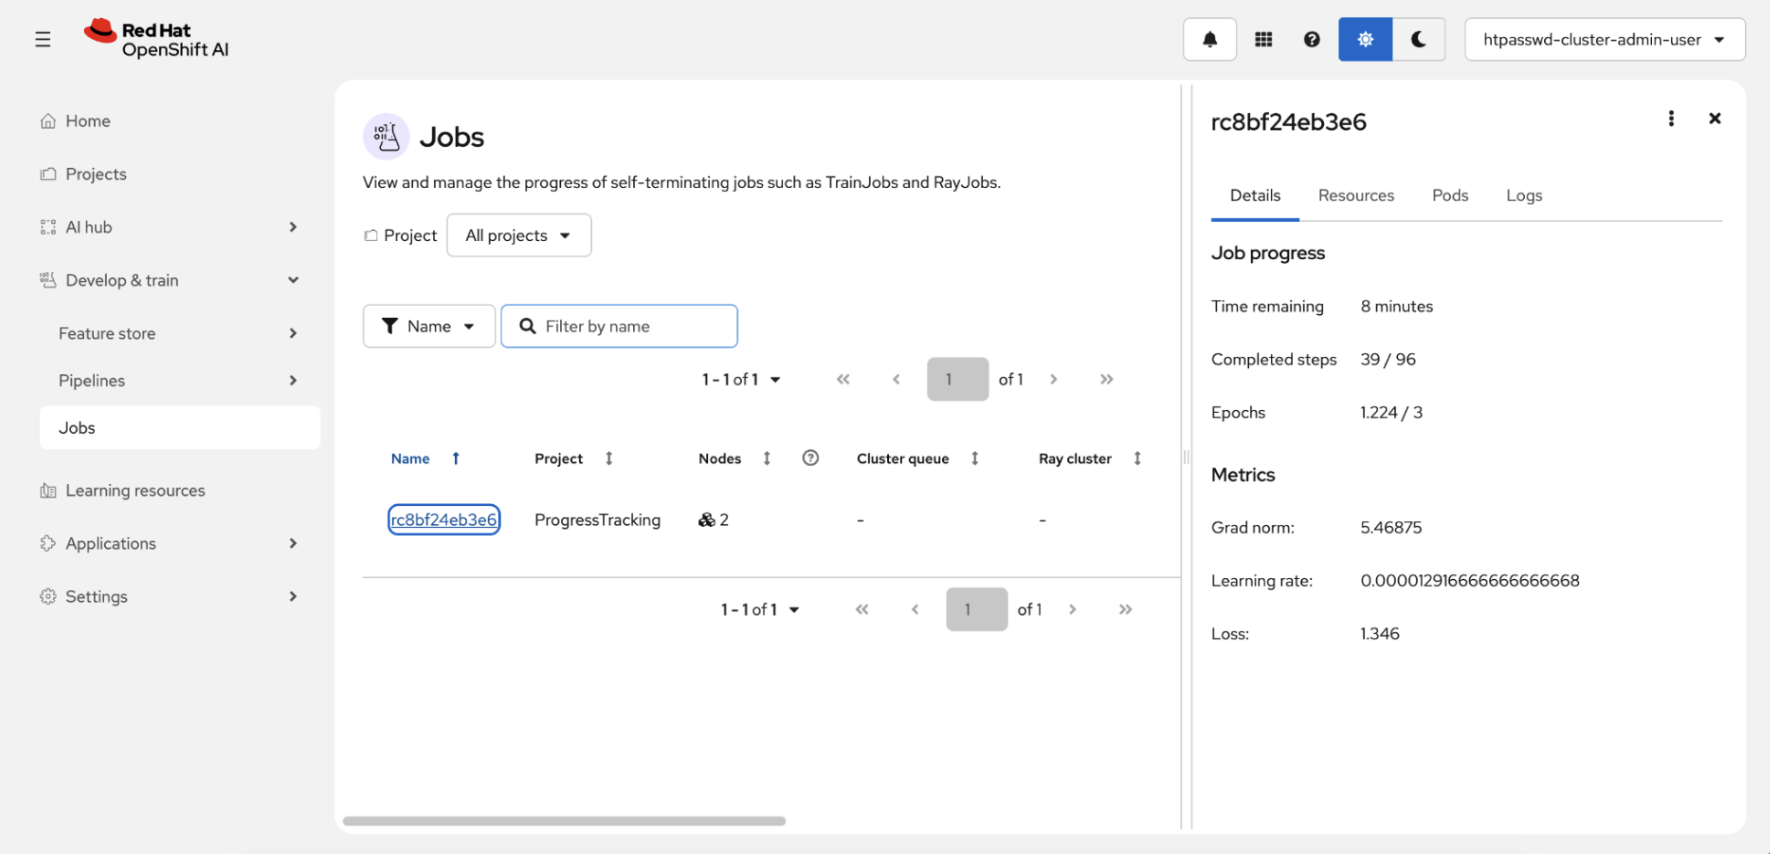
圖 2: 顯示工作進度與即時指標的詳細側邊面板。
- 根據所見內容採取行動:進度追蹤功能在此能為您節省時間與運算資源。注意到損失函數 (loss) 未見改善?及早停止工作,以節省數小時的 GPU 時間。發現執行收斂速度比預期快嗎?為您的團隊成員釋出資源。準確掌握工作完成的時間,以便您據此規劃;不必再猜測結果是否能在週二的利害關係人審查前準備就緒。
使其具備實用性的關鍵特徵:
- 零設定:無需額外的基礎架構、無需外部依賴,亦不用額外設定。進度追蹤功能開箱即用。
- 資源負荷極低:指標會在正常的訓練檢查點回報,且不會影響訓練效能。
- 支援跨框架運作:無論您使用的是 PyTorch DDP、FSDP、DeepSpeed、JAX,還是自訂訓練程式碼,獲得的體驗都完全相同。
受益對象
不需透過 SSH 進入 Pod 或追蹤記錄,資料科學家和機器學習 (ML) / 人工智慧 (AI) 工程師即可查看即時訓練損失、進度百分比和預計完成時間 (ETA)。及早偵測發散或停滯的訓練——在週六早上而非週一發現停滯的作業,可節省數小時浪費的 GPU 時間。從儀表板一目了然地比較各項訓練執行情況,以快速辨識效能最佳的超參數配置。
平台管理員可透過單一儀表板,檢視叢集中所有的訓練作業。無論作業使用的是 DDP、FSDP 還是 DeepSpeed,管理員都能看到一致的指標,並藉由了解哪些作業正在進行、哪些已停滯,以及哪些即將完成,做出更理想的容量規劃決策。
在多個團隊共用相同叢集的多租用戶 GPU 環境中,這種可見性可直接提升資源利用率和 ROI。對於正在建構
除了監控之外:為更智慧的訓練奠定基礎
進度追蹤不只是監控功能,更是重要的基礎。一旦平台能夠存取即時訓練進度資料,就能實現一系列更智慧的行為。雖然這些進階功能尚未納入 Red Hat 產品承諾,但基礎已經完備。上游 Kubeflow Trainer 社群正在積極探索多個方向:
- 更智慧的超參數微調:目前,Katib 等超參數最佳化引擎仰賴解析含有脆弱正規表示式模式的記錄,來評估試驗效能。透過直接在 Kubernetes API 中提供的訓練指標,Katib 能夠原生讀取訓練狀態,進而實現更緊密的整合與更有效率的試驗編排。這是上游社群正在討論的 KEP。
- 彈性擴展:收斂速度和 ETA 資料可為擴充和縮減規模的決策提供依據。快速收斂的模型可以為其他團隊釋出 GPU,而陷入停滞期的模型則可請求額外的工作節點。上游社群正在探索 TrainJob 中的彈性 PyTorch 支援 以實現此目標。
- CLI 進度可見性: 具有內建
PROGRESS %欄位的kubectl get trainjob可直接將訓練進度帶入命令列,讓操作人員無需儀表板或 SDK 即可獲得即時的可見性。 - 更智慧的檢查點: 雖然 Red Hat OpenShift AI 已經支援 定期與即時模型檢查點,但在具備 ETA 和進度資料的情況下,平台可以就何時執行檢查點做出更明智的決策,例如根據作業的 ETA 自動儲存狀態。上游社群正在探索 使用 CRIU 的透明 GPU 檢查點技術,以強化 TrainJob 的容錯能力和韌性。
這些是 Kubeflow 專案正積極探索的領域(而非產品承諾),但這些領域說明了為何進度追蹤的重要性不只局限於目前的功能:它建立了整個訓練堆疊可建構於其上的資料層。
分散式訓練的進度追蹤已在 Red Hat OpenShift AI 3.4 中正式提供。如需更多資訊,請參閱 Red Hat OpenShift AI 文件。您也可以透過開始 Red Hat OpenShift AI 的 60 天試用版來親自體驗。
About the author
I am a Software Quality Engineer at Red Hat specializing in Kubeflow and distributed AI training. I am focused on making large-scale infrastructure efficient and resilient, and I share insights on distributed model training and fine-tuning on Kubernetes.
More like this
asago 簡介:開放原始碼人工智慧 (AI) 安全與治理調度
為什麼優秀的人工智慧代理 (AI Agent) 會在正式環境中失敗:缺失的基礎架構層
How Red Hat cleared IT debt for scalable AI
Standardizing the AI stack with PyTorch
Keep exploring
- What is agentic AI?
Article - Predictive AI vs. generative AI
Article Top considerations for building a production-ready AI/ML environment E-book 页面当前以 English (英文) 显示(暂无 Chinese, Traditional 选项)- Generative AI, the Ansible way
Video Innovate and transform with a modern application platform页面当前以 English (英文) 显示(暂无 Chinese, Traditional 选项) E-book 页面当前以 English (英文) 显示(暂无 Chinese, Traditional 选项)
Browse by channel

Automation
The latest on IT automation that spans tech, teams, and environments

Artificial intelligence
Explore the platforms and partners building a faster path for AI

Cloud services
Get updates on our portfolio of managed cloud services

Security
Explore how we reduce risks across environments and technologies

Edge computing
Updates on the solutions that simplify infrastructure at the edge

Infrastructure
Stay up to date on the world’s leading enterprise Linux platform

Applications
The latest on our solutions to the toughest application challenges

Original shows
Entertaining stories from the makers and leaders in enterprise tech
