Was ist PyTorch?
PyTorch ist eine Open Source-Software-Library, mit der Entwicklungsteams Code zusammenstellen und ein „KI-Gehirn“ erschaffen können, das lernen kann, Muster in Daten zu erkennen. Technisch ausgedrückt können Entwicklungsteams mit PyTorch mithilfe modularer Schichten komplexe neuronale Netze für fortgeschrittenes Machine Learning erstellen und trainieren.
Warum PyTorch verwenden?
PyTorch hat an Beliebtheit gewonnen, weil es den Fokus auf das Entwicklungserlebnis legt und Änderungen an der Modellstruktur in Echtzeit vereinfacht. Nutzende interagieren mit der Anwendung, wobei Python als Programmiersprache im Frontend zum Einsatz kommt. PyTorch nutzt C++ als Programmiersprache (und CUDA, sofern eine NVIDIA-GPU verfügbar ist), um aufwendige Berechnungen im Backend auszuführen. Dieser hybride Ansatz sorgt für ein einfaches User Interface bei gleichzeitig maximaler Rechenleistung.
PyTorch ist ein Open Source-Projekt der PyTorch Foundation, die Teil der Linux® Foundation ist. Diese Art offener Governance bedeutet, dass die Nutzung kostenlos ist, das System von der Open Source Community kontinuierlich weiterentwickelt wird und vollständig überprüfbar ist. Entwicklungsteams können den Quellcode einsehen und überprüfen, wie das Framework mit Daten umgeht.
Über die Open Source-Wurzeln hinaus ist die zugrunde liegende Architektur von PyTorch auf Flexibilität, Skalierbarkeit und Zugänglichkeit für Nutzende auf verschiedenen Hardwareplattformen oder bei verschiedenen Cloud-Anbietern ausgelegt.
4 wichtige Überlegungen zur Implementierung von KI-Technologie
Was kann PyTorch?
PyTorch bietet Entwicklungsteams die Bausteine, die sie für das Design und das Deployment von künstlicher Intelligenz benötigen. Anstatt Entwicklungsteams zu zwingen, komplexe Systeme von Grund auf neu zu entwickeln, zeichnet sich PyTorch durch den intuitiven, Python-nativen Ansatz und seine Library mit sofort einsatzbereiten Machine Learning-Modellen aus. Seine größte Stärke ist die Flexibilität, die es Entwicklungsteams ermöglicht, ihre KI-Modelle während der Ausführung in Echtzeit anzupassen und mit ihnen zu experimentieren.
Gehen wir die einzelnen Schritte zum Entwickeln und Ausführen eines Machine Learning-Modells durch, um zu sehen, wo PyTorch ins Spiel kommt:
Planung und Datenaufbereitung
Der erste Schritt besteht darin, das Problem zu definieren und die Daten vorzubereiten. PyTorch ist kein Tool zur Datenbereinigung, daher verwenden Entwicklungsteams separate Tools (wie Pandas oder SQL), um Daten zu organisieren. Mit Docling könnten sie Dokumente aufbereiten und in strukturierte Daten umwandeln. PyTorch leitet diese aufbereiteten Daten an neuronale Netze weiter.
Modelltraining
Hier dient PyTorch als primäre Arbeitsumgebung, in der Entwicklungsteams KI-Modelle entwerfen und trainieren können. Sobald der Code erstellt ist, fungiert PyTorch als universelle Bridge und leitet Datentensoren an Ihren Hardwarebeschleuniger weiter. Dabei kann es sich um eine NVIDIA-GPU (Graphics Processing Unit) mit CUDA, eine AMD-GPU über ROCm oder um Systeme mit Intel- und Apple Silicon-Prozessoren handeln. (Mehr zu CUDA und Tensoren später.) Bei KI-Modellen für Unternehmen besteht ein gängiger Ansatz darin, diesen Trainingscode in einen Docker Container zu packen und an einen Kubernetes-Cloud Cluster zu senden. (Mehr zu Docker und Kubernetes später.)
Modellbewertung
Entwicklungsteams nutzen PyTorch in dieser Phase zum Testen der Performance des Modells anhand eines neuen Datensatzes. In diesem Moment frieren Entwicklungsteams die internen Einstellungen des Modells ein und unterbrechen damit den Lernprozess, um die reine Performance bei Vorhersagen zu bewerten.
Deployment
Ist das Training eines Modells mit PyTorch abgeschlossen, bleibt den Entwicklungsteams eine riesige Datei voll optimierter mathematischer Einstellungen (Gewichte und Verzerrungen, auch als Modellparameter bezeichnet). An dieser Stelle geht die KI vom Training zur Inferenz über. Die KI hört auf zu lernen und beginnt, auf der Grundlage ihres Trainings Vorhersagen zu treffen. Zum Starten können Sie das „KI-Gehirn“ in ein Docker-Image für die Produktion packen und an Cloud-Plattformen wie Amazon Web Services (AWS), Google Cloud oder Microsoft Azure senden. Sobald das Modell in der Cloud angekommen ist, übernimmt Kubernetes das Infrastrukturmanagement und die Skalierung, während eine Inferenz-Engine wie vLLM die Geschwindigkeit und Performance der Berechnungen optimiert.
Was können Sie mit PyTorch entwickeln?
Mit PyTorch können Sie Anwendungen für Machine Learning und Deep Learning entwickeln. Es wird häufig für das Training in folgenden Bereichen eingesetzt:
Large Language Models (LLMs): PyTorch war die Basis für die frühen GPT-Modelle von OpenAI und die Llama-Reihe von Meta.
Maschinelles Sehen: Selbstfahrende Autos, medizinische Bildgebung und Gesichtserkennungssoftware nutzen häufig PyTorch (besonders das Library-Paket TorchVision), um Pipelines zu entwickeln, die Unterstützung bei der Bildklassifizierung und Objekterkennung benötigen.
Bilderzeugung: Mit PyTorch lassen sich Text-zu-Bild-Modelle trainieren. Es stellt die mathematischen Grundlagen bereit, die erforderlich sind, um Millionen oder Milliarden von Bildern zu analysieren und der KI das Erstellen von Bildmaterial beizubringen.
Natural Language Processing (NLP) und Sprache: Mit PyTorch lassen sich Text-zu-Sprache- und Sprache-zu-Text-Modelle trainieren, die den Zusammenhang zwischen Schallwellen und strukturiertem, lesbarem Text verarbeiten. Sie können PyTorch auch zum Erstellen von Übersetzungstools nutzen.
Was ist ein Tensor in PyTorch?
Tensoren sind die grundlegenden Bausteine moderner KI. Jedes Wort, Bild, Video und jede Audiowelle werden in einen Tensor umgewandelt, bevor ein KI-Modell sie verarbeiten kann.
PyTorch wird manchmal als Library für die Programmierung mit Tensoren beschrieben – strukturierte Anordnungen von Zahlen, die Rohdaten und Modellparameter darstellen. PyTorch bietet die Tools zum Erstellen und Ausführen komplexer neuronaler Netze. Indem PyTorch strukturierte Tensoren durch diese Netze leitet, bildet es das rechnerische „Gehirn“ eines KI-Modells.
Ganz einfach ausgedrückt ist ein Tensor ein Container für Zahlen. Ein Tensor kann von einer einzelnen Ziffer (auch als Skalar bezeichnet) bis hin zu einem mehrdimensionalen Zahlenraster reichen. Tensoren existieren in verschiedenen Größen, je nach Anzahl ihrer Dimensionen:
- Ein Skalar ist ein Tensor mit 0 Dimensionen. Es handelt sich dabei um eine einzelne Zahl.
- Ein Vektor ist ein Tensor mit 1 Dimension. Es handelt sich dabei um eine Reihe von Skalaren oder eine Zahlenreihe.
- Eine Matrix ist ein Tensor mit 2 Dimensionen. Es handelt sich dabei um ein Zahlenraster, ähnlich einer Tabellenkalkulation.
- Ein Tensor mit 3 oder mehr Dimensionen wird als hochdimensionaler Tensor bezeichnet. Es handelt sich dabei um einen verschachtelten Stapel aus Rastern, ähnlich wie ein 3D-Zauberwürfel.
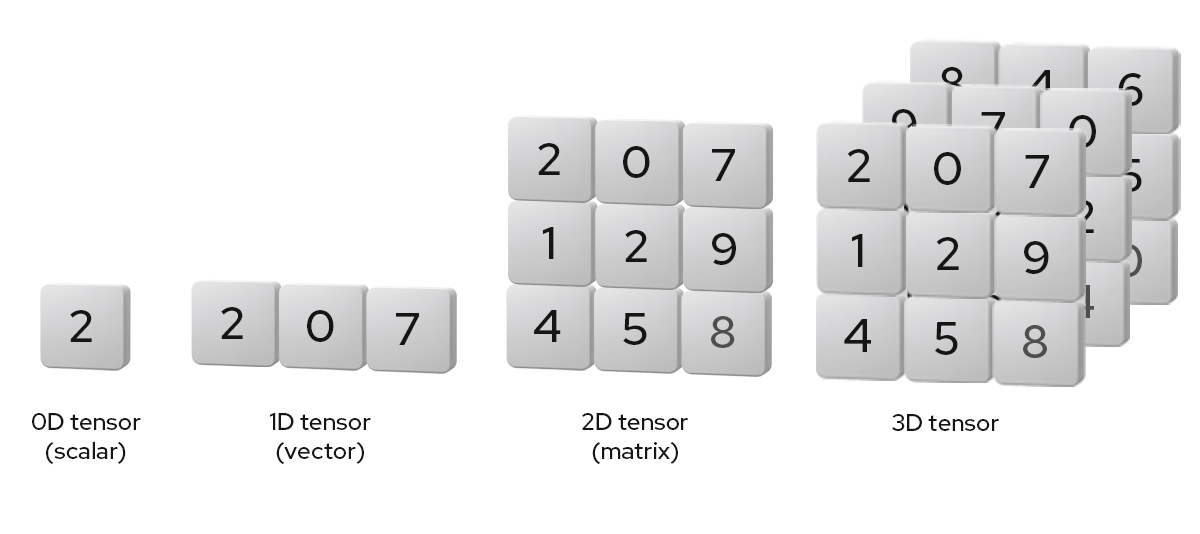
Tensoren können immer weitere Dimensionen erhalten, wie 4D- und 5D-Tensoren. Dank hochdimensionaler Tensoren kann PyTorch komplexe Daten wie Farbbilder oder Videosequenzen stapeln und strukturieren.
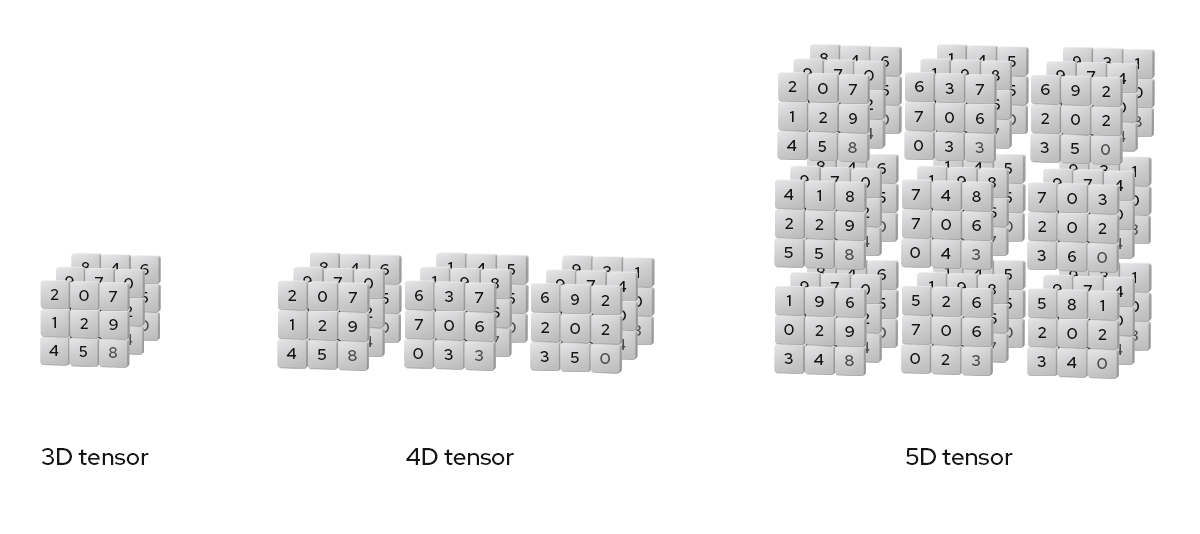
Aber warum reden wir über Dimensionen?
Wenn PyTorch Daten verarbeitet, stellt es Informationen als Tensoren im sogenannten hochdimensionalen Raum dar. Ein hochdimensionaler Raum ist ein abstrakter mathematischer Bereich mit Dutzenden oder sogar Tausenden von Richtungen und Dimensionen. Hier kann ein KI-Modell Konzepte darstellen und analysieren, indem es Koordinaten abbildet und misst.
Da wir in einer 3D-Welt leben, fällt es uns Menschen schwer, uns einen Raum mit Tausenden von Dimensionen vorzustellen. Bei Computern hingegen lernt die KI mithilfe linearer Algebra, indem sie Daten in einen hochdimensionalen Raum abbildet und die räumlichen Beziehungen zwischen den Punkten berechnet.
Mit PyTorch wandeln Sie Daten in ein strukturiertes Raster aus Zahlen (Tensoren) um und leiten den Tensor durch ein neuronales Netz. Während das neuronale Netz diese Daten verarbeitet, nutzt es sie, um interne Parameter schrittweise anzupassen (wobei die Anzahl je nach Modell von einigen Dutzend über einige Hundert bis hin zu Billionen reichen kann). Durch diesen Prozess lernt das Modell, Muster und Zusammenhänge in den Daten zu erkennen. Diese erlernten Muster ermöglichen es dem Modell, Vorhersagen über neue Informationen zu treffen, mit denen es noch nie in Berührung gekommen ist. Durch dieses erlernte Verhalten entsteht ein „KI-Gehirn“.
Wie unterscheidet sich PyTorch von TensorFlow?
PyTorch und TensorFlow sind beides Open Source-Tools, die Computern beim Lernen helfen, indem sie Daten in Tensoren umwandeln und diese Tensoren in einem digitalen Raum abbilden. Bei PyTorch liegt der Schwerpunkt auf Flexibilität und Benutzerfreundlichkeit, während TensorFlow auf Skalierbarkeit und Struktur setzt.
PyTorch wurde 2017 von Meta (ehemals Facebook) als Open Source-Produkt veröffentlicht. Es begann als internes Tool, das von Grund auf als Research First-Framework konzipiert war und schnellere, flexiblere Möglichkeiten bot, Architekturen neuronaler Netze zu testen. PyTorch gewann an Beliebtheit, denn Entwicklungsteams empfanden es als benutzerfreundlicher als TensorFlow und schätzten die Möglichkeit schneller Iterationen.
TensorFlow wurde 2015 von Google als Open Source-Produkt veröffentlicht. Es begann als internes Tool für Forschung und Produktion und war für den Einsatz auf riesigen Unternehmenssystemen konzipiert. So wurde TensorFlow in Unternehmensumgebungen beliebt, die mit Millionen von Nutzenden und umfangreichen Cloud-Servern arbeiten.
Heute weisen PyTorch und TensorFlow viele gemeinsame Features auf und haben sich gegenseitig bei der Weiterentwicklung inspiriert.
Was ist CUDA und wie nutzt PyTorch diese Technologie?
CUDA (kurz für „Compute Unified Device Architecture“) ist eine Softwareplattform, mit der Entwicklungsteams Code erstellen können, der auf NVIDIA-GPUs zur parallelen Verarbeitung ausgeführt wird. PyTorch nutzt CUDA als digitale Bridge, um Berechnungen vom Hauptprozessor eines Computers auf eine NVIDIA-GPU auszulagern. So lassen sich Milliarden von Berechnungen extrem schnell durchführen.
Für die Nutzung von PyTorch benötigen Sie jedoch weder eine Grafikkarte noch CUDA. Ohne eine unterstützte GPU-Plattform wie CUDA oder ROCm führt PyTorch Ihre Workloads standardmäßig automatisch auf der CPU (Central Processing Unit) Ihres Computers aus. Die Verwendung von PyTorch mit einer CPU eignet sich gut für das Debugging oder das Ausführen kleiner Modelle. Wenn Sie aber Daten in Millisekunden statt in Stunden über umfangreiche, neuronale Netze verarbeiten möchten, ist CUDA ein geeigneter Partner für PyTorch.
Was ist ein Berechnungsgraph?
Ein Berechnungsgraph ist eine visuelle Darstellung mathematischer Schritte. Er verfolgt den Datenfluss innerhalb eines mathematischen Systems und verdeutlicht, welche Operationen PyTorch an jedem Knoten ausgeführt hat, wobei die Abhängigkeiten zwischen Schichten des Netzwerks hervorgehoben werden.
In der KI-Entwicklung bildet ein Berechnungsgraph den Blueprint für den Lernprozess. Er verfolgt, wie Eingaben zu Ausgaben werden und bietet dem Computer einen rückverfolgbaren Weg zur Fehlersuche und Anpassung interner Parameter.
Was ist ein dynamischer Berechnungsgraph?
PyTorch nutzt dynamische Berechnungsgraphen (Dynamic Computational Graphs, DCGs) zum Ausführen von Deep Learning-Modellen. Der Unterschied zwischen DCGs und herkömmlichen Berechnungsgraphen – auch als statische Graphen bezeichnet – liegt letztlich in der Flexibilität.
Zur Veranschaulichung des Unterschieds zwischen statischen und dynamischen Berechnungsgraphen kann man sich einen Zug (die Daten) vorstellen, der auf einer Bahnstrecke (die Architektur des Deep Learning-Modells) fährt.
Ein statischer Graph wäre so, als würde man eine komplette Strecke bauen, bevor ein Zug darauf fahren kann. Jeder Zug müsste dieselbe Strecke fahren, und alle erforderlichen Umwege oder Abzweigungen müssten im Voraus eingeplant und angelegt werden. Wenn ein Zug mit Daten eintrifft, die eine Strecke benötigen, für die noch kein Gleis gelegt ist, stürzt das System ab, und die Strecke muss neu gebaut werden. Mit anderen Worten: Bei einem statischen Graphen muss man das Modell vollständig erstellen, bevor man Daten damit verarbeiten kann.
Ein dynamischer Graph wäre vergleichbar damit, für jeden Zug unmittelbar vor seiner Abfahrt eine neue Route zu entwerfen und diese Route an die jeweilige Ladung des Zuges anzupassen. Sind die Daten ein kurzer Satz, erstellt PyTorch einen kurzen Pfad, um die Daten durch das Modell zu leiten. Handelt es sich bei den Daten um einen langen Textabsatz, erstellt der dynamische Graph in PyTorch eine längere Strecke, um die Daten durch das Modell zu leiten.
Der Vorteil eines dynamischen Ansatzes liegt in der Flexibilität bei jeder Iteration und dem einfacheren Debugging. Da PyTorch die Strecke Abschnitt für Abschnitt in Echtzeit aufbaut, kommt der Zug bei einem Fehler genau an dem Streckenabschnitt zum Stehen, der den Fehler verursacht hat.
Bei statischen Graphen treten Fehler erst auf, wenn man die gesamte Strecke angelegt hat, und es gibt keinen eindeutigen Hinweis darauf, was nicht funktioniert hat. Das kann verständlicherweise zu Frustration führen.
Was ist „autograd“?
„autograd“ ist die in PyTorch integrierte Engine, die Ableitungen und Gradientenberechnungen automatisch durchführt. PyTorch nutzt einen speziellen Ansatz, der als tapebasiertes (oder recorderbasiertes) System bezeichnet wird und dessen Funktionsweise der einer Audio- oder Videokassette ähnelt.
Wenn Sie während des Trainings Daten in ein PyTorch-Modell eingeben, aktiviert „autograd“ die Vorwärtsbewegung oder „Tonaufzeichnung“, um alle mathematischen Berechnungen und die Reihenfolge, in der sie stattfinden, zu erfassen und aufzuzeichnen. Es kann auch einen Rückwärtslauf oder ein „Zurückspulen“ ausführen. Durch die umgekehrte Ausführung mathematischer Operationen berechnet „autograd“, in welchem Umfang jeder Parameter zu einem Fehler beigetragen hat und wie er angepasst werden muss.
Wenn „autograd“ das Band „zurückspult“, verhält es sich wie ein Mathematiklehrer, der die ausführliche Arbeit eines Schülers benotet. Ausgehend vom falschen Ergebnis wird jeder Rechenschritt zurückverfolgt, um genau festzustellen, an welcher Stelle die Formel fehlerhaft war und wo beim nächsten Versuch Korrekturen vorgenommen werden müssen.
PyTorch und erklärbare KI
Eine korrekte Antwort von einem KI-Modell zu erhalten, ist nur die eine Seite der Medaille. Unternehmen müssen auch verstehen, warum ein Modell zu einer bestimmten Entscheidung gelangt. Durch die Priorisierung von Transparenz und Erklärbarkeit können Entwicklungsteams KI-Systeme entwickeln, die nicht nur technisch fortschrittlich, sondern auch sicher, fair und auf menschliche Werteund Bedürfnisse abgestimmt sind.
Zwar verfolgen grundlegende PyTorch-Features wie der dynamische Berechnungsgraph und „autograd“ den schrittweisen mathematischen Datenfluss, doch sind sie nicht darauf ausgelegt, für Menschen lesbar zu sein. Um diese Lücke zu schließen, verfügt PyTorch über Captum, eine dedizierte Library für erklärbare KI. Captum nutzt Daten aus „autograd“, um zu berechnen, welcher Input den größten mathematischen Einfluss auf die finale Ausgabe hatte, und hilft Entwicklungsteams so dabei, einen Blick in die Black Box von KI-Modellen zu werfen.
Diese Transparenz bietet beispielsweise folgende Vorteile:
Schnellere Fehlerbehebung: Wenn Data Scientists die Logik eines Modells nachvollziehen können, während dieses eine Ausgabe erzeugt, werden Entwicklung, Debugging und Entscheidungsfindung schneller und einfacher.
Bessere regulatorische Compliance: Erklärbare KI kann Unternehmen dabei unterstützen, gesetzliche Vorschriften und Datenschutzgesetze einzuhalten.
Mehr Vertrauen: Für die Implementierung von Technologien wie agentischer KI ist das Vertrauen der Menschen in Algorithmen erforderlich.
Ein Weg zu souveräner KI: Bei souveräner KI geht es um das Recht, die eigenen KI-Systeme zu kontrollieren. Dabei ist umfassende Transparenz dahingehend erforderlich, wie ein Modell Daten verarbeitet und Insights generiert.
Wie gelingt der Einstieg in PyTorch?
Sie können PyTorch sowohl auf lokalen Systemen als auch auf Cloud-Plattformen installieren und ausführen. Sie müssen lediglich zuerst Python installieren. Wenn Sie mit dem Programmieren in Python vertraut sind, dürfte Ihnen PyTorch selbst beim Einstieg sehr intuitiv erscheinen.
Sie können PyTorch auch über browserbasierte Cloud-Umgebungen wie Google Colab nutzen, in denen PyTorch- und GPU-Zugriff bereits vorinstalliert sind. Beim Einstieg werden Sie feststellen, dass das PyTorch-Ökosystem beliebte Tools wie die folgenden umfasst:
- Hugging Face: Hier können Entwicklungsteams vortrainierte PyTorch-Modelle herunterladen, anstatt sie von Grund auf neu zu erstellen.
- PyTorch Lightning: Ein leistungsstarker „Wrapper“ für PyTorch, der komplexen Engineering-Code verbirgt und so für ein übersichtlicheres Entwicklungserlebnis sorgt.
- ONNX: Open Neural Network Exchange (ONNX) wandelt PyTorch-Modelle in einen standardisierten Blueprint um, sodass sie auf verschiedenen Softwaresystemen oder Hardware-Chips gelesen und ausgeführt werden können, ohne dass Code neu geschrieben werden muss.
Docker-basierter Workflow mit PyTorch
Docker ist wie ein digitaler Frachtcontainer, der einen Snapshot einer Computerumgebung enthält. Ziel der Verwendung eines Docker-basierten Workflows mit PyTorch ist es, Code auf mehreren Rechnern gemeinsam zu nutzen und so Konfigurationsfehler und Systemabstürze zu vermeiden.
Wenn Sie Ihren PyTorch-Code in eine Docker-Image-Datei verschieben, können Sie alles, was zur Ausführung dieses Codes erforderlich ist, in einen Container packen, der vom Rest Ihres Rechners isoliert bleibt. Wenn Sie diesen Container an ein anderes Teammitglied oder an einen Cloud-Server senden, wird er heruntergeladen und mit allen erforderlichen Konfigurationen ausgeführt.
Die Autoren und Community-Mitglieder von PyTorch pflegen offizielle, vorgefertigte Docker-Images. Dadurch werden Entwicklung und Deployment vereinfacht, da Sie das PyTorch-Docker-Image herunterladen können, ohne PyTorch auf Ihrem Computer installieren zu müssen.
Kubernetes-basierter Workflow mit PyTorch
Wenn Sie bereit sind, Ihr PyTorch-Modell auf Millionen Nutzende zu skalieren, benötigen Sie eine Serverflotte zum Bewältigen der Workload. Sobald Sie Ihr PyTorch-Modell zusammen mit allen für die Ausführung erforderlichen Komponenten in ein Docker-Image containerisiert haben, sorgt Kubernetes dafür, dass der Container dorthin verschoben wird, wo er benötigt wird. Die Ausführung Ihrer KI-Workloads auf Kubernetes bietet folgende Vorteile:
Automatisierte Orchestrierung von Ressourcen: Für den Betrieb von PyTorch-Modellen sind zahlreiche Rechenressourcen erforderlich, darunter GPUs, CPUs, Arbeitsspeicher und Netzwerkbandbreite. Kubernetes sorgt dafür, dass PyTorch-Modelle kontinuierlich arbeiten, indem es die verfügbaren Ressourcen auf allen Servern überwacht und Workloads dort einplant, wo dies sinnvoll ist. Wenn ein Server ausfällt, kann Kubernetes den Fehler sofort erkennen und den Datenverkehr ohne menschliches Eingreifen umleiten.
Skalierbarkeit: KI-Workloads sind schwer vorhersehbar. Verzeichnet ein Modell plötzlich einen starken Anstieg des Datenverkehrs, kann Kubernetes vertikal skalieren, indem es Duplikate Ihres Docker-Containers auf mehreren Servern erstellt, um den Anstieg zu bewältigen. Bei geringem Datenverkehr skaliert Kubernetes die Ressourcen entsprechend, um Kosten zu sparen.
Support für verteiltes Training: Ist ein KI-Modell zu umfangreich, um auf einem einzelnen Computer trainiert zu werden, können Entwicklungsteams Container nutzen, um die Workload auf mehrere Rechner zu verteilen. Durch die Containerisierung des Modells in Docker-Container und den Einsatz einer Cloud-Architektur kann PyTorch die aufwendigen mathematischen Berechnungen auf einen Cluster miteinander verbundener GPUs verteilen.
Von dort aus übernimmt Kubernetes die Netzwerkkommunikation zwischen den Docker-Containern. So können diese miteinander kommunizieren, ihre Tensoren synchronisieren und als ein einziges, einheitliches „Gehirn“ Berechnungen durchführen. Diese parallele Verarbeitung verkürzt die Gesamtdauer des Trainings.
Wie Red Hat helfen kann
Red Hat® AI ist mit seinem vLLM-basierten Server für schnelle, flexible und effiziente Inferenz konzipiert. Die Lösung verknüpft die Modelle zuverlässig mit Ihren Daten, um die Anpassung und Entwicklung spezialisierter Agenten auf einer einzelnen Plattform zu vereinheitlichen. Unsere Produkte basieren auf Open Source und bieten Ihnen die vollständige End-to-End-Kontrolle über KI-Workflows in beliebigem Umfang.
Das Red Hat AI Portfolio beinhaltet jetzt Red Hat AI Enterprise: eine Plattform zum Bereitstellen, Verwalten und Skalieren von KI-Inferenz, agentischen KI-Workflows und KI-gestützten Anwendungen auf beliebigen Infrastrukturen.
Artificial Intelligence (AI)
See how our platforms free customers to run AI workloads and models anywhere
