
金曜日の夕方のことです。金融サービス会社の機械学習 (ML) エンジニアである Priya 氏は、1 時間あたり 55 ドルの GPU クラスタで不正検出のファインチューニングジョブをキューに入れます。実行には約 40 時間かかる見込みで、計算コストはおよそ2,200ドルになります。Priya 氏はハイパーパラメーターを再確認し、ジョブを送信して、週末のために帰宅します。
月曜日の朝、Priya 氏はノートパソコンを開きます。モデルの学習は金曜日の夜の時点で停止していましたが、ジョブは実行され続け、成果のないトレーニングに丸 2 日間の GPU 時間を費やしました。これにより 1,500 ドルを超えるコンピューティングリソースが無駄になり、Priya 氏は最初からやり直さなければなりません。
このような状況に心当たりがあるなら、お客様だけではありません。数日間にわたるトレーニングジョブを実行した経験のある実務者なら誰でも、次のような気まずい疑問を抱いたことがあるはずです。
- モデルは実際に何かを学習しているでしょうか。
- 早期に停止して、別のハイパーパラメーターを試すべきでしょうか。
- 火曜日のステークホルダーレビューまでに完了するでしょうか。
状況を把握できないことによるコストは、無視できない現実です。オンデマンドの GPU クラスタは、1 時間あたり 50 ドル以上のコストがかかる場合があります。1 回の数日間にわたるトレーニング実行で数千ドルに達することもあり、設定ミスがあれば、誰かが気付く前に週末のコンピューティングリソースをすべて無駄にしてしまう可能性があります。共有クラスタでは、その影響はさらに大きくなります。ジョブが停滞すると、1 つのチームの予算が無駄になるだけでなく、他のチームが必要な GPU にアクセスすることも妨げられます。あるチームの「手探りの実行」が、別のチームの「遅延」につながるのです。問題は、チームが不注意であるということではありません。状況を把握せずに実行していることが問題なのです。すべての GPU 時間が重要です。しかし、トレーニングの進捗状況をリアルタイムで把握できなければ、あまりにも多くの時間が無駄になってしまいます。
可観測性のギャップ
ここに、気まずい真実があります。プラットフォームの観点から見ると、順調に収束しているトレーニングジョブと、完全に停滞しているトレーニングジョブは、まったく同じように見えます。どちらも running 状態の Pod であり、同じリソースを消費し、同じ緑色のステータスインジケーターを表示します。Kubernetes には、モデルが学習しているかどうかを判断する概念がありません。
現在、トレーニングの進捗状況を監視することは可能ですが、必要以上に困難です。
- ログが分散しており使いにくい: 分散トレーニングジョブでは、ログは複数の Pod に分散されます。関連する出力を見つけるには、どの Pod を確認すべきか、どのようにアクセスするか、そしてフレームワーク固有のログ形式をどのように解釈するかを知る必要があります。これには Kubernetes の専門知識が必要ですが、ほとんどのデータサイエンティストや AI エンジニアにとって、トレーニングの実行を監視するためだけにそのようなスキルを習得する必要はないはずです。適切に構造化されていないログは機械で読み取りにくいため、自動化の原動力にはなり得ません。
- 外部ツールは可観測性を解決するが、管理オーバーヘッドが増大する:MLflow や Weights & Biases などの実験追跡プラットフォームは、その機能において非常に優れています。しかし、これらのツールを展開・維持するには追加のインフラストラクチャが必要であり、API キーやアクセス制御の管理も必要となる上、プラットフォーム層の上位で動作します。また、これらは Kubernetes API と連携していないため、カスタムの Kubernetes ネイティブなワークフローやカスタム Operator と統合することが困難です。これらのツールは、トレーニングループ内で何が起きたかを教えてくれますが、プラットフォームに対して何が起きているかを伝えることはできません。
- フレームワークごとに実装方法が異なる:PyTorch DDP、FSDP、DeepSpeed、JAX は、それぞれ独自のロギング規則、メトリクス形式、進捗報告方法を採用しています。フレームワーク間で一貫性がないため、多様なトレーニング環境を管理するプラットフォームチームにとって統一された全体像を把握することができません
- 標準 API が存在しない:これまで、トレーニングジョブが進捗状況をプラットフォームに報告するための標準化された方法はありませんでした。その結果、共有 GPU クラスタを管理するプラットフォーム管理者は、どのジョブが進行中で、どれが停滞しており、どれが終了間際なのかを推測するしかありません。このような可視性がなければ、キャパシティプランニングやトラブルシューティングは推測に頼ることになります。
ギャップの解消:Red Hat OpenShift AI における進捗状況の追跡
Red Hat OpenShift AI に、Kubeflow Trainer v2 に組み込まれた本番環境対応の分散トレーニングジョブ向け進捗状況追跡機能が追加されました。これは Red Hat OpenShift AI 3.4 から一般提供されます。実行中の状況をリアルタイムで確認し、手遅れになる前に対処できます。この機能は、データサイエンティスト、ML エンジニア、プラットフォーム管理者にトレーニングジョブのパフォーマンスをリアルタイムで可視化させることで、可観測性のギャップに直接対処します。
この可視性は 3 つの柱に基づいています。
- ダッシュボードによる可視化:リアルタイムの進捗メトリクスは、Red Hat OpenShift AI ダッシュボードで直接確認できます。進捗率、現在のステップと合計ステップ、現在のエポック、推定残り時間、トレーニング損失、TrainJobs の評価メトリクスを一目で確認できます。別のツールや追加のセットアップは不要です。
- SDK 統合: 同じ進捗データは、Kubeflow SDK を通じてプログラムによって利用可能です。これにより、チームはトレーニングの進捗に応じて、早期停止のトリガー、通知の送信、リアルタイムのメトリクスに基づくリソースの再割り当てを行う自動化パイプラインを構築できます。
- 複数フレームワーク間の一貫性:進捗状況の追跡は、PyTorch DDP、FSDP、DeepSpeed、JAX のいずれを使用する場合でも同じように機能します。また、CustomTrainer API を介してカスタムトレーニングコードもサポートします。これにより、フレームワーク間で統一されたエクスペリエンスが提供されます。
トレーニングの進行状況の確認
進捗追跡を理解する最良の方法は、実際に使用した際の感覚を順を追って確認することです。重要な 3 つのステップがあります。
- トレーニングジョブの開始: 現在と同様に、Kubeflow SDK を使用してノートブックからトレーニングジョブを送信します。HuggingFace Transformers を使用している場合、進捗状況の追跡は自動的に行われ、コードの変更は不要です。統合機能が Kubeflow 環境を検出し、トレーニングループからのメトリクス報告を開始します。
- 進捗状況の監視: トレーニングの実行中、進捗率、推定残り時間、完了したステップ、エポック、勾配ノルム、トレーニング損失、学習率などのリアルタイムのメトリクスが Red Hat OpenShift AI ダッシュボードに表示されます。ログの追跡や Pod への SSH 接続、外部ツールのセットアップは不要です。
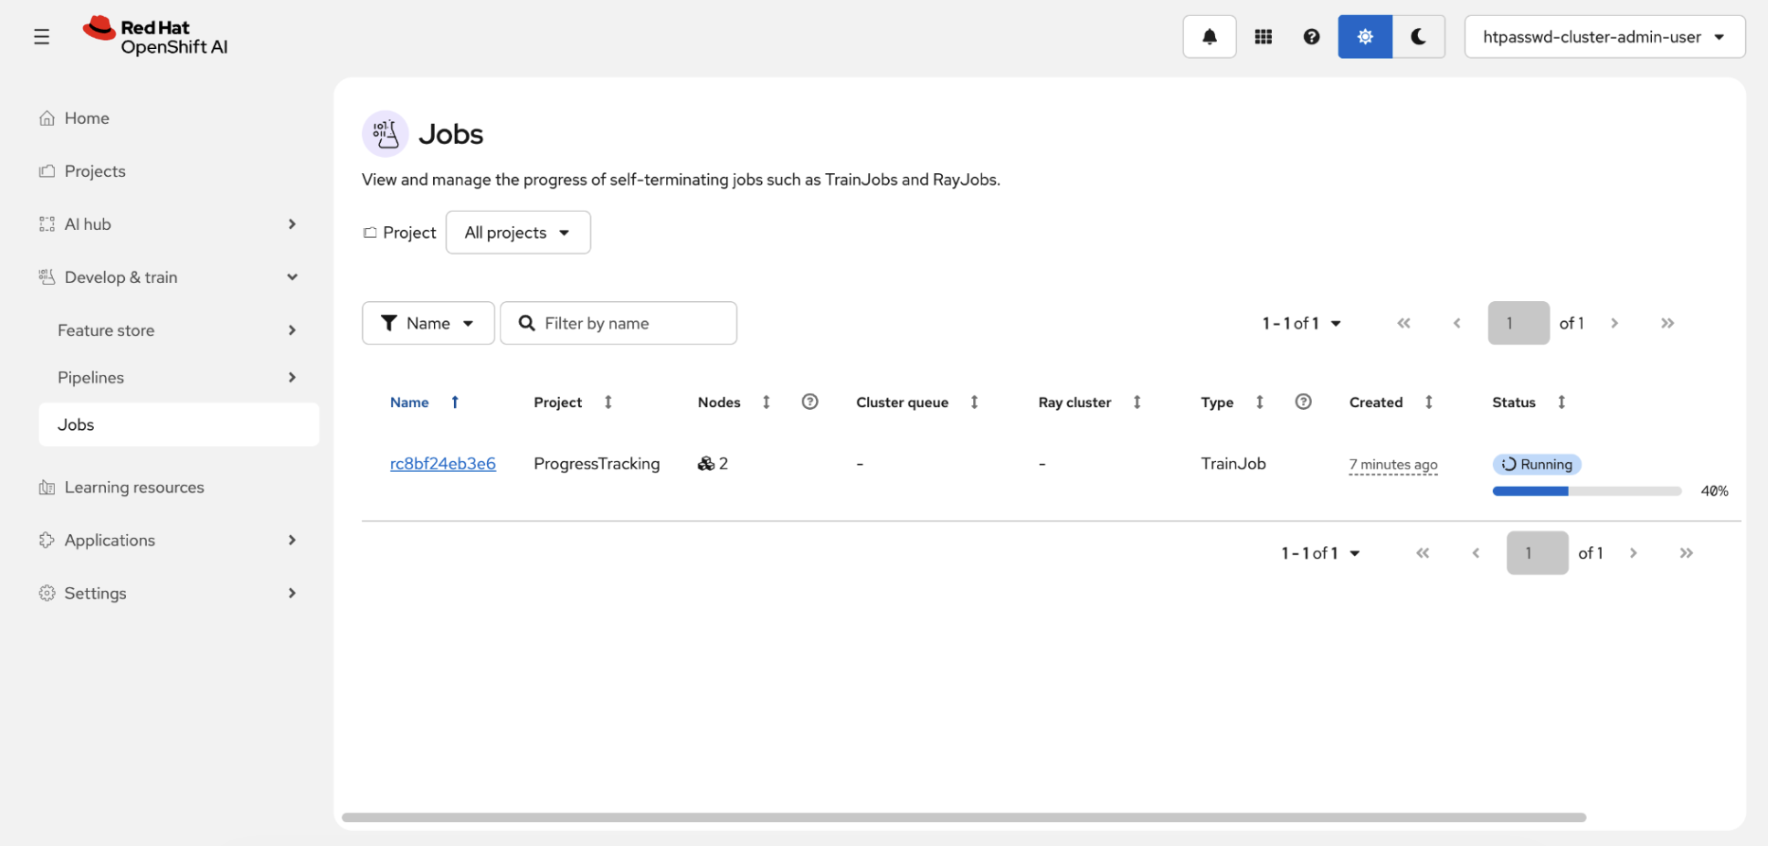
図 1:Red Hat OpenShift AI ダッシュボードにはジョブのリストが表示され、実行中の TrainJob の完了率が 40% であることを示す進捗バー付きのジョブ一覧が表示されます。
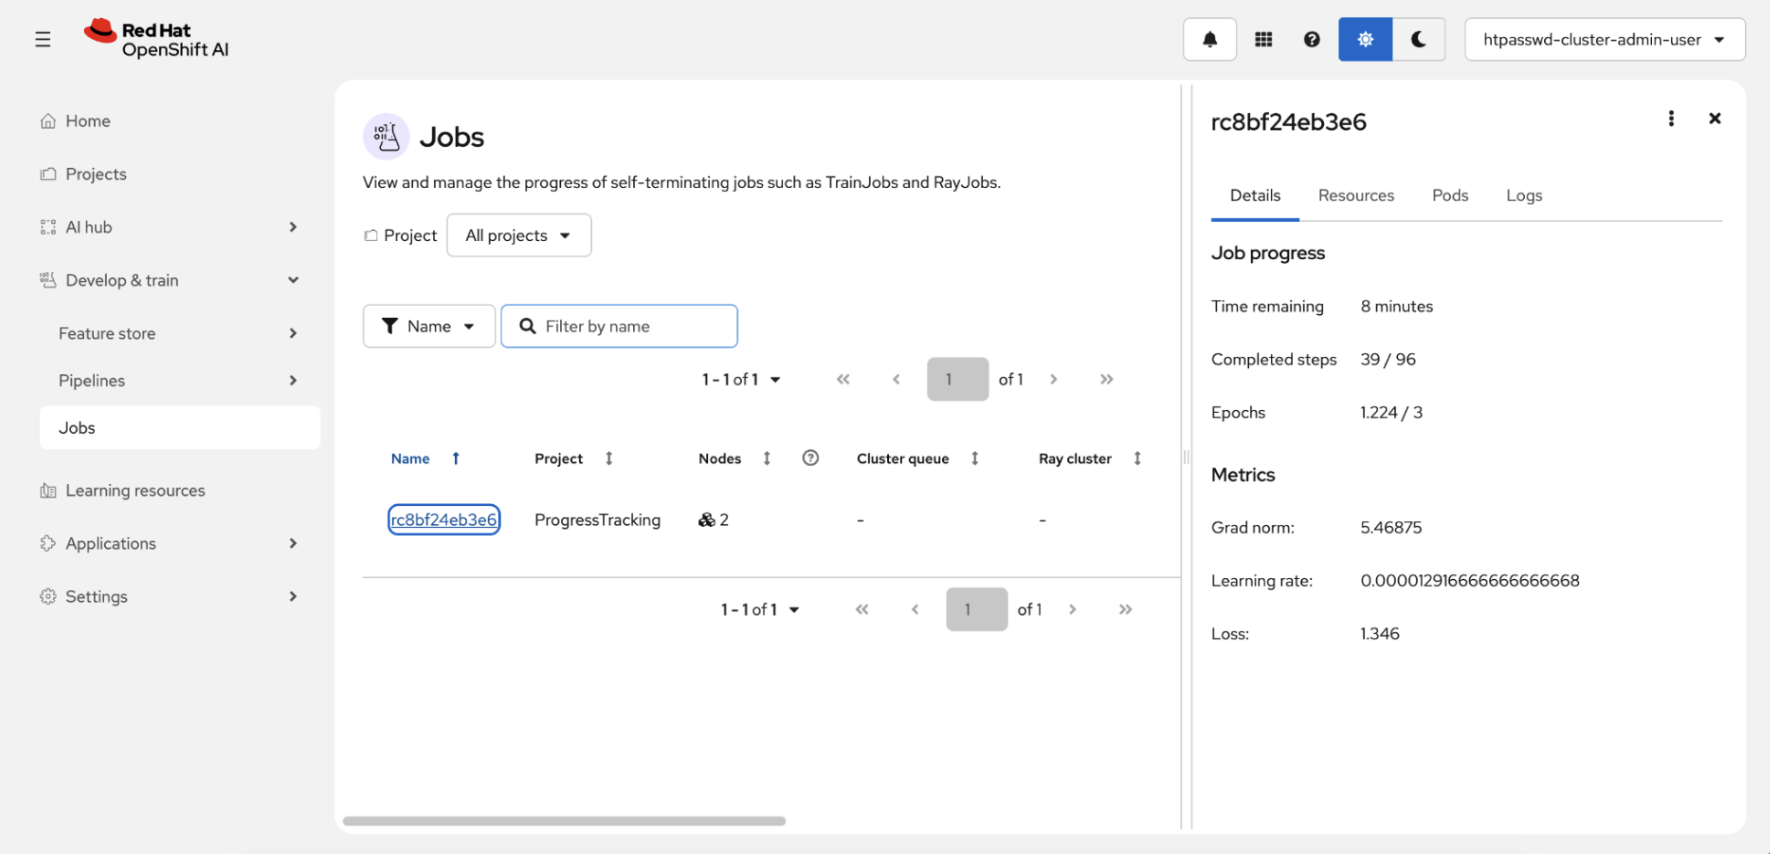
図 2: ジョブの進捗状況とリアルタイムのメトリクスを表示する詳細なサイドパネル。
- 確認した情報に基づいたアクション:進捗の追跡が、実際に時間とコンピューティング・リソースを節約してくれるのはここです。損失が改善されていないことに気付きましたか。ジョブを早期に停止し、数時間分の GPU 時間を節約しましょう。実行が予想よりも早く収束していますか。チームメイトのためにリソースを解放できます。ジョブがいつ終了するかを正確に把握できるため、計画を立てやすくなります。火曜日のステークホルダーレビューに結果が間に合うかどうかを推測する必要はもうありません。
実用化学に貢献する主な特徴は以下のとおりです。
- セットアップ不要:追加のインフラストラクチャ、外部依存関係、追加の構成は不要です。追加のインフラ、外部依存関係、余分な設定は一切不要です。進捗状況の追跡は、すぐに利用可能です。
- 最小限のオーバーヘッド:トレーニングのパフォーマンスに影響を与えることなく、自然なトレーニングチェックポイントでメトリクスが報告されます。
- フレームワークを問わず動作:PyTorch DDP、FSDP、DeepSpeed、JAX、またはカスタムトレーニングコードのいずれを使用していても、操作性は同じです。
対象となるユーザー
データサイエンティストや ML/AI エンジニアは、Pod への SSH 接続やログの追跡を行うことなく、トレーニング損失、進捗率、ETA をリアルタイムで確認できます。トレーニングの逸脱や停滞を早期に検出することで、たとえば、月曜ではなく土曜の朝にジョブの停滞に気づくだけで、GPU の無駄な稼働時間を数時間節約できます。ダッシュボードからトレーニングの実行状況を一目で比較し、どのハイパーパラメーター構成が最も優れたパフォーマンスを発揮しているかをすばやく特定できます。
プラットフォーム管理者は、クラスタ内のすべてのトレーニングジョブを 1 つのダッシュボードで一元的に把握できます。ジョブが DDP、FSDP、DeepSpeed のいずれを使用しているかに関わらず一貫したメトリクスを確認でき、どのジョブが進行中で、どれが停滞しており、どれが完了に近いかを把握することで、より適切なキャパシティプランニングの意思決定を行うことができます。
複数のチームが同じクラスタを共有するマルチテナント GPU 環境では、この可視性がリソース使用率と ROI の向上に直接つながります。 GPU-as-a-Service モデルを構築している組織にとって、進捗状況の追跡は重要なギャップを埋めるものです。これにより、「GPU 使用率のブラックボックス」が可観測で管理可能なシステムに変わります。最終的に、これによりプラットフォームチームはインフラストラクチャのボトルネックを排除し、AI イノベーションを加速するために必要なリソースをデータサイエンティストに自信を持って提供できるようになります。
監視を超えて:よりスマートなトレーニングのための基盤構築
進捗追跡は単なる監視機能ではなく、基盤そのものです。プラットフォームがリアルタイムのトレーニング進捗データにアクセスできるようになると、一連のよりスマートな動作が可能になります。これらの高度な機能は現時点では Red Hat 製品の正式な機能として約束されているわけではありませんが、その基盤はすでに整っています。アップストリームのKubeflow Trainerコミュニティでは、現在、いくつかの方向性について積極的に検討が進められています。
- よりスマートなハイパーパラメーターチューニング:現在、Katib などのハイパーパラメーター最適化エンジンは、トライアルのパフォーマンスを評価するために、不安定な正規表現パターンによるログ解析に依存しています。トレーニングメトリクスを Kubernetes API で直接利用できるようになれば、Katib はトレーニングステータスをネイティブに読み取ることができ、より緊密な統合と効率的なトライアルオーケストレーションが可能になります。これは、アップストリームコミュニティで議論されている KEP です。
- 弾力的なスケーリング:収束速度と ETA データは、スケールアップおよびスケールダウンの判断材料になります。迅速に収束するモデルは他のチームのために GPU を解放でき、停滞しているモデルは追加のワーカーをリクエストできるようになります。アップストリームコミュニティは、これを可能にするために TrainJob での PyTorch の弾力的なサポートを検討しています。
- CLI での進捗状況の可視化:
PROGRESS %列が組み込まれたkubectl get trainjobにより、トレーニングの進捗状況をコマンドラインで直接確認できるようになります。これにより、ダッシュボードや SDK を介さずに、オペレーターは即座に状況を把握できます。 - よりスマートなチェックポイント設定: OpenShift AI はすでに定期的およびジャストインタイムのモデルチェックポイント作成をサポートしていますが、ETA や進捗データが利用可能になれば、プラットフォームはチェックポイント作成のタイミングについてより賢明な判断を下せるようになります。たとえば、ジョブの ETA に基づいて状態を自動的に保存するなどです。アップストリームコミュニティは、TrainJob の耐障害性と回復力を強化するために、 CRIU を使用した透過的な GPU チェックポイント設定の機能を検討しています。
これらは Kubeflow プロジェクトで活発に検討されている領域であり、製品としての確約ではありませんが、進捗状況の追跡が単なる機能以上の意味を持つ理由を示しています。それは、トレーニングスタック全体が基盤として活用できるデータレイヤーを構築するからです。
分散トレーニングの進捗状況追跡は、Red Hat OpenShift AI 3.4 で一般提供されています。詳細については、 Red Hat OpenShift AI のドキュメントを参照してください。または、Red Hat OpenShift AI の 60 日間トライアルを開始して、ご自身で体験してください。
リソース
適応力のある企業:AI への対応力が破壊的革新への対応力となる理由
執筆者紹介
I am a Software Quality Engineer at Red Hat specializing in Kubeflow and distributed AI training. I am focused on making large-scale infrastructure efficient and resilient, and I share insights on distributed model training and fine-tuning on Kubernetes.
チャンネル別に見る

自動化
テクノロジー、チームおよび環境に関する IT 自動化の最新情報

AI (人工知能)
お客様が AI ワークロードをどこでも自由に実行することを可能にするプラットフォームについてのアップデート

オープン・ハイブリッドクラウド
ハイブリッドクラウドで柔軟に未来を築く方法をご確認ください。

セキュリティ
環境やテクノロジー全体に及ぶリスクを軽減する方法に関する最新情報

エッジコンピューティング
エッジでの運用を単純化するプラットフォームのアップデート

インフラストラクチャ
世界有数のエンタープライズ向け Linux プラットフォームの最新情報

アプリケーション
アプリケーションの最も困難な課題に対する Red Hat ソリューションの詳細

仮想化
オンプレミスまたは複数クラウドでのワークロードに対応するエンタープライズ仮想化の将来についてご覧ください
